#dusk $DUSK @Dusk
Je lisais les changements d’ingénierie récents de Dusk et je m’attendais à ce que la partie intéressante soit une autre amélioration du système de preuve.
Au lieu de ça, je suis constamment revenu à quelque chose de beaucoup moins spectaculaire : ce qui se passe avant même qu’une preuve ne soit traitée..
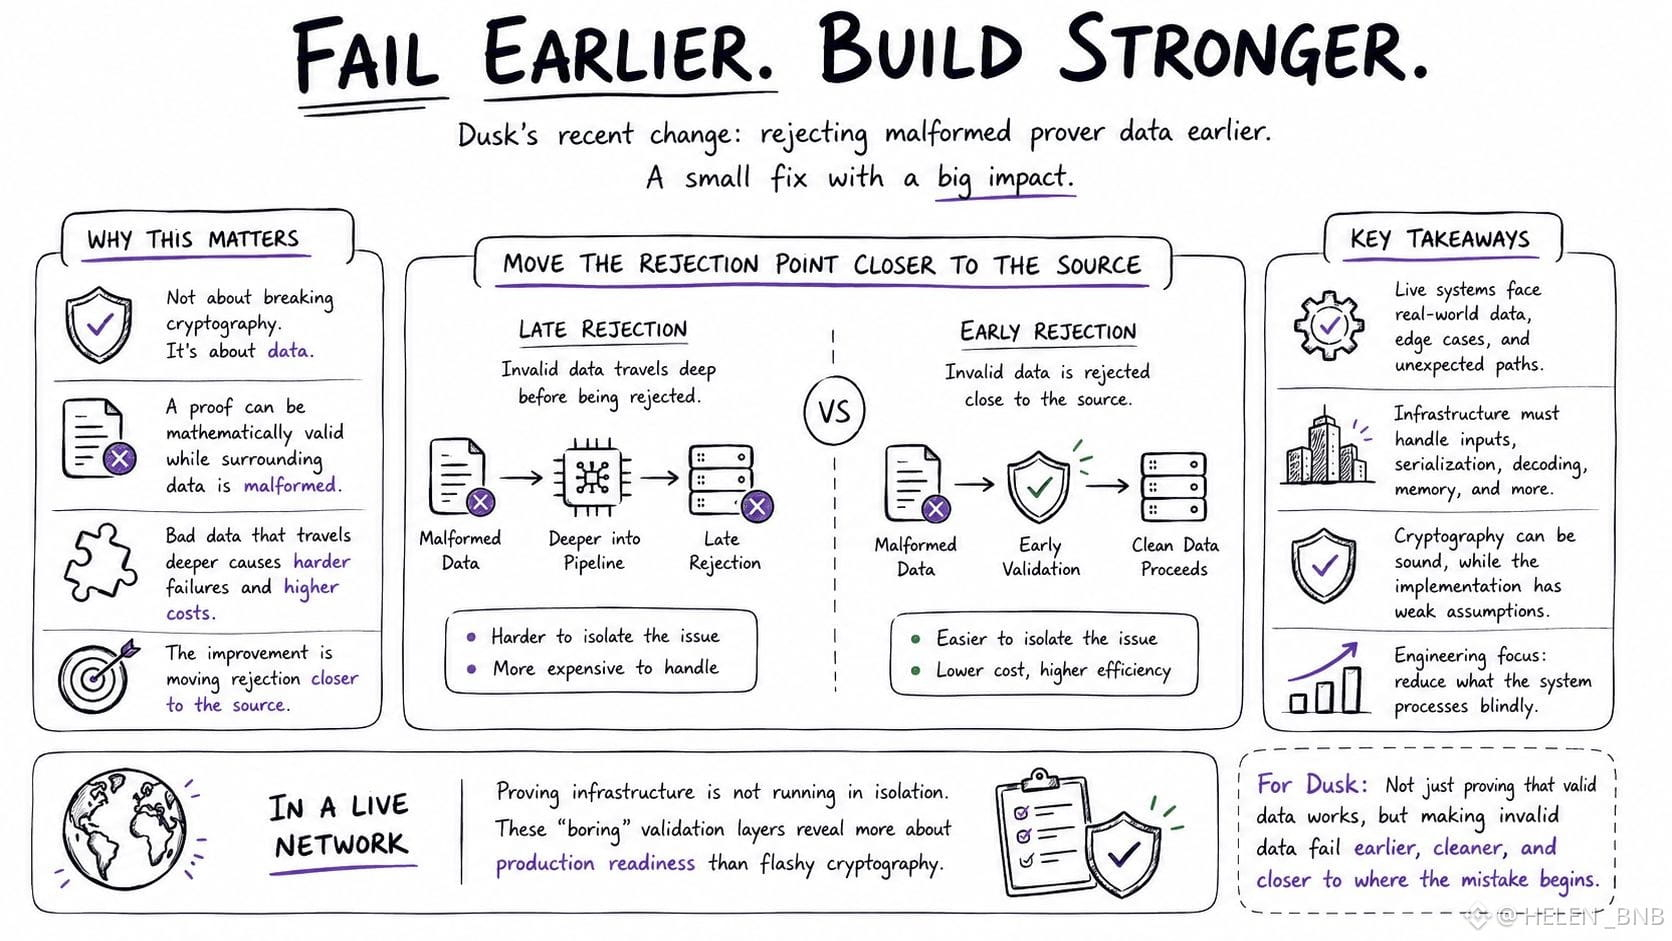
Un récent changement lié à Plonk s’est concentré sur le rejet de données de prouveur mal formées plus tôt. À première vue, cela ressemble à un simple nettoyage de routine.
Mais plus j’y pensais, plus cela devenait important.
Il y a une différence entre casser la cryptographie et injecter de mauvaises données dans une infrastructure cryptographique.
Une preuve peut être mathématiquement valide, tandis que les données qui l’entourent sont mal formées, incorrectement sérialisées ou structurées d’une manière que le système n’avait jamais prévue. Si ces entrées sont autorisées à aller plus loin dans le pipeline de preuve, la défaillance qui en résulte devient plus difficile à isoler et potentiellement plus coûteuse à gérer.
Ainsi, la vraie amélioration ne consiste pas nécessairement à renforcer les mathématiques.
Il s’agit de rapprocher le point de rejet de la source.
Cela compte sur le plan opérationnel.
Dans une infrastructure de preuve en réseau en conditions réelles, le système ne fonctionne pas en isolement. Il doit gérer la sérialisation, le décodage, la mémoire, les chemins d’exécution, ainsi que toutes les étranges situations limites qui apparaissent quand un logiciel rencontre des données du monde réel.
La cryptographie peut être solide, tandis que l’implémentation environnante conserve encore de faibles hypothèses.
C’est pourquoi je trouve que ces petits changements en disent plus que les annonces de fonctionnalités.
Ils montrent sur quoi l’équipe d’ingénierie consacre son temps : réduire le nombre de choses que le système accepte de traiter aveuglément.
Pour Dusk, je pense que c’est une direction importante : ne pas se contenter de prouver que des données valides fonctionnent, mais faire échouer des données invalides plus tôt, plus proprement, et plus près de l’endroit où l’erreur commence.
La couche de validation ennuyeuse finira peut-être par nous en apprendre davantage sur la capacité du système à être prêt pour la production que la cryptographie spectaculaire ne le fera jamais.
Je lisais les changements d’ingénierie récents de Dusk et je m’attendais à ce que la partie intéressante soit une autre amélioration du système de preuve.
Au lieu de ça, je suis constamment revenu à quelque chose de beaucoup moins spectaculaire : ce qui se passe avant même qu’une preuve ne soit traitée..
Un récent changement lié à Plonk s’est concentré sur le rejet de données de prouveur mal formées plus tôt. À première vue, cela ressemble à un simple nettoyage de routine.
Mais plus j’y pensais, plus cela devenait important.
Il y a une différence entre casser la cryptographie et injecter de mauvaises données dans une infrastructure cryptographique.
Une preuve peut être mathématiquement valide, tandis que les données qui l’entourent sont mal formées, incorrectement sérialisées ou structurées d’une manière que le système n’avait jamais prévue. Si ces entrées sont autorisées à aller plus loin dans le pipeline de preuve, la défaillance qui en résulte devient plus difficile à isoler et potentiellement plus coûteuse à gérer.
Ainsi, la vraie amélioration ne consiste pas nécessairement à renforcer les mathématiques.
Il s’agit de rapprocher le point de rejet de la source.
Cela compte sur le plan opérationnel.
Dans une infrastructure de preuve en réseau en conditions réelles, le système ne fonctionne pas en isolement. Il doit gérer la sérialisation, le décodage, la mémoire, les chemins d’exécution, ainsi que toutes les étranges situations limites qui apparaissent quand un logiciel rencontre des données du monde réel.
La cryptographie peut être solide, tandis que l’implémentation environnante conserve encore de faibles hypothèses.
C’est pourquoi je trouve que ces petits changements en disent plus que les annonces de fonctionnalités.
Ils montrent sur quoi l’équipe d’ingénierie consacre son temps : réduire le nombre de choses que le système accepte de traiter aveuglément.
Pour Dusk, je pense que c’est une direction importante : ne pas se contenter de prouver que des données valides fonctionnent, mais faire échouer des données invalides plus tôt, plus proprement, et plus près de l’endroit où l’erreur commence.
La couche de validation ennuyeuse finira peut-être par nous en apprendre davantage sur la capacité du système à être prêt pour la production que la cryptographie spectaculaire ne le fera jamais.