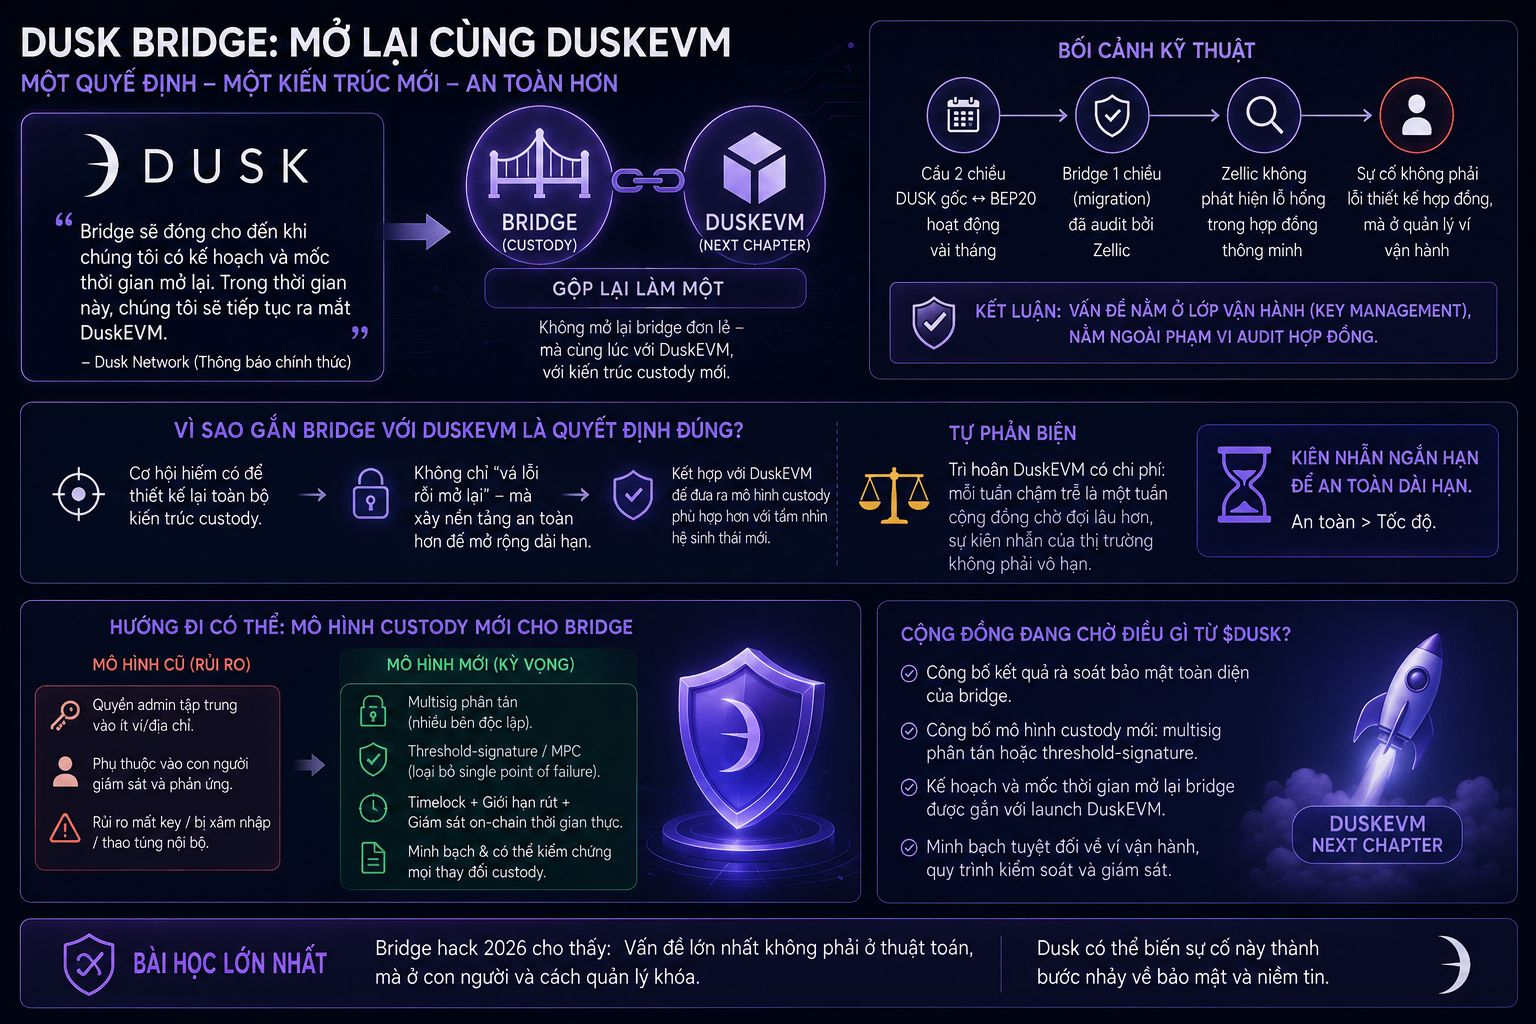
Je vois un détail notable dans la façon dont @Dusk relie la reprise du bridge avec DuskEVM elle-même : l’annonce officielle précise clairement que le bridge restera fermé jusqu’à ce qu’il y ait un plan et des jalons pour sa réouverture. Elle annonce également la poursuite du lancement de DuskEVM — ce qui signifie que ces deux éléments sont regroupés en une seule décision, sans séparation.
C’est ce qui m’a fait m’arrêter. Au départ, on pourrait penser que l’incident du bridge n’est qu’un problème d’exploitation isolé, qui nécessite simplement un correctif puis une réouverture comme auparavant. Mais le fait de le lier au lancement de DuskEVM suggère une autre possibilité : l’équipe pourrait profiter de cette situation pour repenser entièrement l’architecture de custody du bridge.
Si c’est le cas, cela correspond à une réponse beaucoup plus mûrie que de corriger le problème et de rouvrir au plus vite afin de réduire la pression de l’opinion publique. Le contexte technique est aussi frappant : le pont bidirectionnel entre le DUSK d’origine et le nouveau BEP20 a fonctionné pendant seulement quelques mois avant l’incident, et le bridge unidirectionnel pour la migration, qui a été audité par Zellic, n’a révélé aucune faille. Cela renforce l’idée que l’incident ne provient pas d’un défaut de conception du contrat, mais bien de la gestion des wallets d’exploitation — une couche située en dehors du périmètre des audits classiques de contrats intelligents.
Auto-réflexion : le report de DuskEVM pour approfondir la partie bridge a aussi un coût — chaque semaine de retard correspond à une semaine de plus d’attente pour la communauté concernant le jalon le plus important de la roadmap récente, et la patience du marché n’est pas illimitée.
J’attends de voir si $DUSK va publier un nouveau modèle de custody pour le bridge — peut-être un multisig plus distribué ou une signature à seuil — plutôt que de simplement rétablir la structure d’exploitation d’avant l’incident.
#dusk $BTC $ETH
C’est ce qui m’a fait m’arrêter. Au départ, on pourrait penser que l’incident du bridge n’est qu’un problème d’exploitation isolé, qui nécessite simplement un correctif puis une réouverture comme auparavant. Mais le fait de le lier au lancement de DuskEVM suggère une autre possibilité : l’équipe pourrait profiter de cette situation pour repenser entièrement l’architecture de custody du bridge.
Si c’est le cas, cela correspond à une réponse beaucoup plus mûrie que de corriger le problème et de rouvrir au plus vite afin de réduire la pression de l’opinion publique. Le contexte technique est aussi frappant : le pont bidirectionnel entre le DUSK d’origine et le nouveau BEP20 a fonctionné pendant seulement quelques mois avant l’incident, et le bridge unidirectionnel pour la migration, qui a été audité par Zellic, n’a révélé aucune faille. Cela renforce l’idée que l’incident ne provient pas d’un défaut de conception du contrat, mais bien de la gestion des wallets d’exploitation — une couche située en dehors du périmètre des audits classiques de contrats intelligents.
Auto-réflexion : le report de DuskEVM pour approfondir la partie bridge a aussi un coût — chaque semaine de retard correspond à une semaine de plus d’attente pour la communauté concernant le jalon le plus important de la roadmap récente, et la patience du marché n’est pas illimitée.
J’attends de voir si $DUSK va publier un nouveau modèle de custody pour le bridge — peut-être un multisig plus distribué ou une signature à seuil — plutôt que de simplement rétablir la structure d’exploitation d’avant l’incident.
#dusk $BTC $ETH