


Titre original : (DeepSeek s’associe à Unitree : quand l’intelligence devient assez bon marché pour être gaspillée)
Auteur original : Dongcha Beating
C’est souvent quand une technologie devient assez bon marché pour être gaspillée qu’elle commence vraiment à changer le monde.
Récemment, même des médias étrangers ont commencé à apprendre un terme bien chinois de l’Internet : « s’attaquer à la ligne de mort », zhan shao xian.
Le 31 juillet, DeepSeek V4 Flash a été mis à jour. Sur le graphique d’Artificial Analysis qui compare à la fois le niveau d’intelligence des modèles et le coût d’utilisation, l’axe vertical indique : plus on monte, plus le modèle est intelligent ; l’axe horizontal : plus on va à droite, plus le coût d’appel est élevé. L’indice d’intelligence de V4 Flash atteint 50 points : il est déjà collé au premier peloton mondial, mais le coût moyen lors d’une série de tests n’est que 3 cents. Ce point est presque projeté dans le coin supérieur gauche du repère. Les modèles moins chers sont le plus souvent moins performants ; les modèles plus intelligents coûtent en général beaucoup plus cher.
Aujourd’hui, si un modèle n’est pas assez plus fort que DeepSeek, il devient de plus en plus difficile d’expliquer pourquoi il devrait coûter plusieurs dizaines de fois plus cher. Sur l’Internet chinois, on appelle cette limite « la ligne de mort » (zhan shao xian). Quelques jours plus tard, Bloomberg a aussi discuté de la pression sur les prix exercée par les modèles chinois sur les entreprises d’IA américaines, et a même utilisé directement « Death Zone » dans le titre.
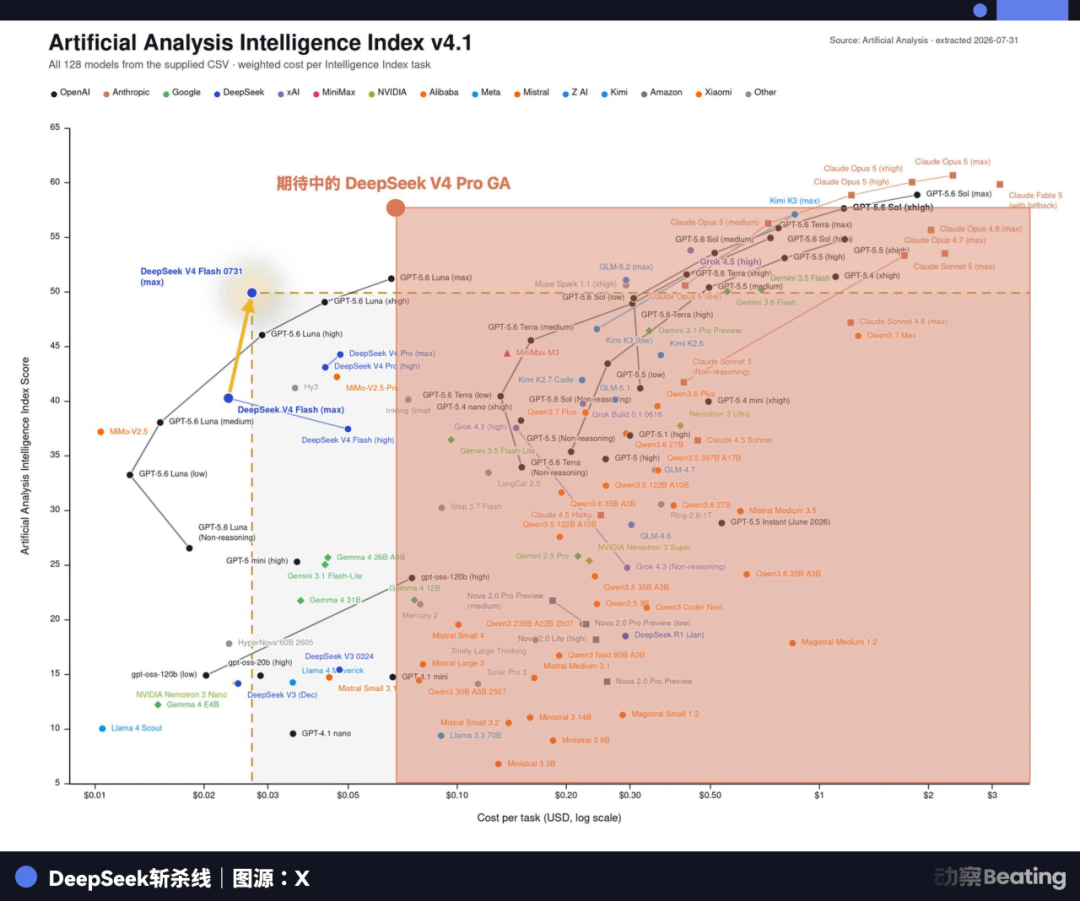
Depuis V2 en 2024, DeepSeek n’a cessé de faire baisser le coût pour « penser une fois » des robots. Les tâches que le modèle peut accomplir deviennent de plus en plus complexes, mais le prix n’a jamais suivi la hausse de capacité. Au cours des deux dernières années, l’industrie des grands modèles a pris l’habitude de parler de progrès en utilisant des paramètres plus grands, des contextes plus longs et des benchmarks plus élevés ; DeepSeek a, lui, continué de poursuivre un autre critère : la même intelligence, est-ce qu’on peut la faire en dépensant moins ?
De l’autre côté de Hangzhou, Wang Xingxing a fait depuis une dizaine d’années quelque chose de similaire.
Quand il était étudiant de troisième cycle, il faisait XDog, sans jamais avoir d’argent à brûler au départ. Les systèmes hydrauliques coûteux n’étaient pas accessibles : il a donc étudié des moteurs à bas coût ; les solutions mûres n’étaient pas achetables : il a alors dessiné ses propres cartes d’entraînement, écrit des programmes et monté un système de contrôle. Beaucoup de ces choix techniques, devenus aujourd’hui des standards produits chez Unitree, avaient à l’origine une habitude d’ingénierie très simple : d’abord ne pas demander comment l’industrie fait généralement, d’abord voir s’il existe une méthode plus économique.
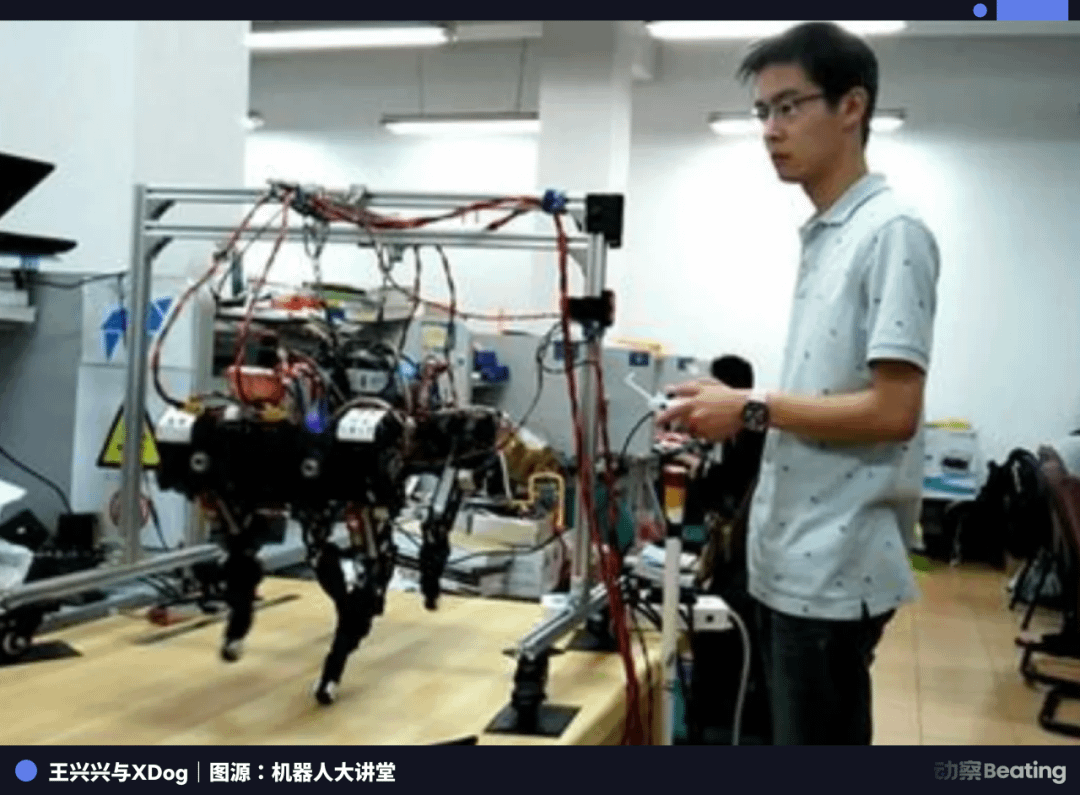
Wang Xingxing se rappelle ensuite : en 2010, quand il faisait des robots bipèdes, la partie mécanique ne coûtait que deux cents yuans au total. Des années plus tard, quelqu’un lui a demandé s’il était encore possible de continuer à réduire les coûts chez Unitree ; il a répondu : « Ne comparez pas avec nous pour réduire les coûts : nous pouvons en réduire encore beaucoup. »
Une entreprise fait baisser le prix de la réflexion ; une autre fait baisser le prix de l’action. Pendant longtemps, même s’ils étaient tous les deux à Hangzhou, ils suivaient chacun leur propre voie.
Jusqu’au 6 août.
La société Unitree dévoile les résultats de son allocation stratégique d’IPO sur le marché Kechuang. DeepSeek sort 1,408 milliard de yuans pour souscrire aux nouvelles actions d’Unitree. Les modalités de coopération divulguées sont elles aussi très directes : lorsque Unitree a besoin de services d’entraînement de modèles et de solutions techniques, elle donne la priorité à DeepSeek ; lorsque DeepSeek a besoin de robots et d’explorer des applications d’intelligence incarnée, elle donne la priorité à Unitree.
这笔钱放到今天的 AI 行业里并不算惊人。真正有意思的是,两个十几年来一直想把昂贵技术往白菜价上做的人,第一次把自己的成本曲线接到了一起。于是一个比「大模型终于给机器人接上身体」更值得追问的问题冒了出来:
Si le coût pour faire penser les machines et le coût pour les faire agir continuent de baisser, à quoi ressemblera l’IA au final ?
答案可能不只是「更多人用得起」。
Le changement le plus important, c’est que nous commençons à ne plus en être aussi avares.
Deux tueurs de prix
Ce qui rapproche le plus Liang Wenfeng et Wang Xingxing, c’est qu’ils ne croient pas vraiment à l’idée que le « pas cher » puisse être obtenu grâce aux subventions. Une grille de prix peut évidemment être changée en une nuit, mais la laine vient du mouton : ce genre de bas prix ne tient généralement pas longtemps. Si le produit veut vraiment être durablement vendu bon marché, il faut finalement revenir à l’ingénierie : démonter couche par couche les coûts qui existaient jusque-là presque comme une évidence.
DeepSeek-V2 est l’exemple le plus typique. Après la sortie du modèle en 2024, l’industrie domestique des modèles de grande taille a rapidement été entraînée dans une guerre des prix ; ce que le monde extérieur voit le plus facilement, ce sont les tarifs d’API, mais ce qui rend la baisse durable est caché dans la structure du modèle. V2 atteint 236 milliards de paramètres : pour traiter un token, seuls 21 milliards sont activés en pratique. Par rapport à la génération précédente, les coûts d’entraînement diminuent de 42,5 %, le KV Cache de 93,3 %, et le débit maximal de génération atteint 5,76 fois.
Avec V3, cette idée a continué d’être poussée plus loin. Le modèle devient plus grand : l’entraînement officiel consomme 2,788 millions d’heures de GPU H800, et DeepSeek optimise encore l’efficacité via un mélange d’experts, de l’entraînement en basse précision et des optimisations de communication.
Cette façon de voir les coûts a même fini par définir le produit à l’envers.
En mai de cette année, DeepSeek a transformé directement la remise promotionnelle de 75 % sur V4-Pro en un prix permanent, et la gamme phare continue d’être tirée vers le bas. Liang Wenfeng avait déjà expliqué leurs principes de tarification : prix fixés selon les coûts réels, sans continuer à subventionner à long terme, et sans rechercher une marge démesurée.
La compréhension de Wang Xingxing de la robotique est presque la même.
Lors d’une interview accordée en 2025 à (Late / Waidian), on lui a demandé : à l’époque, H1 se vendait 90 000 dollars ; ensuite, avec le G1 en version plus flexible et mieux équipée, le prix de départ ne restait plus qu’à 99 000 yuans. Est-ce que ça reste rentable ?
Wang Xingxing répond : « Toute activité commerciale doit forcément dégager un bénéfice commercial raisonnable. Nos coûts sont depuis toujours un KPI pour tout ce qu’on fait : l’essentiel, c’est de gagner de l’argent. »
Il a ensuite parlé de très peu de choses sur la phrase la plus courante, « quand on atteint une certaine échelle, les fournisseurs baissent naturellement les prix ». Ce qui détermine vraiment le seuil inférieur du prix d’un robot, ce sont : comment choisir le moteur, comment fabriquer le réducteur ; combien de pièces une articulation doit utiliser ; et si l’ensemble peut encore être rendu plus léger ; et quels composants doivent absolument rester sous notre contrôle.
Cette manière de réduire les coûts a une forte sensation d’époque industrielle : un sou est partagé en deux moitiés.
Quelques centimètres de moins sur une carte électronique, deux pièces de moins sur une articulation, un faisceau de câbles pour une autre manière de le faire passer : pris seuls, ces changements ne sont rien de vraiment spectaculaire. Mais en les empilant, au final, ils influencent directement le prix de vente.
宇树过去几年的价格变化正是如此。2023 年,第一代全尺寸人形机器人 H1 上市,当年只卖出 5 台,平均售价 59.34 万元;2024 年,更小的 G1 进入市场,销量提高到 410 台,平均售价降到 26.07 万元;到 2025 年前九个月,人形机器人销量达到 3551 台,平均售价又降到 16.76 万元。
À chaque baisse d’un cran du prix, les acheteurs de robots accueilleront aussi une nouvelle vague. Pour des équipements à 500 000 ou 600 000 yuans, il faut monter des projets au niveau des laboratoires, établir des budgets, expliquer ce qu’on compte étudier en les achetant ; à 100 000 ou 200 000 yuans, cela peut déjà entrer dans davantage d’universités, de équipes de développement et d’entreprises.
Beaucoup de technologies franchissent vraiment le seuil de vulgarisation grâce à ce type de changement. D’un budget spécial, on passe à un budget de département ; d’un budget de département à un achat ordinaire ; puis un jour, les gens seront trop paresseux pour recompter à chaque utilisation.
Les technologies coûteuses sont naturellement faites pour résoudre des problèmes coûteux ; quand les prix baissent, les petites choses qui n’avaient jamais mérité qu’on y fasse intervenir la technologie commencent à entrer dans leur monde.
Deux courbes de coûts finissent par se croiser
Unitree travaille déjà sur des modèles du monde et des VLA ; donc la valeur de DeepSeek ne se limite pas à « connecter un cerveau » au robot. Ce qui peut réellement faire s’emboîter les deux sociétés, c’est le cycle d’entraînement actuellement le plus coûteux de l’intelligence incarnée.
Une partie de ce cycle se produit dans le monde réel. Quand le robot tend la main, marche et saisit, les humains (ou d’autres systèmes) lui montrent en continu, générant des trajectoires de réussite et d’échec.
L’autre moitié se passe dans le calcul : les données sont nettoyées, annotées, injectées dans un nouvel cycle d’entraînement avec une nouvelle stratégie ; puis, après inférence et validation, elles sont redéployées sur le robot. Le robot repart tester, ramène de nouvelles données, le modèle réapprend. Plus cette boucle tourne vite, plus le robot rencontre le monde.
Le problème, c’est qu’elle est chère aux deux extrémités. Le matériel coûte cher : il est alors difficile d’amener plusieurs centaines de robots à passer toute la journée à se planter dans le laboratoire ; l’entraînement et l’inférence coûtent cher aussi : ces données qu’on collecte et qu’on ne voit pas tout de suite de la valeur sont difficiles à réentraîner et valider de manière répétée.
Du coup, les expériences de robotique coûtaient autrefois très cher. Il n’y avait que quelques machines : il fallait penser à l’avance aux données à collecter ; la puissance de calcul était limitée : se demander si un lot de trajectoires devait être relancé, et compter sur ses doigts. Plus les ressources sont chères, plus les chercheurs sont enclins à choisir les problèmes qui semblent les plus précieux et avec la plus forte probabilité de succès.
Mais la réalité n’est justement pas comme ça.
Quelle différence y a-t-il à placer une tasse à 3 centimètres du bord de la table ou à 5 centimètres ? Où faut-il attraper une serviette une fois qu’elle est à moitié humide ? Quand un tiroir bloque, faut-il pousser davantage ou reculer un peu d’abord ? Comment ajuster le bras quand on met une pomme et trois pommes dans un sac plastique ? Pris séparément, aucun de ces faits ne mérite une conférence de lancement ; même pour un laboratoire, il est difficile de justifier un projet dédié. Mais dès que le robot entre dans la maison, le restaurant, l’entrepôt ou le bureau, c’est précisément ce type de questions futiles et irritantes qui compose le monde auquel il fait face chaque jour.
À ce moment-là, en regardant la coopération entre DeepSeek et Unitree, la logique devient beaucoup plus claire.
Unitree rabaisse la moitié amont des coûts, pour que davantage de vraies machines entrent dans les laboratoires, dans les équipes de développement et dans des scénarios réels. DeepSeek, de son côté, résout sur le long terme la seconde moitié : rendre l’entraînement, l’inférence et la validation toujours plus économiques.
La plupart des trajectoires ne finissent pas en produit, la plupart des expériences ne donnent pas lieu à une annonce ; certains robots attrapent cent fois de suite le mauvais gobelet, et un lot de données coûteuses une fois écoulé ne prouve parfois même qu’une chose : que l’idée de départ ne tenait pas debout.
Quand les ressources sont chères, ces actions servent à « jeter l’argent à l’eau » ; quand les coûts sont suffisamment bas, elles ont enfin le droit d’être appelées « expérience ».
Un téléphone un peu moins cher signifie acheter pour davantage de gens ; un robot un peu moins cher signifie aussi qu’il peut posséder davantage de temps sans production : s’entraîner dans un labo une après-midi, faire quelques actions finalement inutiles, entrer dans des environnements plus étranges, rencontrer davantage de situations que les ingénieurs n’avaient pas envisagées à l’avance.
Quand le corps et l’intelligence deviennent tous deux plus abordables, la première chose que l’intelligence incarnée gagne, ce sont davantage de droits de se tromper.
Comment l’humanité a-t-elle appris à gaspiller la technologie ?
Ces choses ont déjà eu lieu de nombreuses fois dans l’histoire technologique de l’humanité.
En 1865, l’économiste britannique William Stanley Jevons, en étudiant la machine à vapeur et le charbon, a découvert une chose contre-intuitive : la machine à vapeur gagne en efficacité ; pour accomplir une tâche, on brûle de moins en moins de charbon, mais en Grande-Bretagne la consommation de charbon ne baisse pas, elle augmente au contraire. Parce que dès que la puissance à vapeur devient bon marché, des choses qu’on n’osait pas faire auparavant commencent à être faites ; et le charbon économisé en efficacité est rapidement mangé par de nouvelles demandes encore plus nombreuses.
On a ensuite appelé ce phénomène « paradoxe de Jevons ».
Les gens qui utilisent l’IA depuis les deux dernières années ont déjà, en réalité, fait l’expérience de l’étape inverse. Quand les modèles étaient encore chers, on a d’abord appris à économiser de l’intelligence. Les équipes de startup parlaient d’expérience utilisateur en surface, mais les chefs produit devaient encore garder en tête une grille des prix des tokens : une fonctionnalité peut être faisable techniquement, et pourtant elle est peut-être finalement supprimée parce que « faire tourner le modèle cinq fois de plus par utilisateur, ça coûte trop cher ».
Mais pour que la technologie entre réellement dans la vie, il faut encore franchir un autre cap : quand elle devient assez bon marché pour que nous commencions à l’utiliser pour faire des choses qui ne sont pas si importantes.
Aujourd’hui, personne ne calcule avant d’allumer la lumière du salon quelle valeur économique crée cette heure d’éclairage ; personne ne juge en « gaspillant » les grandes infrastructures d’Internet mondial juste parce que le téléphone envoie quelques requêtes réseau de plus en arrière-plan.
L’électricité et le réseau ont un coût ; simplement, ce coût est devenu si bas qu’il ne vaut même plus la peine de décider à chaque utilisation. Les humains sont devenus très larges sur ce genre de choses, sans aucun scrupule.
Quand un jour l’intelligence arrivera ici, notre relation à l’IA changera elle aussi. Après une réunion, on demande au modèle de ranger un peu ; après avoir fini un article, plusieurs modèles se relaient pour trouver des défauts ; quand un agent échoue, on change quelques trajectoires et on continue d’essayer : avec ou sans fard, on fait trois essais tout de suite. Le robot range la table : la première fois, il renverse une tasse ; la deuxième, sa main part de travers ; la troisième, son mouvement est trop lent : alors on recommence une quatrième fois.
Après qu’une technologie soit vraiment devenue populaire, les gens ne vont pas de plus en plus sérieusement calculer son efficacité d’usage ; et l’être humain finira même par oublier qu’il l’utilise.
Quand nous ne compterons plus cette addition
En 1911, le mathématicien et philosophe britannique Alfred North Whitehead a écrit dans (Introduction aux mathématiques) :
« Le progrès de la civilisation consiste à élargir constamment le champ des opérations importantes que nous pouvons accomplir sans avoir à réfléchir. »
Aujourd’hui, l’IA n’est évidemment pas encore arrivée jusque-là. Nous discutons toujours de quelle tâche mérite d’utiliser le modèle le plus cher ; les développeurs échangent encore quelques yuans par million de tokens pour changer de fournisseur ; les entreprises de robots doivent encore trouver, entre l’exposition, le laboratoire et l’usine, le scénario le plus facile à faire passer au service de comptabilité. Cette industrie a encore un fort goût de vie quotidienne : sel, riz, huile et vinaigre.
Et ce montant de 1,408 milliard de yuans, c’est vraiment ce qui relie les points : c’est une facture qui apparaît rarement dans les discussions de l’industrie. Combien coûte une erreur commise par une machine, au juste ?
Aujourd’hui, cette réponse n’est pas encore assez bon marché : il faut encore collecter sérieusement chaque donnée réelle du monde, trier à chaque entraînement, et idéalement faire en sorte que chaque robot trouve au plus vite un emploi qui permet de produire.
Quand l’intelligence sera vraiment devenue populaire, il n’y aura peut-être pas de conférence pour annoncer l’arrivée d’une nouvelle ère. On ne fera que constater progressivement qu’un robot qui s’entraîne l’après-midi dans un coin d’un entrepôt à attraper des cartons, cent fois raté, n’intéresse déjà plus personne ; qu’un agent qui tente une trentaine de trajectoires pour trouver une réponse ne fait plus frémir qui que ce soit en voyant le ticket de tokens ; et qu’ajouter quelques robots dans le laboratoire ne demande plus d’écrire une raison d’achat pour chaque machine.
Ainsi, le vrai prix important pour l’avenir de l’IA n’est peut-être ni combien vaut exactement un million de tokens, ni combien coûte exactement un robot humanoïde, mais plutôt à partir de quel moment nous aurons enfin la flemme de recompter ces chiffres.
Quand la machine pense plusieurs fois, fait quelques pas de plus, commet plusieurs erreurs — et que tout cela ne vaut plus la peine de faire mal au cœur — alors l’intelligence passe vraiment d’une capacité coûteuse à une infrastructure.
C’est souvent quand une technologie commence vraiment à changer le monde qu’elle devient assez bon marché pour être gaspillée.
DeepSeek fait approcher la réflexion de ce prix ; Unitree fait approcher le corps de ce prix. Le reste consiste à offrir aux machines une vie suffisamment bon marché.
Assez bon marché pour retenter à l’infini, assez bon marché pour se tromper sans cesse ; à tel point que les échecs qui paraissent aujourd’hui sans intérêt deviennent enfin assez nombreux pour constituer de l’intelligence.
Lien original