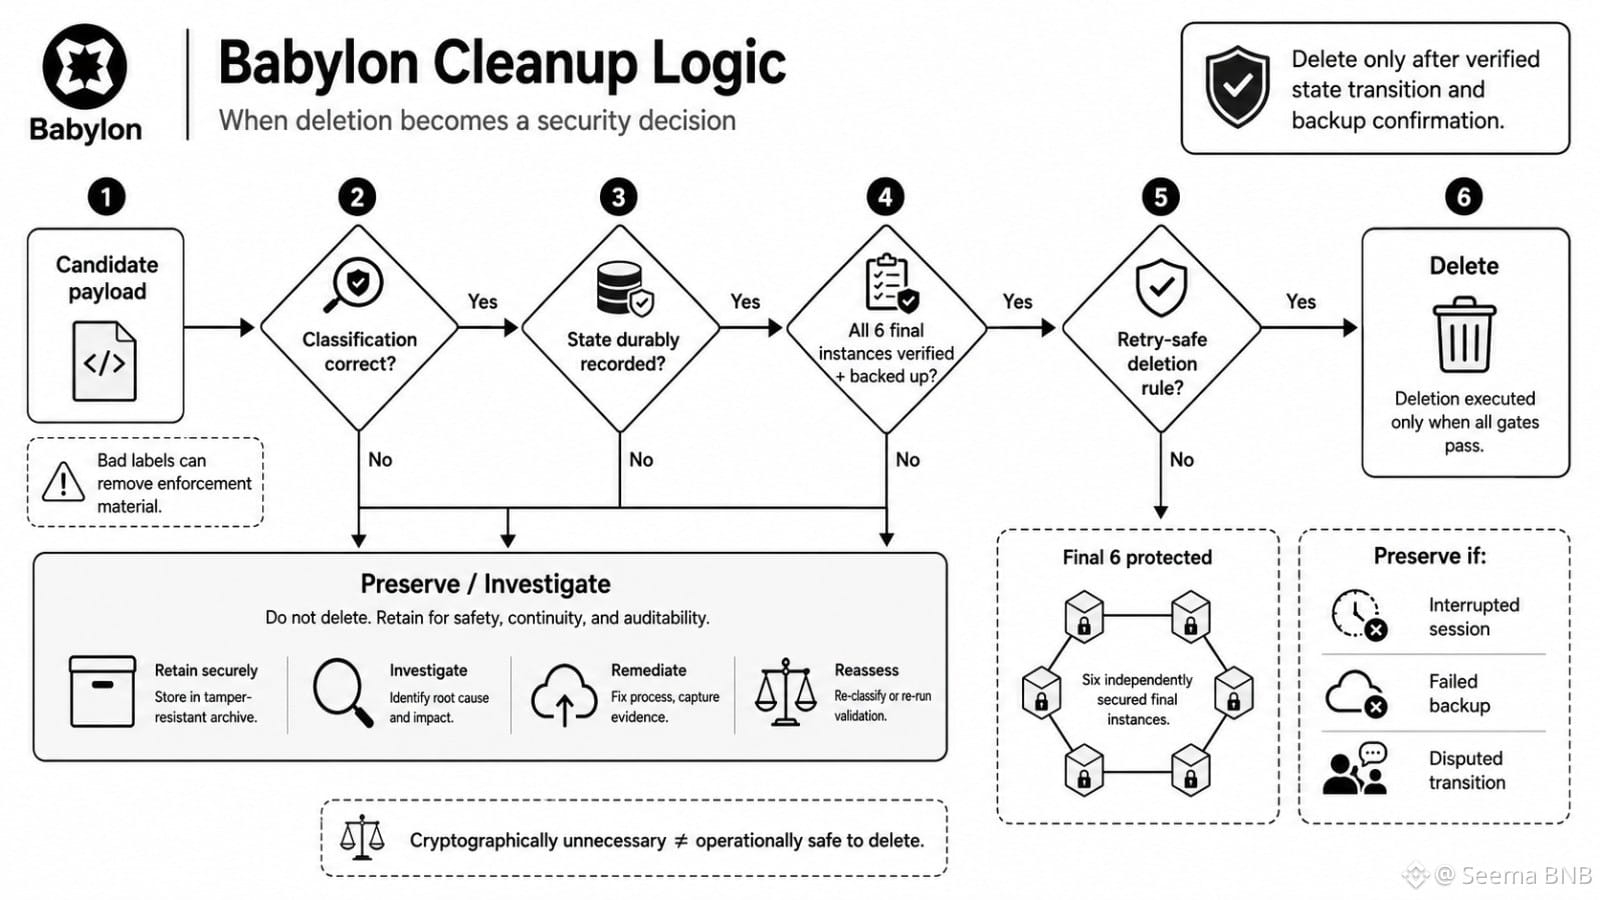
J’ai évalué d’abord la logique de nettoyage de Babylon à partir des six derniers objets. Cela semblait efficace. Puis j’ai remarqué que la suppression elle-même pouvait faire partie du modèle de sécurité.@BabylonLabs_io
Le point évident, c’est la réduction du stockage. Ce n’est pas le vrai problème.
Le comportement caché, c’est la classification. Une charge utile candidate peut être cryptographiquement inutile, tout en restant opérationnellement importante pendant une session interrompue de cut-and-choose, un backup échoué ou une transition d’état contestée. La supprimer trop tôt, et le système peut perdre des éléments nécessaires pour expliquer ce qui s’est passé.
Un certain risque de nettoyage est normal. Aucun protocole ne peut préserver indéfiniment tous les objets temporaires.
Mais le vrai test de BABY, c’est la discipline de cycle de vie vs la commodité de l’opérateur. Babylon supprime-t-il uniquement après que le changement d’état est consigné de manière durable ? Un manifeste prouve-t-il que les six instances finales vérifient correctement et disposent de sauvegardes indépendantes ? La tâche de suppression peut-elle être relancée sans toucher à l’une de ces six-là ?
L’automatisation aide, oui. Mais seulement lorsque les règles sont idempotentes et que la condition de suppression est explicite.
Je surveille encore l’arête inconfortable : que se passe-t-il quand les opérateurs pensent que la configuration est terminée, tandis que l’analyse d’échec dit que non ?
Pour BABY, la collecte des déchets n’est plus de la simple maintenance. C’est une décision de sécurité différée, et une mauvaise étiquette peut faire disparaître plus que des données.
#baby $BABY
Le point évident, c’est la réduction du stockage. Ce n’est pas le vrai problème.
Le comportement caché, c’est la classification. Une charge utile candidate peut être cryptographiquement inutile, tout en restant opérationnellement importante pendant une session interrompue de cut-and-choose, un backup échoué ou une transition d’état contestée. La supprimer trop tôt, et le système peut perdre des éléments nécessaires pour expliquer ce qui s’est passé.
Un certain risque de nettoyage est normal. Aucun protocole ne peut préserver indéfiniment tous les objets temporaires.
Mais le vrai test de BABY, c’est la discipline de cycle de vie vs la commodité de l’opérateur. Babylon supprime-t-il uniquement après que le changement d’état est consigné de manière durable ? Un manifeste prouve-t-il que les six instances finales vérifient correctement et disposent de sauvegardes indépendantes ? La tâche de suppression peut-elle être relancée sans toucher à l’une de ces six-là ?
L’automatisation aide, oui. Mais seulement lorsque les règles sont idempotentes et que la condition de suppression est explicite.
Je surveille encore l’arête inconfortable : que se passe-t-il quand les opérateurs pensent que la configuration est terminée, tandis que l’analyse d’échec dit que non ?
Pour BABY, la collecte des déchets n’est plus de la simple maintenance. C’est une décision de sécurité différée, et une mauvaise étiquette peut faire disparaître plus que des données.
#baby $BABY