J’ai jugé la conception de l’archive de Babylon différemment une fois que j’ai chronométré le processus de revue au lieu de me contenter de compter les copies.@BabylonLabs_io
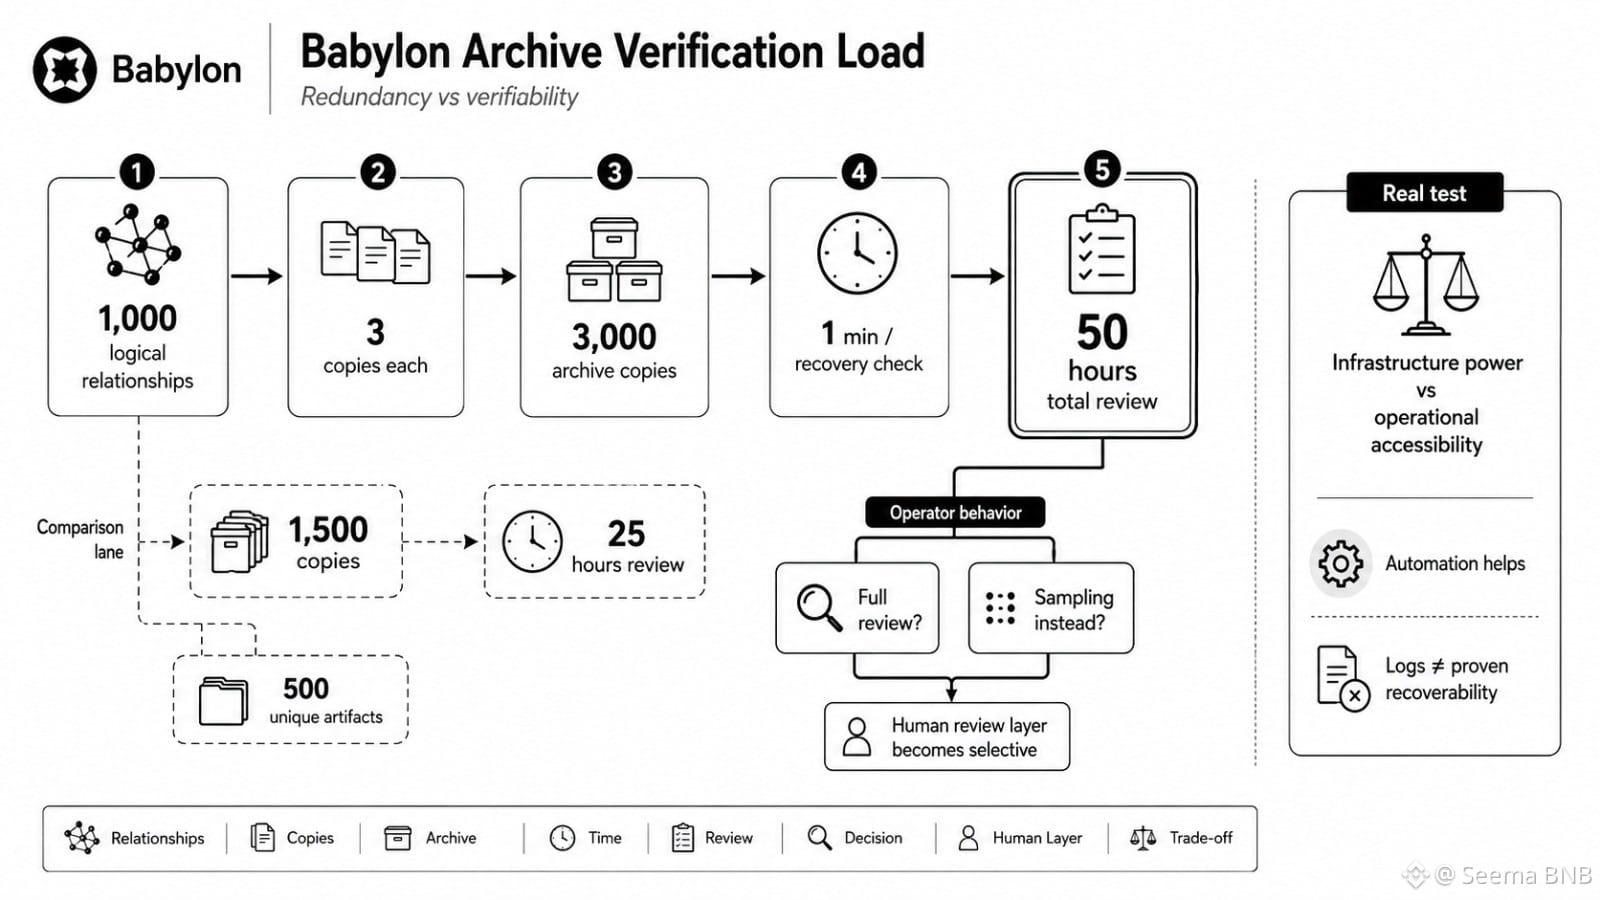
La mesure évidente est 3 000 sauvegardes. Cela paraît robuste. Mais une minute par contrôle de restauration transforme cette archive en 50 heures de vérification continue. Même 1 500 copies exigent encore 25 heures, soit plus de trois équipes de huit heures.
Cela modifie le comportement des opérateurs.
Les équipes inspectent-elles chaque copie, ou n’en contrôlent-elles que quelques-unes en supposant que le reste est sain ? Qui vérifie les copies finales après la fatigue, des interruptions, ou un contrôle ayant échoué à mi-parcours ? BABY peut hériter, sur le papier, d’une redondance solide tandis que la couche de revue humaine devient sélective.
Une duplication partielle est raisonnable. Trois copies peuvent protéger contre des pertes locales, des supports endommagés et des restaurations ayant échoué.
Le vrai test oppose la puissance de l’infrastructure à l’accessibilité opérationnelle. Si 3 000 copies ne représentent que 1 000 relations logiques, Babylon a triplé la charge de vérification, passant de 16 heures 40 minutes à 50 heures, sans tripler l’information unique.
Peut-être que l’automatisation comble cet écart. Pourtant, des journaux automatisés ne sont pas la même chose qu’une récupérabilité prouvée.
Je surveille si Babylon peut réduire le travail de vérification, pas seulement le risque de stockage. Une archive n’est robuste que lorsque les opérateurs peuvent la prouver à répétition, et non lorsqu’ils se contentent d’en posséder davantage.
#baby $BABY
La mesure évidente est 3 000 sauvegardes. Cela paraît robuste. Mais une minute par contrôle de restauration transforme cette archive en 50 heures de vérification continue. Même 1 500 copies exigent encore 25 heures, soit plus de trois équipes de huit heures.
Cela modifie le comportement des opérateurs.
Les équipes inspectent-elles chaque copie, ou n’en contrôlent-elles que quelques-unes en supposant que le reste est sain ? Qui vérifie les copies finales après la fatigue, des interruptions, ou un contrôle ayant échoué à mi-parcours ? BABY peut hériter, sur le papier, d’une redondance solide tandis que la couche de revue humaine devient sélective.
Une duplication partielle est raisonnable. Trois copies peuvent protéger contre des pertes locales, des supports endommagés et des restaurations ayant échoué.
Le vrai test oppose la puissance de l’infrastructure à l’accessibilité opérationnelle. Si 3 000 copies ne représentent que 1 000 relations logiques, Babylon a triplé la charge de vérification, passant de 16 heures 40 minutes à 50 heures, sans tripler l’information unique.
Peut-être que l’automatisation comble cet écart. Pourtant, des journaux automatisés ne sont pas la même chose qu’une récupérabilité prouvée.
Je surveille si Babylon peut réduire le travail de vérification, pas seulement le risque de stockage. Une archive n’est robuste que lorsque les opérateurs peuvent la prouver à répétition, et non lorsqu’ils se contentent d’en posséder davantage.
#baby $BABY