
Dans le passé, quand on parlait de Marvell, la première réaction était : ASIC pour l’IA, interconnexion optique, SerDes, DSP, photonique sur silicium (silicon photonics), DCI.
Mais cette fois, l’accent de Structera X et Structera A, c’est d’amener MRVL dans la grande ligne directrice du goulot d’étranglement de la mémoire pour l’IA.
Désormais, la chose la plus chère d’un centre de données IA n’est plus seulement le GPU.
La mémoire devient aussi de plus en plus chère.
Contexte long, multi-agents, services d’inférence, bases de données vectorielles, bases de données en mémoire (in-memory database), modèles de recommandation : dans tous ces cas, la DRAM est consommée de façon effrénée.
Le GPU s’occupe du calcul.
La mémoire s’occupe de la mémoire/la persistance (souvenir).
L’interconnexion optique s’occupe du transfert des données.
Si la mémoire ne suffit pas, même un GPU très puissant finira par être bloqué
C’est précisément l’enjeu du plan CXL de MRVL
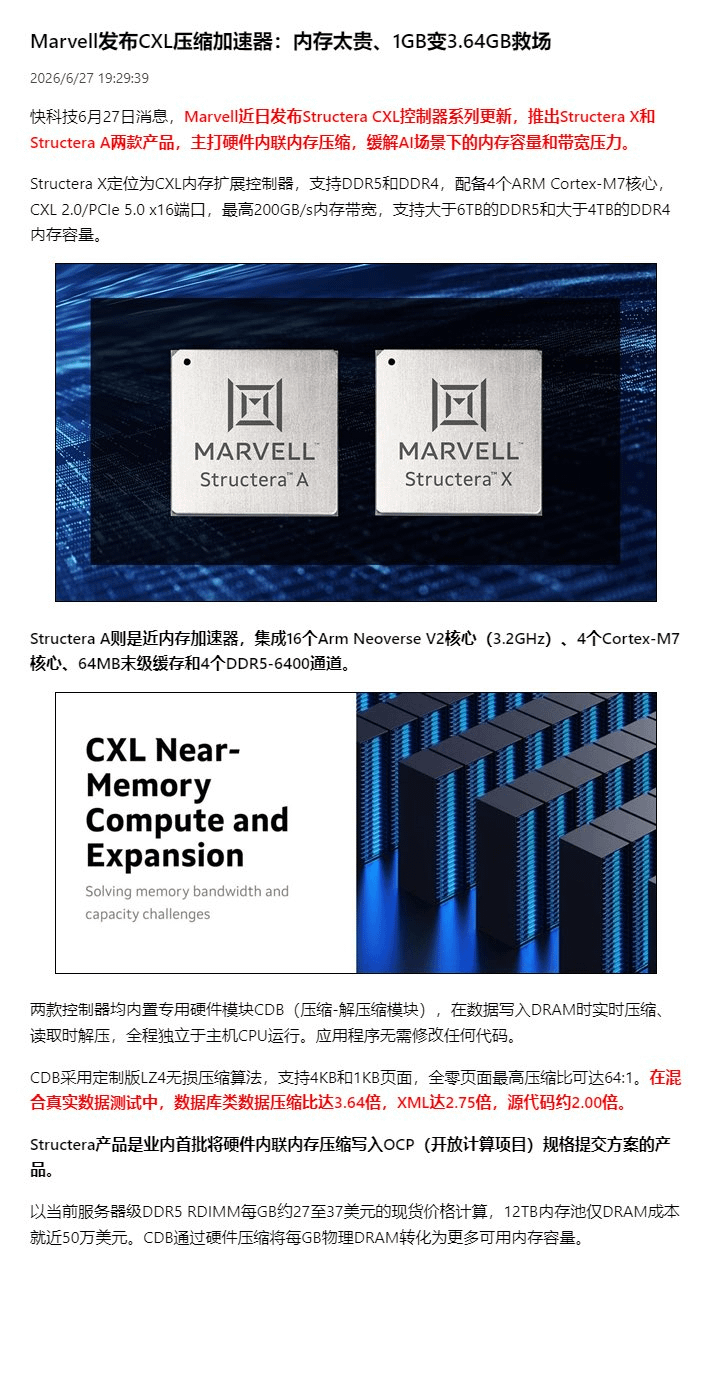
Le cœur de Structera X et de Structera A n’est pas de rajouter simplement un contrôleur mémoire : c’est, via CXL, raccorder la DRAM externe au serveur, puis effectuer une compression en ligne (inline) matérielle, pour transformer chaque 1GB de mémoire physique en davantage de capacité utilisable.
Dans les données officielles, la compression des données de type base de données peut aller jusqu’à 3,64x.
Environ 2,75x pour l’XML.
Environ 2,0x pour le code source.
Bien sûr, cela ne veut pas dire que toutes les données passent de 1GB à 3,64GB.
Le taux de compression dépend du type de données.
Mais l’essentiel est :
Si un hyperscaler peut, grâce à la compression matérielle, faire en sorte qu’une partie des données compressibles augmente la capacité mémoire effective, alors cela revient à atténuer la pénurie de mémoire et la pression sur les coûts sans avoir à acheter beaucoup plus de DRAM.
C’est une idée très attrayante pour les fournisseurs de cloud.
Parce qu’aujourd’hui, les DDR5 RDIMM au niveau des serveurs sont déjà très chères.
Un pool mémoire de 12TB : le coût DRAM à lui seul pourrait déjà approcher 500 000 dollars.
Quand la vitesse d’expansion de l’infrastructure IA dépasse celle de l’approvisionnement des fonderies, la mémoire n’est plus un simple composant : c’est une ressource stratégique.
C’est la même logique que celle révélée récemment par le rapport financier de Micron.
L’IA est en train de re-pricer le stockage et la mémoire : de produits cycliques vers de véritables goulots d’étranglement d’infrastructure.
$MU Il s’agit de résoudre le problème d’approvisionnement en HBM, DRAM et NAND.
$MRVL Cette fois, le problème abordé est :
Quand la mémoire devient de plus en plus chère, comment rendre chaque gigaoctet (GB) plus rentable.
Voilà le vrai centre d’intérêt de Structera.
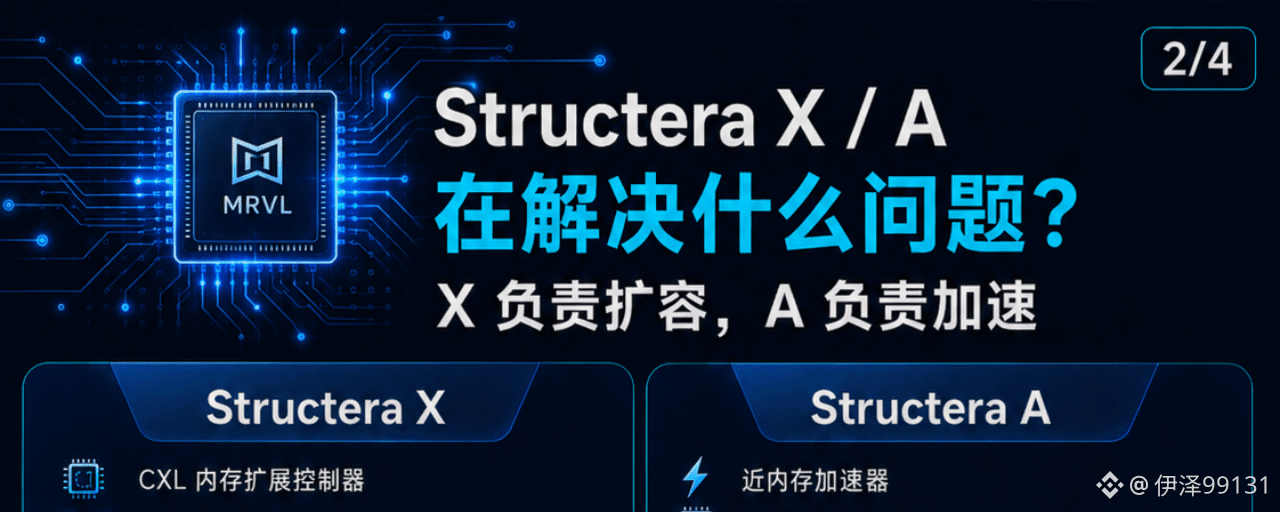
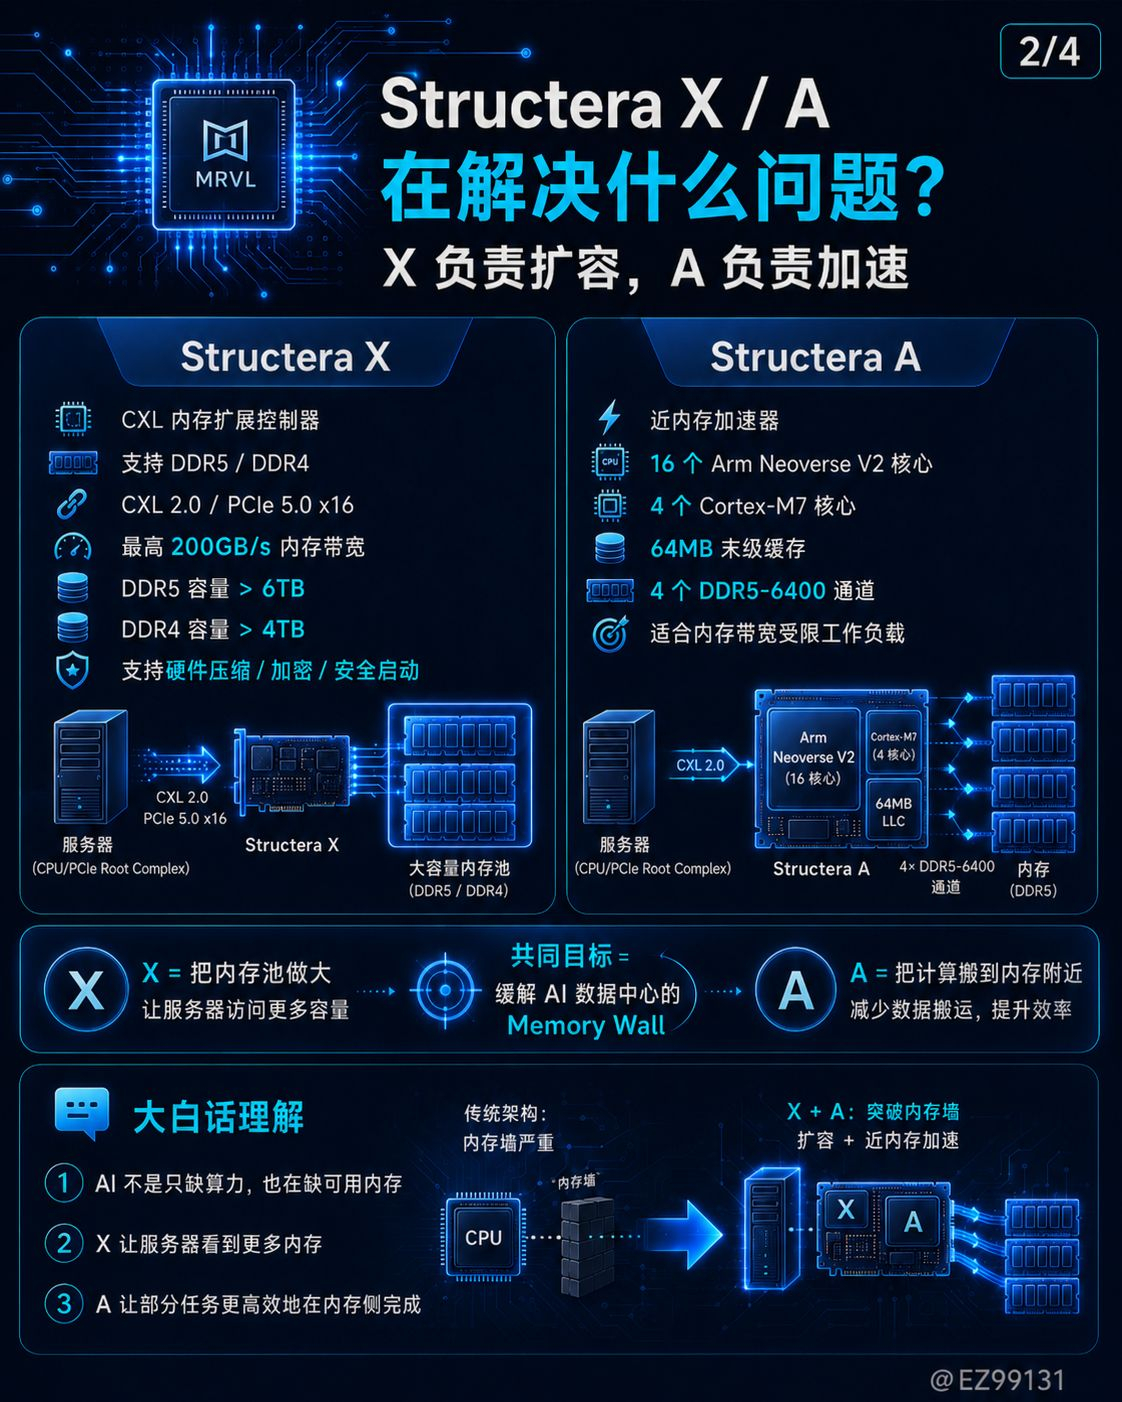
Structera X ressemble davantage à un contrôleur d’extension de mémoire.
Il s’agit de la façon dont la pool de mémoire des serveurs peut devenir plus grande.
Structera A ressemble davantage à un accélérateur de calcul proche de la mémoire.
Il s’attaque à certains travaux limités par la bande passante mémoire : peut-on déplacer le calcul à proximité de la mémoire ?
En clair :
X est en charge d’augmenter la capacité.
A est en charge de l’accélération.
Les deux s’attaquent ensemble au mur de mémoire des data centers à l’ère de l’IA.
Parce que la gamme de produits Structera n’est pas apparue pour la première fois aujourd’hui : dès 2024, elle avait déjà été publiée.
Cette fois, cela ressemble davantage à une manière pour Marvell de remettre sur le devant de la scène la valeur économique du « CXL + compression matérielle ».
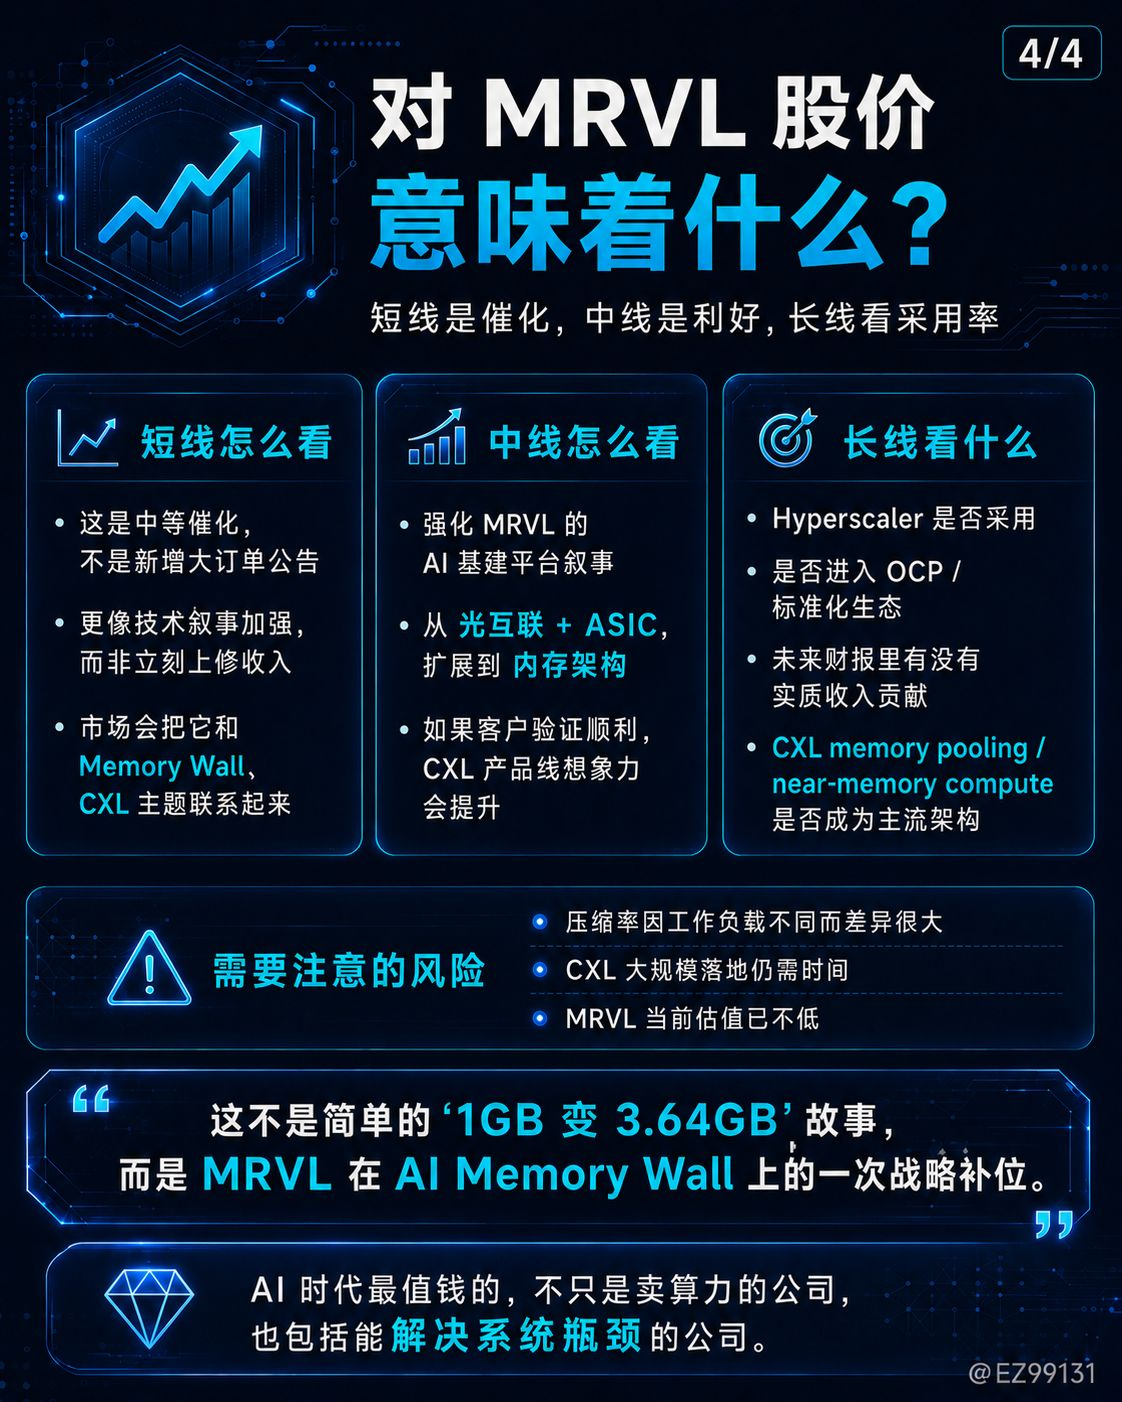
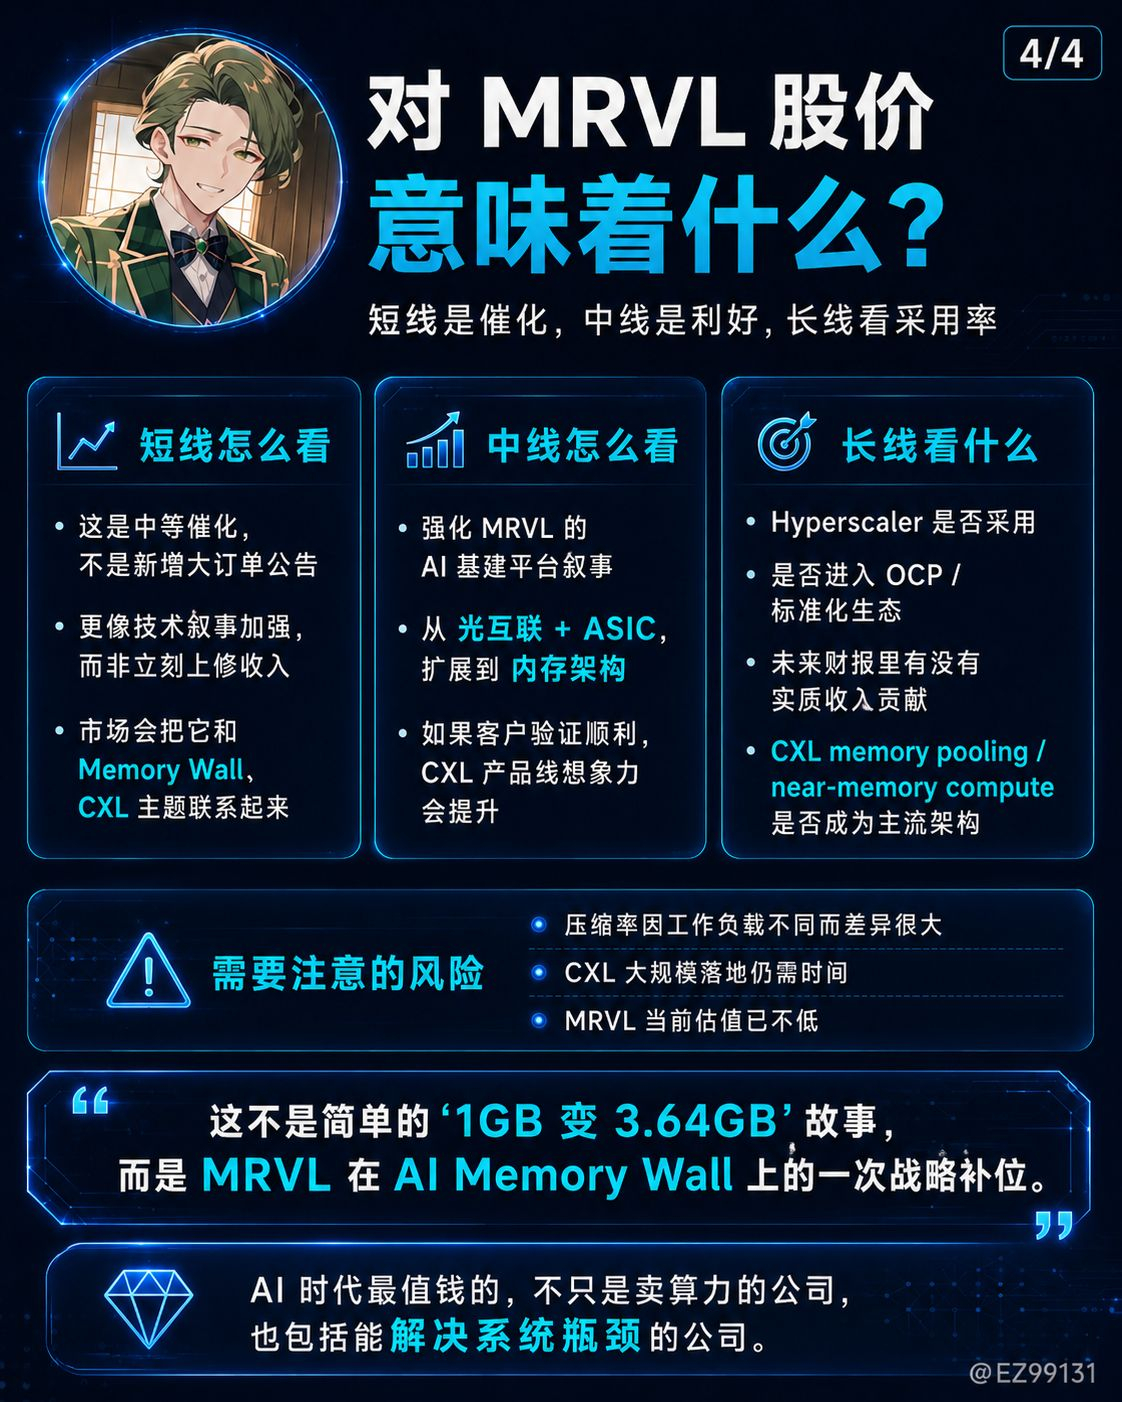
Ainsi, à court terme, ce n’est pas un bon signal de commandes au sens traditionnel.
Mais à moyen et long terme, c’est extrêmement important pour la narration de MRVL.
Parce que le puzzle de l’infrastructure IA de MRVL devient de plus en plus complet
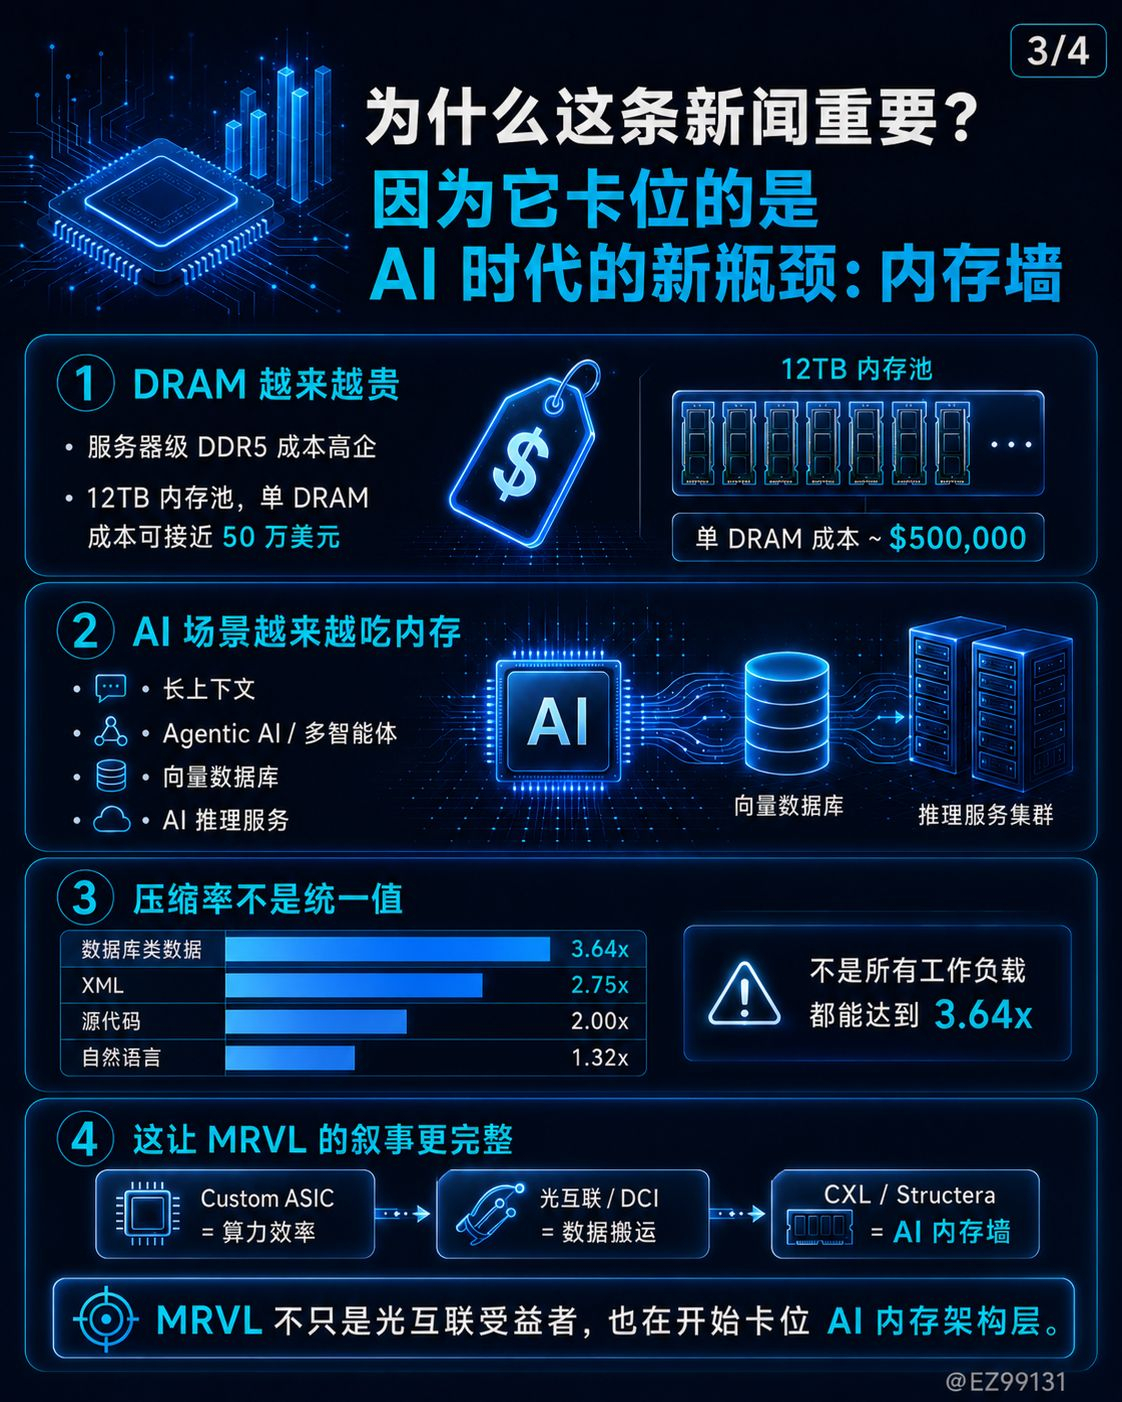
La première partie, c’est un custom ASIC.
Résoudre l’efficacité du calcul IA
La deuxième partie, c’est l’interconnexion optique et le coherent DCI.
Résoudre le transport des données pour l’IA.
La troisième partie, c’est CXL et l’expansion mémoire.
Résoudre le mur de mémoire côté IA.
Si l’on y ajoute encore le photonic fabric de Celestial AI, Marvell avance en réalité dans une seule direction :
Ce n’est pas seulement vendre une puce ponctuelle.
Devenir la plateforme semi-conducteurs cœur de l’infrastructure de données pour l’IA.
C’est très crucial.
La prochaine étape de l’infrastructure IA : ce ne sera pas uniquement « qui peut fournir des GPU ».
Non pas tant qui peut résoudre le problème, mais plutôt qui peut résoudre les goulots d’étranglement systémiques.
Goulot d’étranglement côté calcul
Goulot d’étranglement côté mémoire
Goulot d’étranglement côté réseau
Goulot d’étranglement en termes de consommation électrique
Plus le data center est grand, plus il y a de goulots d’étranglement.
Et MRVL se retrouve justement coincée entre beaucoup de goulots d’étranglement.
Cela montre que Marvell n’est pas seulement un bénéficiaire de l’interconnexion optique, et pas non plus un simple bénéficiaire d’ASIC.
Elle prend aussi des positions au niveau de l’architecture mémoire.
Si, à l’avenir, le pooling mémoire CXL, l’expansion CXL et le near-memory compute deviennent une architecture standard chez les hyperscalers, Structera serait une gamme de produits très porteuse d’imagination.
Le risque, c’est :
Premièrement, pour l’instant, cette annonce est surtout un récit technologique et produit, pas un bulletin de nouvelles grosses commandes.
Deuxièmement, un déploiement à grande échelle de CXL nécessite encore que les clients valident, que l’écosystème mûrisse et que le logiciel s’adapte.
Troisièmement, le taux de compression ne peut pas atteindre 3,64x dans tous les scénarios ; l’effet réel dépend de la charge (workload).
Quatrièmement, l’évaluation de MRVL n’est déjà pas basse : le marché doit voir que ces produits finissent par entrer dans les résultats financiers, plutôt que de ne rester qu’au stade de l’histoire technique.
Si c’est adopté à grande échelle par les hyperscalers, l’enjeu est considérable.
Ce qu’elle renforce vraiment, c’est un jugement :
À l’ère de l’IA, le mur de mémoire devient en train de se transformer en un goulot d’étranglement d’infrastructure aussi important que l’interconnexion optique.
Et Marvell est en train de déployer en même temps ces deux murs.
Ce n’est pas un gimmick du type « 1GB devient 3,64GB ».
C’est une manœuvre stratégique de MRVL sur la direction du mur mémoire de l’IA.
Si le calcul IA continue de s’étendre, les entreprises les plus valorisées à l’avenir ne seront pas seulement celles qui vendent de la puissance de calcul.
Cela inclut aussi les entreprises qui permettent d’éviter que la puissance de calcul soit « étouffée » par la mémoire, le réseau et le transport des données.
$MRVL Il s’oriente précisément vers cela.