
Le fait de voir un échange de modèle prendre moins de temps que ce à quoi je m’attendais a été le moment où tout a fait “clic”.
$OPG
J’avais une version ONNX prête, je l’ai intégrée dans OpenGradient, et je m’attendais à la décision habituelle : soit conserver le modèle en place pour le rendement, soit le déplacer rapidement lorsque la demande change. À la place, @OpenGradient a géré la transition sans imposer ce vieux compromis.
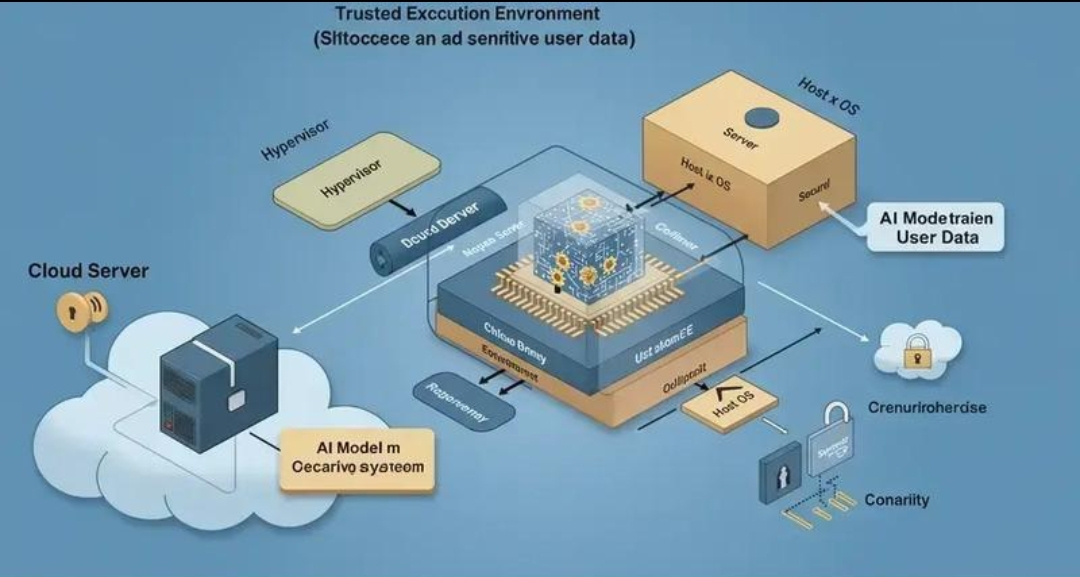
Ce sont les chiffres qui m’ont fait vraiment attention. Après plus de 150 000 requêtes d’inférence privées exécutées à l’intérieur d’enclaves matérielles TEE, le goulot d’étranglement que j’attendais ne s’est jamais vraiment manifesté. Le modèle restait utilisable tout en participant encore au volet du rendement, ce qui, historiquement, donnait l’impression d’être lié à des engagements rigides de 30 jours. Cette friction est devenue étonnamment difficile à retrouver.
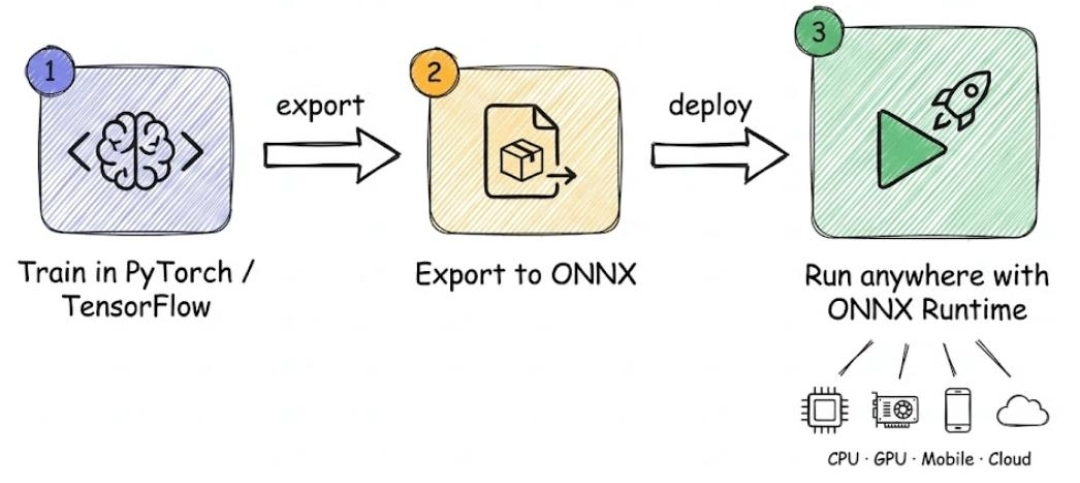
Je me surprenais quand même à revérifier si j’avais accidentellement sacrifié des retours quelque part. C’est probablement de la mémoire musculaire. Avec OpenGradient, le flux de travail ressemblait davantage à l’export d’un modèle ONNX, à son déploiement, puis à la poursuite de l’itération, plutôt qu’à une planification contrainte par des blocages. Le pipeline d’inférence ne semblait plus être le facteur limitant.
Ce qui ressortait n’était pas, à lui seul, un APY plus élevé ou un déploiement plus rapide. C’était de ne pas avoir à redessiner les décisions à chaque fois que les habitudes d’utilisation changeaient.
OpenGradient a discrètement supprimé une question à laquelle j’étais habitué avant chaque mise à jour.
Je ne dis pas que tous les cas limites ont disparu. Les grands modèles, l’évolution de la demande et des profils matériels différents révéleront probablement de nouvelles limites. Mais après y avoir passé du temps dans OpenGradient, le compromis rendement versus flexibilité me paraît beaucoup moins fort qu’il ne l’était même il y a quelques itérations.
C’est la partie à laquelle je continue de penser.
#OPG #opg #opgtoken #opgusdt $OPENAI $CL
$OPG
J’avais une version ONNX prête, je l’ai intégrée dans OpenGradient, et je m’attendais à la décision habituelle : soit conserver le modèle en place pour le rendement, soit le déplacer rapidement lorsque la demande change. À la place, @OpenGradient a géré la transition sans imposer ce vieux compromis.
Ce sont les chiffres qui m’ont fait vraiment attention. Après plus de 150 000 requêtes d’inférence privées exécutées à l’intérieur d’enclaves matérielles TEE, le goulot d’étranglement que j’attendais ne s’est jamais vraiment manifesté. Le modèle restait utilisable tout en participant encore au volet du rendement, ce qui, historiquement, donnait l’impression d’être lié à des engagements rigides de 30 jours. Cette friction est devenue étonnamment difficile à retrouver.
Je me surprenais quand même à revérifier si j’avais accidentellement sacrifié des retours quelque part. C’est probablement de la mémoire musculaire. Avec OpenGradient, le flux de travail ressemblait davantage à l’export d’un modèle ONNX, à son déploiement, puis à la poursuite de l’itération, plutôt qu’à une planification contrainte par des blocages. Le pipeline d’inférence ne semblait plus être le facteur limitant.
Ce qui ressortait n’était pas, à lui seul, un APY plus élevé ou un déploiement plus rapide. C’était de ne pas avoir à redessiner les décisions à chaque fois que les habitudes d’utilisation changeaient.
OpenGradient a discrètement supprimé une question à laquelle j’étais habitué avant chaque mise à jour.
Je ne dis pas que tous les cas limites ont disparu. Les grands modèles, l’évolution de la demande et des profils matériels différents révéleront probablement de nouvelles limites. Mais après y avoir passé du temps dans OpenGradient, le compromis rendement versus flexibilité me paraît beaucoup moins fort qu’il ne l’était même il y a quelques itérations.
C’est la partie à laquelle je continue de penser.
#OPG #opg #opgtoken #opgusdt $OPENAI $CL