Il y a quelques mois, j'ai remarqué quelque chose d'étrange.
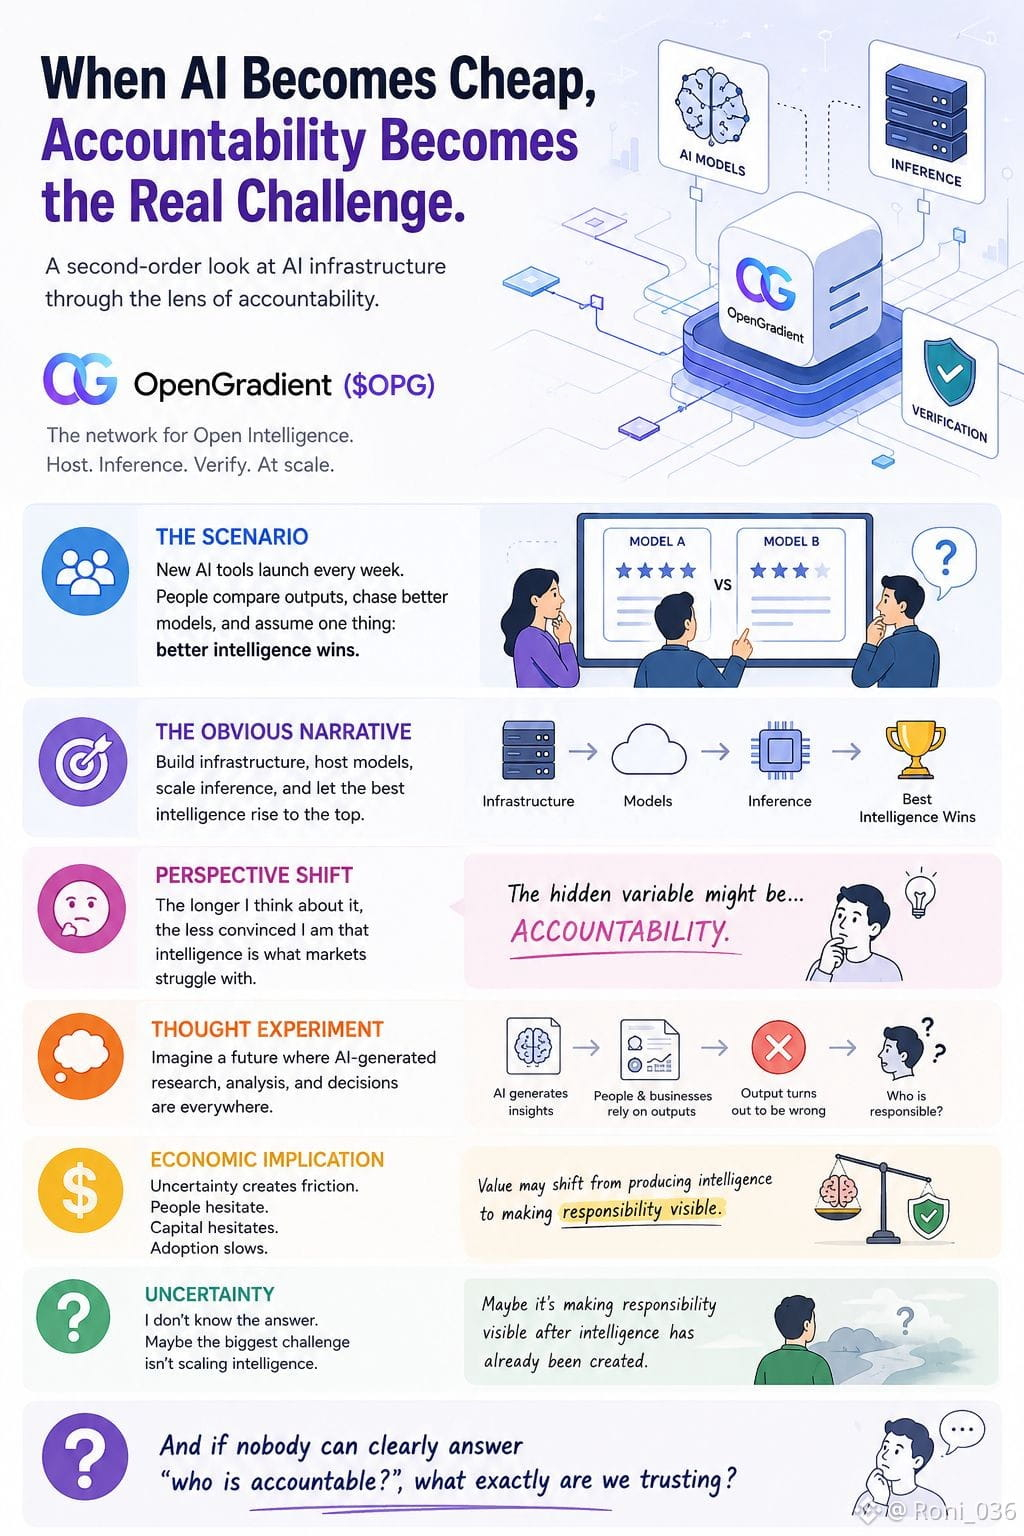
Chaque fois qu'un nouvel outil d'IA était lancé, les gens passaient des heures à comparer les résultats. Quel modèle écrit mieux ? Lequel raisonne mieux ? Lequel est le plus précis ?
La conversation semblait toujours se terminer par la même conclusion : la meilleure intelligence gagne.
C'est aussi la façon naturelle de voir des projets comme @OpenGradient . Construire des infrastructures, héberger des modèles, scaler l'inférence, et laisser la meilleure intelligence émerger.
Mais plus j'y pense, moins je suis convaincu que l'intelligence est ce avec quoi les marchés luttent.
La variable cachée pourrait être la responsabilité.
Imaginez un futur où la recherche, l'analyse et les décisions générées par l'IA sont partout. Pas parce que l'IA est devenue révolutionnaire du jour au lendemain, mais parce que générer de l'intelligence est devenu suffisamment bon marché pour que tout le monde puisse le faire.
Maintenant, posez une question différente.
Quand un résultat d'IA s'avère erroné, qui supporte le coût ?
Le créateur ? L'opérateur ? L'utilisateur ? Personne ?
Cette incertitude crée des frictions. Les gens hésitent. Le capital hésite. L'adoption ralentit.
Vu sous cet angle, @OpenGradient semble moins être une histoire sur la mise à disposition de l'IA et plus une question sur la responsabilité dans un monde où l'intelligence peut être produite à l'infini.
Peut-être que le plus grand défi n'est pas de scalper l'intelligence.
Peut-être que c'est de rendre la responsabilité visible après que l'intelligence ait déjà été créée.
Et si personne ne peut clairement répondre "qui est responsable ?", sur quoi faisons-nous confiance ?
#opg $OPG @OpenGradient