.

Publier
--

SANTO KEKI
·
--
Haussier@OpenGradient
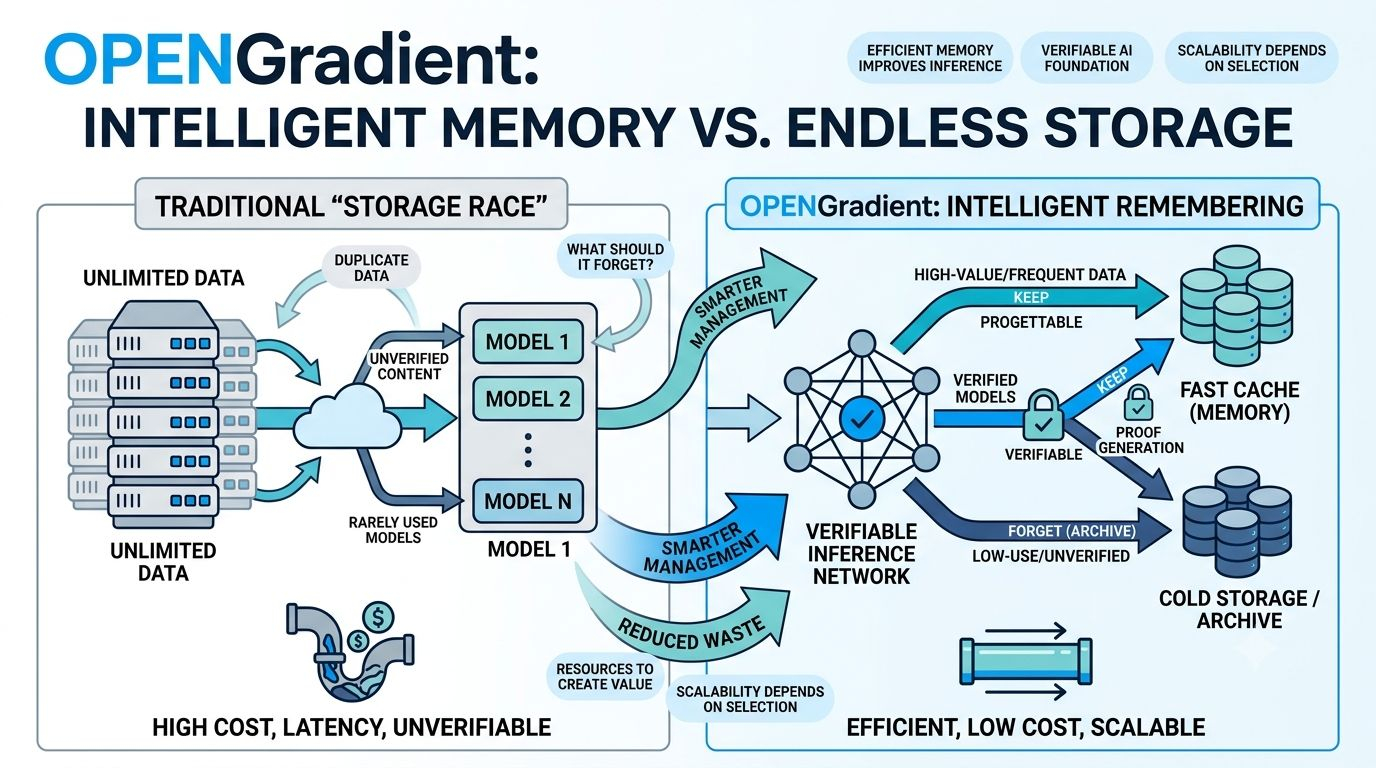
Je pensais que l'infrastructure IA deviendrait finalement une course au stockage.
Plus de modèles. Plus de données. Plus de capacité.
Plus je plonge dans OpenGradient, moins j'y crois.
Ce qui m'intéresse maintenant, c'est une question différente :
Que doit se rappeler le réseau, et que doit-il oublier ?
Dans les systèmes IA, chaque modèle n'a pas besoin de rester proche du calcul pour toujours. Chaque résultat n'a pas besoin de rester dans la couche la plus rapide indéfiniment. À mesure que les réseaux grandissent, la mémoire devient une ressource qui doit être gérée, pas seulement étendue.
C'est pourquoi je vois OpenGradient comme plus qu'un simple réseau d'inférence IA.
Il construit les bases d'une IA vérifiable, mais il fait également face à un défi plus profond : décider comment l'information circule à travers le système au fil du temps.
L'infrastructure la plus intelligente n'est pas toujours celle qui stocke le plus.
Parfois, c'est celle qui se rappelle les bonnes choses.
Une mémoire efficace peut améliorer l'inférence, réduire des coûts inutiles, et rendre les ressources disponibles là où elles créent le plus de valeur. À mesure que l'utilisation croît, ces décisions deviennent de plus en plus importantes.
Pour moi, c'est l'un des aspects les plus négligés d'OpenGradient.
Tout le monde parle d'intelligence.
Peu de gens parlent de mémoire.
Pourtant, la mémoire pourrait être la couche qui détermine si les systèmes IA restent efficaces à grande échelle.
À long terme, la scalabilité pourrait dépendre moins de la quantité qu'un réseau peut stocker et plus de la manière intelligente dont il décide quoi garder.
#opg $OPG #OPG $SYN $MUB
Je pensais que l'infrastructure IA deviendrait finalement une course au stockage.
Plus de modèles. Plus de données. Plus de capacité.
Plus je plonge dans OpenGradient, moins j'y crois.
Ce qui m'intéresse maintenant, c'est une question différente :
Que doit se rappeler le réseau, et que doit-il oublier ?
Dans les systèmes IA, chaque modèle n'a pas besoin de rester proche du calcul pour toujours. Chaque résultat n'a pas besoin de rester dans la couche la plus rapide indéfiniment. À mesure que les réseaux grandissent, la mémoire devient une ressource qui doit être gérée, pas seulement étendue.
C'est pourquoi je vois OpenGradient comme plus qu'un simple réseau d'inférence IA.
Il construit les bases d'une IA vérifiable, mais il fait également face à un défi plus profond : décider comment l'information circule à travers le système au fil du temps.
L'infrastructure la plus intelligente n'est pas toujours celle qui stocke le plus.
Parfois, c'est celle qui se rappelle les bonnes choses.
Une mémoire efficace peut améliorer l'inférence, réduire des coûts inutiles, et rendre les ressources disponibles là où elles créent le plus de valeur. À mesure que l'utilisation croît, ces décisions deviennent de plus en plus importantes.
Pour moi, c'est l'un des aspects les plus négligés d'OpenGradient.
Tout le monde parle d'intelligence.
Peu de gens parlent de mémoire.
Pourtant, la mémoire pourrait être la couche qui détermine si les systèmes IA restent efficaces à grande échelle.
À long terme, la scalabilité pourrait dépendre moins de la quantité qu'un réseau peut stocker et plus de la manière intelligente dont il décide quoi garder.
#opg $OPG #OPG $SYN $MUB
Avertissement : ce contenu inclut des opinions de tiers. Il ne constitue pas un conseil. Binance Ai peut être utilisée, sans garantie de résultat. Consultez les CG.