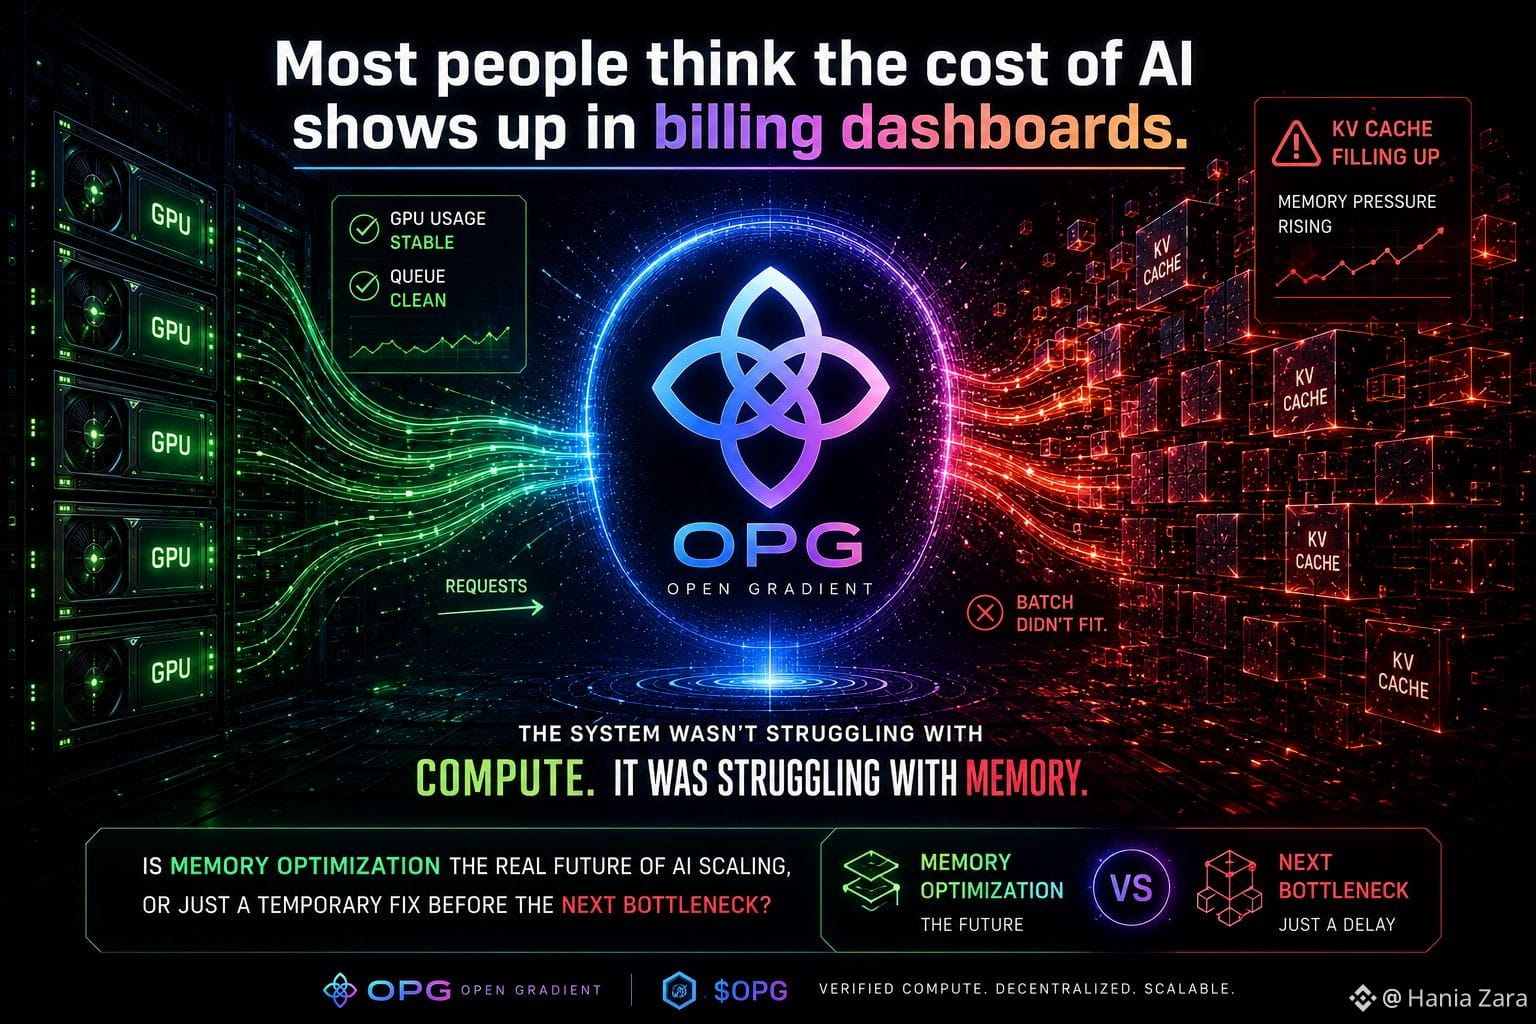
La plupart des gens pensent que le coût de l'IA se reflète dans les tableaux de bord de facturation.
Mais honnêtement… ce n'est pas là que tu ressens vraiment l'impact.
La première fois que je l'ai remarqué, tout semblait parfaitement normal — utilisation du GPU stable, file d'attente propre, rien d'alarment.
Mais un lot ne collait toujours pas.
Et c'est là que ça m'a frappé… le système n'avait pas de mal avec le calcul.
Il avait du mal avec la mémoire.
De longues invites retenaient silencieusement le cache KV comme un espace temporaire qui ne se libère jamais complètement — réduisant lentement combien le système peut réellement gérer.
La gestion du cache KV basée sur la pagination essaie de résoudre cela en divisant la mémoire en plus petites pages réutilisables. Plus de requêtes passent, de longues conversations ne deviennent pas instantanément un goulet d'étranglement.
Mais voici le vrai débat :
Est-ce suffisant pour l'avenir des systèmes IA comme OpenGradient Chat (https://chat.opengradient.ai) ?
Ou ne faisons-nous que retarder le prochain goulet d'étranglement ?
Parce que faire évoluer le calcul vérifié avec $OPG n'est plus seulement un problème de performance… c'est un problème d'architecture.
Alors, qu'en penses-tu :
👉 L'optimisation de la mémoire est-elle le véritable avenir de l'évolutivité de l'IA, ou juste un correctif temporaire ?
@OpenGradient
#opengradientchat
#OPG
$OPG
Mais honnêtement… ce n'est pas là que tu ressens vraiment l'impact.
La première fois que je l'ai remarqué, tout semblait parfaitement normal — utilisation du GPU stable, file d'attente propre, rien d'alarment.
Mais un lot ne collait toujours pas.
Et c'est là que ça m'a frappé… le système n'avait pas de mal avec le calcul.
Il avait du mal avec la mémoire.
De longues invites retenaient silencieusement le cache KV comme un espace temporaire qui ne se libère jamais complètement — réduisant lentement combien le système peut réellement gérer.
La gestion du cache KV basée sur la pagination essaie de résoudre cela en divisant la mémoire en plus petites pages réutilisables. Plus de requêtes passent, de longues conversations ne deviennent pas instantanément un goulet d'étranglement.
Mais voici le vrai débat :
Est-ce suffisant pour l'avenir des systèmes IA comme OpenGradient Chat (https://chat.opengradient.ai) ?
Ou ne faisons-nous que retarder le prochain goulet d'étranglement ?
Parce que faire évoluer le calcul vérifié avec $OPG n'est plus seulement un problème de performance… c'est un problème d'architecture.
Alors, qu'en penses-tu :
👉 L'optimisation de la mémoire est-elle le véritable avenir de l'évolutivité de l'IA, ou juste un correctif temporaire ?
@OpenGradient
#opengradientchat
#OPG
$OPG