je suis en train d'explorer l'architecture d'openledger dernièrement, principalement autour du système d'attribution et des incitations pour les contributeurs
la plupart des gens pensent qu'openledger n'est qu'un autre token crypto associé à l'IA, mais honnêtement, la partie la plus intéressante est la tentative de construire une infrastructure de coordination autour des données de l'IA elles-mêmes
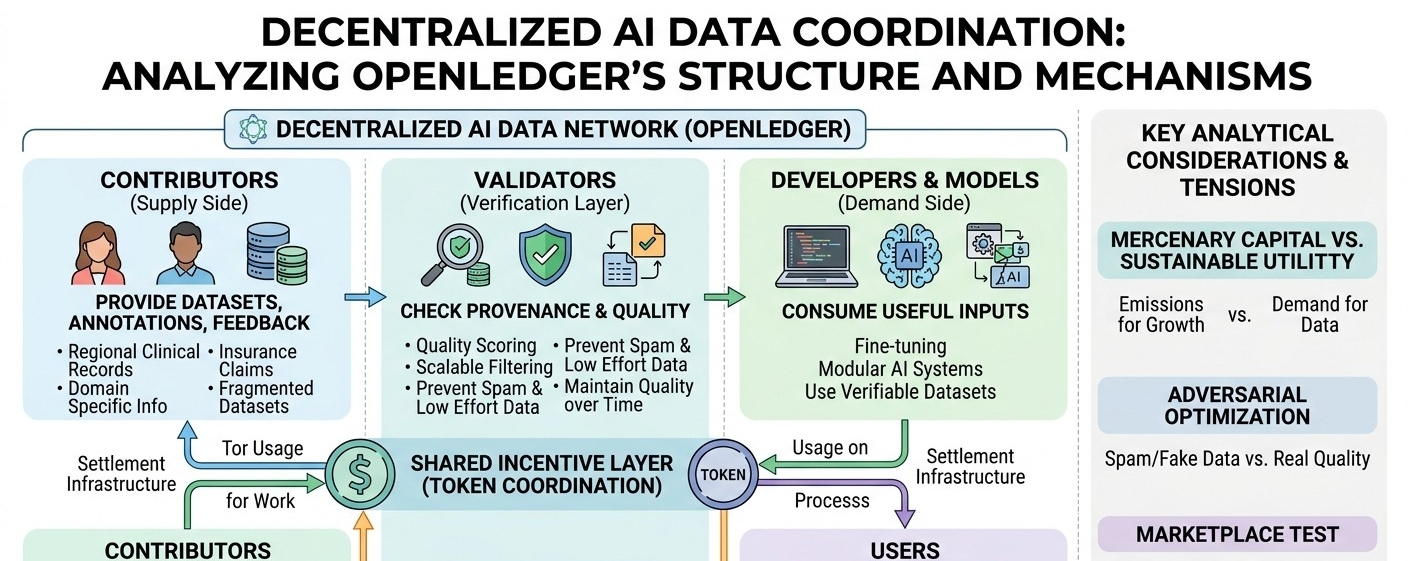
ce qui a attiré mon attention, c'est comment le réseau essaie de connecter les contributeurs, les validateurs, les développeurs et les utilisateurs à travers une couche d'incitation partagée
les contributeurs fournissent des ensembles de données, des annotations, des boucles de rétroaction ou des informations spécifiques au domaine
les validateurs vérifient la provenance et la qualité
les développeurs consomment des entrées utiles pour les modèles
les utilisateurs génèrent une demande à travers des applications ou des inférences
en théorie, le token coordonne la valeur à travers tous
le système de contribution décentralisé a en fait du sens dans certains domaines
un modèle de santé formé sur des dossiers cliniques régionaux ou des annotations de réclamations d'assurance a probablement besoin de jeux de données fragmentés que les systèmes centralisés ne priorisent pas toujours pour la collecte
openledger semble conçu autour de cette hypothèse
que les futurs systèmes d'IA deviennent plus modulaires et coordonnés de l'extérieur au lieu d'être entièrement intégrés verticalement
ensuite, il y a la couche d'attribution qui, honnêtement, semble être la partie la plus difficile de toute l'architecture
si les contributeurs sont récompensés en fonction de leur utilité en aval, comment le protocole sait-il quelles données ont réellement compté
et c'est la partie à laquelle je pense sans cesse
les modèles d'IA absorbent des motifs à partir d'entrées mixtes
un petit jeu de données de haute qualité peut compter plus que des millions d'exemples génériques
donc l'attribution devient très rapidement probabiliste
peut-être que c'est acceptable
les contributeurs n'ont probablement pas besoin d'une précision parfaite
ils ont juste besoin d'un système qui semble juste et difficile à manipuler
mais une fois que les récompenses en tokens deviennent significatives, les gens s'optimisent autour des métriques que le protocole mesure
c'est là que la tension des incitations se manifeste
si les émissions dominent avant que la demande réelle n'existe, les contributeurs peuvent télécharger des jeux de données dupliqués, des remplissages synthétiques, des annotations de faible effort ou des interactions de spam simplement parce que le système de récompense le permet
donc la couche de vérification compte autant que la couche de contribution elle-même
openledger a besoin de suivi de provenance, d'évaluation de qualité et de filtrage évolutif sans dériver vers une modération centralisée
trop peu de filtrage et le réseau devient bruyant
trop de filtrage et le principe décentralisé s'affaiblit
le côté marketplace est probablement le vrai test à long terme
idéalement, les développeurs paient pour des jeux de données vérifiés ou un accès aux modèles, les utilisateurs génèrent une demande d'inférence et les contributeurs gagnent à partir de l'utilisation réelle du réseau plutôt qu'à partir des émissions seules
dans cette version, le token devient une infrastructure de règlement plutôt qu'un simple carburant d'incitation
mais toute l'architecture dépend de la demande future d'IA devenant suffisamment fragmentée pour nécessiter ce type de couche de coordination
si de grandes plateformes continuent à contrôler la formation, le déploiement et le retour d'information des utilisateurs en interne, les marchés de données d'IA décentralisés pourraient rester relativement de niche
regardant
frais d'utilisation réels contre émissions
qualité des jeux de données contribué au fil du temps
demande des développeurs pour des données externes attribuables
comment les litiges d'attribution évoluent avec la participation
pas de conclusion claire pour l'instant
openledger pourrait être en train de construire une couche de coordination durable pour des systèmes d'IA distribués
ou cela pourrait tester si les incitations en tokens peuvent créer un marché avant que le côté demande n'existe pleinement