

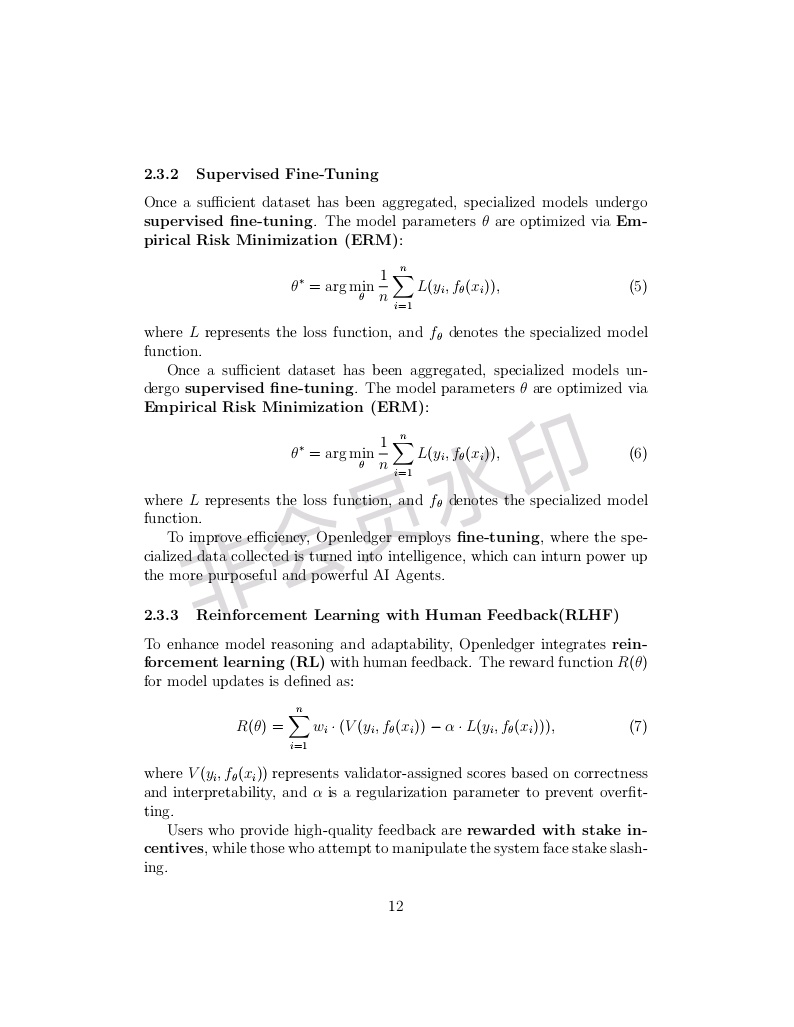
Les gars, avant-hier soir, j'ai fait quelque chose de vraiment intéressant. Ce n'était pas pour pump des shitcoins ni pour acheter au fond, mais j'ai donné un feedback 'RLHF' à un modèle dans OpenLedger. Vous devinerez quoi ? Non seulement j'ai corrigé une erreur évidente dans le modèle, mais j'ai aussi reçu une récompense de $OPEN.
Voici l'histoire. Ce jour-là, je flânais dans l'AI Studio d'OpenLedger et j'ai vu un modèle spécialisé qui venait d'être déployé. Il semble qu'il soit destiné à classifier les entités sur la blockchain. En entrant une adresse, il te dira si cette adresse est probablement une bourse, un whale, un utilisateur ordinaire ou un bot. Je trouvais ça assez utile, donc j'ai décidé d'essayer.
Résultat : j’ai saisi une adresse de wallet que j’utilise habituellement. Le modèle me l’a classée comme « suspecte, probablement un robot ». Sur le coup, j’ai rigolé : je suis bien un humain, je fais la manipulation manuellement, je n’ai rien d’un robot. Alors j’ai cliqué sur le bouton de feedback pour la corriger. J’ai uploadé l’historique de mes interactions manuelles sur les trois derniers mois, et j’ai aussi rédigé une explication pour expliquer pourquoi, selon moi, ce n’était pas un robot mais un utilisateur normal.
À ce moment-là, je n’ai pas trop réfléchi. J’ai cliqué, puis je suis passé à autre chose pour continuer à scroller.
Résultat : hier après-midi, j’ai ouvert l’interface d’OpenLedger et j’ai vu qu’une notification supplémentaire apparaissait dans la barre de notifications. Elle disait que mon feedback avait été accepté. Le modèle a recalibré dans la direction que j’avais fournie. Le système m’a aussi attribué une incitation RLHF, ce qui représentait environ une dizaine de $OPEN . Ce n’est pas beaucoup, mais le fait d’être reconnu, ça fait vraiment plaisir.
J’ai regardé les performances après les mises à jour du modèle. J’ai réintroduit mon adresse : cette fois, il l’a correctement reconnue. J’ai aussi testé les adresses de quelques amis, et le taux de précision était un peu plus élevé qu’avant. Ce n’était que légèrement, mais je me suis dit qu’il y avait aussi ma contribution là-dedans : ce sentiment d’implication est particulièrement fort.
C’est justement la force de ce mécanisme d’OpenLedger. Avant, si les modèles étaient bons ou non, on devait attendre que l’équipe les mette à jour tranquillement. Quand les utilisateurs donnaient des avis, on ne savait pas si les développeurs les écoutaient, et on ne pouvait encore moins obtenir de l’argent grâce à tes retours. Mais maintenant, c’est différent : tu aident le modèle à corriger ses erreurs, le modèle devient plus intelligent, et tu reçois une récompense. Tout le processus est traçable on-chain : qui a fait quelle contribution, c’est clair et net.
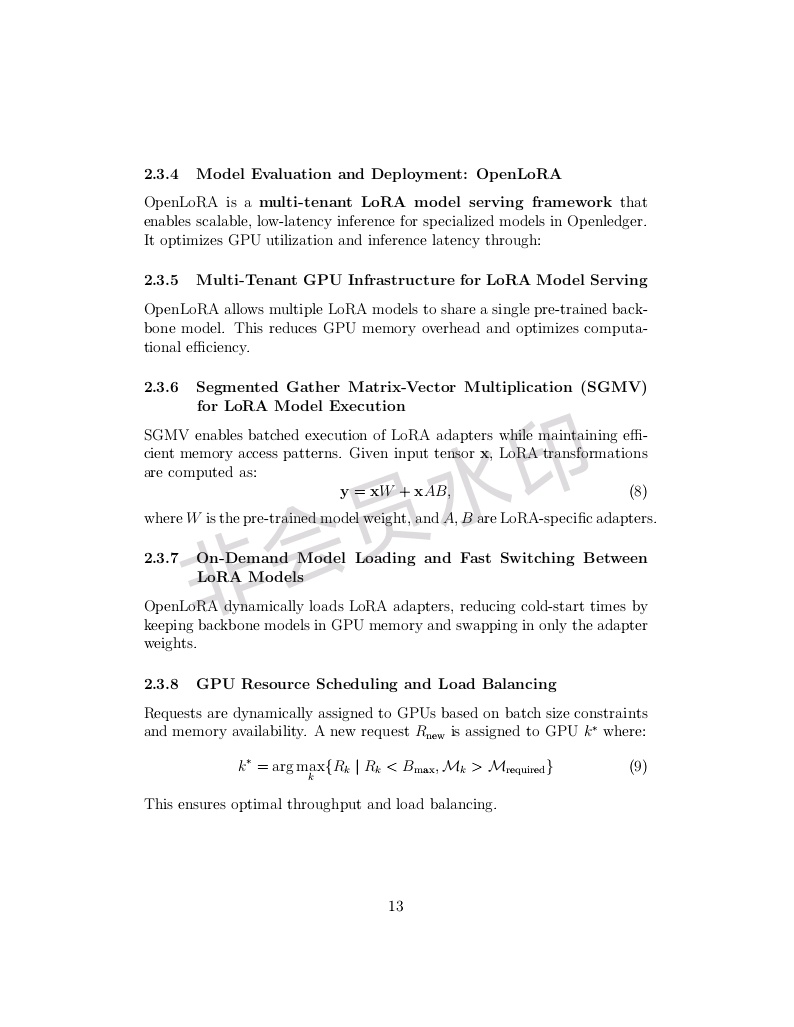
J’ai ensuite testé plusieurs autres modèles, en repérant surtout leurs défauts. Par exemple, il y en a un qui ne distinguait pas deux protocoles aux fonctionnalités similaires : j’ai donc indiqué les différences et fourni aussi quelques exemples d’adresses. Je ne sais pas si tout cela sera accepté par la suite, mais à chaque fois que je soumets un retour, le système enregistre l’empreinte d’attribution de cette contribution. À l’avenir, si le modèle progresse dans ces directions, il est possible que tu reçoives une récompense.
C’est bien mieux que n’importe quel système de points. Les points, c’est toi qui supplie la plateforme de te les donner. L’empreinte d’attribution, elle, c’est toi qui apportes une contribution : le système calcule automatiquement combien tu dois recevoir. Les deux n’ont absolument pas la même nature.
Parlons aussi du smart agent Octoclaw. Récemment, j’ai découvert qu’il peut s’aligner avec ce retour RLHF. Dans mon agent, j’ai configuré une tâche de surveillance, spécialement pour suivre les modèles que j’ai déjà feedback. Je regarde comment ils évoluent ensuite. Si, pour un certain type d’adresse, le taux de précision du modèle augmente, l’agent l’enregistre automatiquement. Ensuite, je peux vérifier si mon feedback a eu un effet. C’est un peu comme voir l’arbre qu’on a planté grandir petit à petit.
Honnêtement, avant, mon attitude envers l’IA, c’était seulement de l’utiliser. Si ça ne marchait pas, j’en prenais une autre. Je n’avais jamais pensé que je pouvais aussi participer pour l’améliorer. Mais avec OpenLedger, la barrière est tombée : tu n’as pas besoin de comprendre le code, ni les algorithmes. Il suffit de savoir utiliser un wallet, observer, et juger. Tu peux alors devenir une partie du processus d’entraînement. Et chaque fois que tu fais une contribution, elle est enregistrée : tu as aussi une chance de monétiser.
Je n’ai pas encore vendu ma petite quantité, @Openledger parce qu’aujourd’hui il y a de plus en plus d’usages. Pour faire des mises de fonds en retour, c’est utile. Pour entraîner des modèles, c’est nécessaire. Pour payer les frais d’inférence, aussi. Et à mesure que je participe davantage, les poids des contributions que le système enregistre pour moi s’accumulent petit à petit. À l’avenir, si des appels de modèles utilisent des données liées à ces contributions, je pourrai continuer à en tirer une part. C’est comme planter une graine : elle continue de te donner des fruits.
Pour finir, je veux juste dire ceci : le monde de la blockchain ressemble un peu à l’époque où $BTC et $ETH venaient tout juste de sortir. L’infrastructure est encore en construction et les participants ont tous la chance de profiter des bénéfices précoces. Le plus important, c’est de trouver ceux qui font vraiment le travail, pas seulement ceux qui crient des slogans. À mes yeux, OpenLedger appartient clairement à la première catégorie #OpenLedger .
(Cet article est un compte rendu personnel de participation réelle. Ne constitue aucun conseil en investissement. Les frères, faites vos propres recherches et prenez vos propres décisions.)