
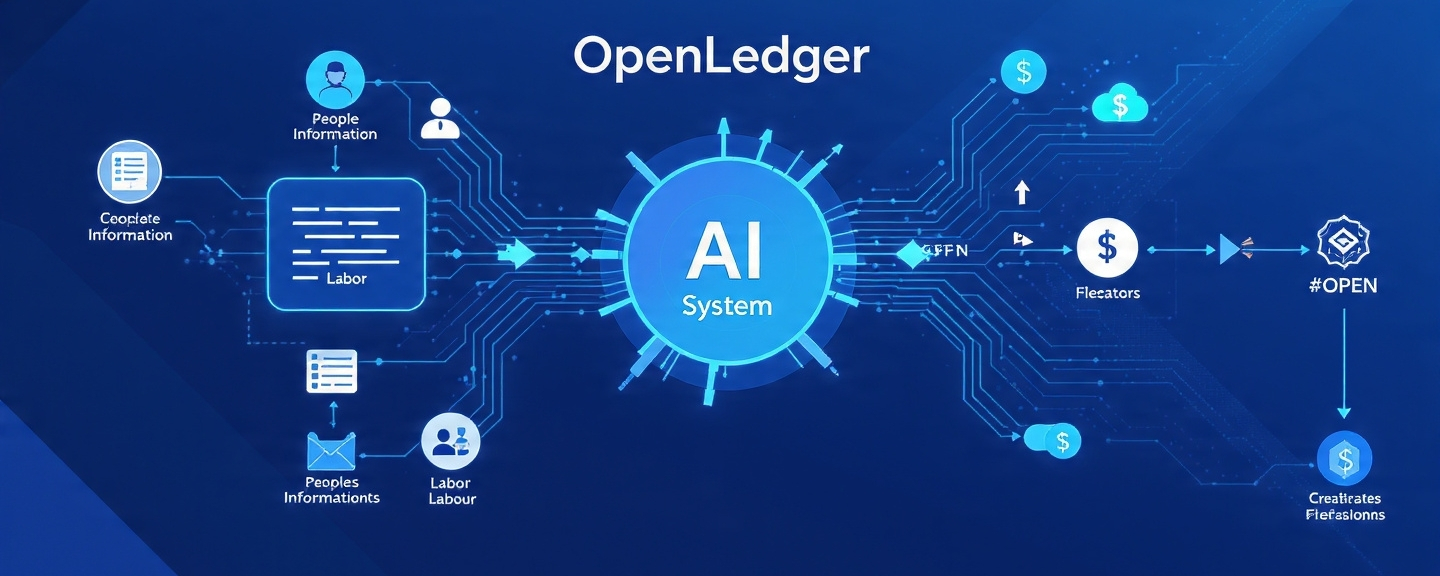
Passer des jours en recherche approfondie sur Open Ledger m’a conduit vers des endroits que je n’avais pas prévus. En voyant le nom apparaître dans des discussions crypto, les premières réactions pourraient pencher vers le scepticisme. Après tout, tant de bruit récemment se cache derrière le buzz de l’IA.
Et voici quelque chose de différent, construit en silence là où d’autres crient. Détachez une couche, puis une autre, pour découvrir un cap sur une crise que peu osent aborder.
données volées, droits des créateurs érodés, disparition du contrôle sur ce que les gens produisent.
Comprendre cela, c’est affronter la réalité numérique d’aujourd’hui de plein fouet : les systèmes mis en place prospèrent en conservant le travail sans consentement. D’immenses plateformes aspirent des écrits, des visuels, des données de santé, des habitudes de consommation, tout ce qui circule à l’écran.
Ce raz-de-marée d’efforts humains alimente des algorithmes secrets, façonnant des outils puissants détenus par une poignée de personnes, tandis que ceux qui ont contribué n’obtiennent rien. Ceux qui construisent la valeur centrale n’ont rien en retour : des récompenses à zéro, des noms invisibles, laissés totalement de côté. Que se passe-t-il quand les données deviennent quelque chose que l’on peut vraiment posséder, échanger, déplacer librement ?
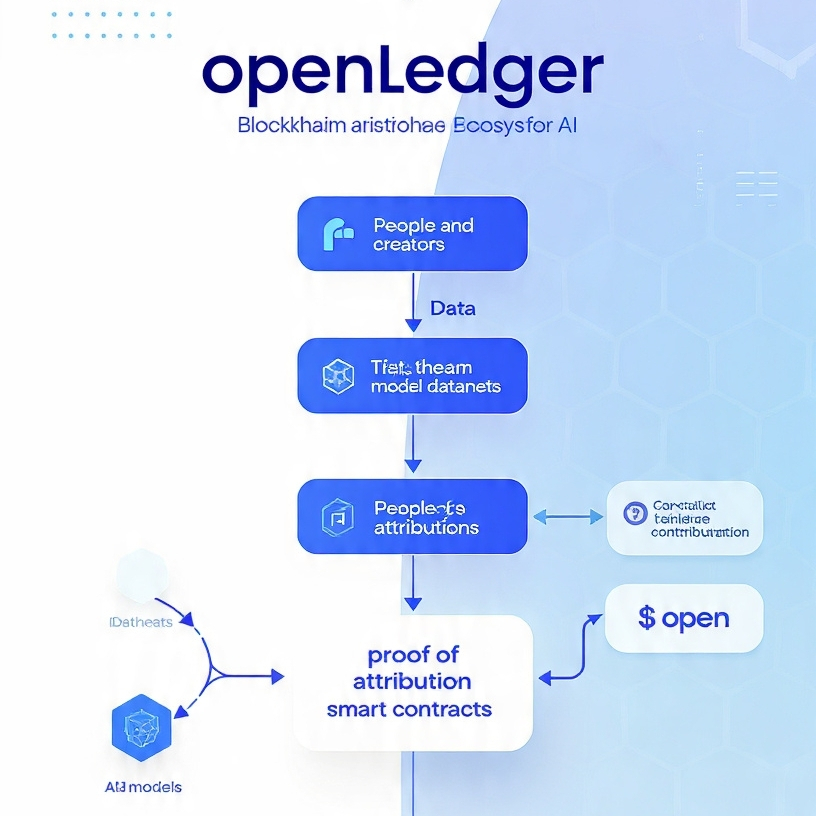
C’est là que Open Ledger commence. En dessous de tout, une couche blockchain conçue spécialement pour les modèles d’IA fonctionne avec les outils existants et gère chaque phase, de la collecte de faits bruts au lancement de programmes s’exécutant d’eux-mêmes.
Au cœur, il y a Proof of Attribution : un système qui garantit que chaque morceau de données ne se perd pas dans les algorithmes, mais qu’il est traçable clairement grâce à des accords basés sur du code. Ces liens se construisent à travers des collections partagées appelées Datanets, façonnées par des groupes centrés sur des domaines de connaissance précis, comme des documents juridiques rares, des variations serrées de la finance de marché, ou des résultats d’études de santé isolés.
les uns après les autres, les gens et les groupes déversent leurs données dans ces Datanets pendant que des codeurs exploitent un espace no-code nommé ModelFactory pour façonner ou ajuster de grands outils de langage. Si l’un de ces modèles prend feu au-delà du labo, en générant de vrais revenus, alors Proof of Attribution achemine discrètement une partie de cette manne directement vers ceux qui ont fourni les connaissances initiales.
Voici OpenLoRA : une machine élégante conçue pour que des milliers d’ajustements personnalisés de modèles puissent vivre ensemble sur un seul processeur graphique. Ce changement facilite énormément l’accès, permettant aux inventeurs ordinaires, aux petites structures, voire même à des scientifiques en solo de créer quelque chose qu’ils appellent Payable AI — sans besoin d’empilements de serveurs financés par de très gros chèques.
Dans l’esprit, cela dessine une image rare : une où l’équité n’est pas proclamée, mais intégrée au design. Pourtant, franchissez cette couche d’idées l’espace d’une respiration, et affrontez la devise fondamentale qui bourdonne sous le token OPEN : c’est là que le scepticisme s’approche au plus près. Le soutien initial est arrivé vite, attirant de grands noms venus d’EigenLabs, ainsi que des leaders des domaines du calcul décentralisé et du suivi des données. Les bases juridiques comptent aussi : ils travaillent avec des protocoles spécifiques à l’IP pour créer des licences de données opposables.
Après son inscription sur les principales bourses, la demande a explosé fortement chez les acheteurs particuliers, poussant le prix près de 1,80 $ avant de retomber. Pour l’instant, le prix reste autour de vingt-deux cents, alourdi par un affrontement constant à court terme : des traders qui cherchent des mouvements rapides s’opposent à des forces plus lentes, comme les constructions d’infrastructures en temps réel.
Prenez la distribution des tokens. C’est cette partie qui me freine.
Quiconque regarde attentivement devrait le voir clairement : rien n’a été adouci.
Un milliard de tokens existe, gravé dans le marbre.
Environ 215 millions circulent aujourd’hui.
C’est à peine plus d’un cinquième. Le reste est largement retenu.
Les équipes partagent, les investisseurs détiennent, il y a des subventions pour les créateurs, des récompenses à venir : tout cela représente près de huit dixièmes.
Ils sont d’abord gelés, puis déversés lentement, année après année, après une période d’attente initiale. Ainsi, voici le danger discret : bien plus de tokens vont affluer sur les bourses avant même que l’usage ne rattrape. À moins que de grandes entreprises — cliniques, startups de legaltech, banques, bots qui agissent seuls — commencent à utiliser cette technologie régulièrement, la demande ne sera pas à la hauteur de ce qui arrive.
Sans cela, les prix se plient sous le seul poids du volume. Des maths simples. Sans prévenir, des pics de prix apparaissent lorsque des traders parient gros sur les bourses. Pourtant, ces moments s’effacent vite, jamais assez solides pour porter un token conçu pour l’échelle sur des années. Sans de vrais cas d’usage qui tirent la demande, le poids des nouveaux tokens arrivant sur le marché pèsera lourdement.
un flux constant d’utilisateurs qui comptent vraiment sur le système ?
C’est ce qui maintient l’équilibre. Vérité difficile, rien d’autre ne comble ce vide.
Pourtant, vu à travers la façon dont les choses sont construites et dont la société fonctionne, ils posent le type de fondation dont le monde en ligne a réellement besoin : pour que les gens ne soient pas sans cesse capturés pour leurs données, sans récompense. Ce n’est pas juste une autre expérience : elle mise tout sur la question de savoir qui pourra posséder la valeur numérique qui circule à l’avenir. Bien sûr, les obstacles liés aux règles technologiques et à la conception des incitations sont énormes.
Pourtant, quelque chose à son sujet paraît essentiel, impossible à ignorer.
Si quelqu’un juge OPEN uniquement comme un support de trading, sa trajectoire risque de vaciller fortement, dépendant entièrement de la mesure où l’IA reste un aimant pour les flux de trésorerie crypto. OpenLedger essaie de contourner ces limites en exécutant des tâches IA intenses hors de la chaîne tout en ancrant les résultats de preuve dessus. Mais élargir ce modèle à l’échelle mondiale ?
Affronter de front des géants bien rodés comme AWS ou Google Cloud rend les progrès presque impossibles.
Il y a aussi la menace constante visant les réseaux ouverts : des flots d’entrées factices, du contenu volé, des déchets robotiques qui mettent à rude épreuve des systèmes pensés pour filtrer la vérité automatiquement. Ces défenses ne doivent jamais faillir.
Par défaut, les blockchains ont toujours eu du mal avec la vitesse, le poids et le coût sous de fortes charges. L’intelligence artificielle exige une puissance de calcul écrasante et un accès quasi instantané à l’information. Ainsi, même les idées audacieuses doivent affronter un terrain hostile ici.
Mon avis brut sur OpenLedger ?
C’est l’une des rares approches qui met les humains au centre tout en s’attaquant de front à un système brisé.
