OpenLedger et l’étrange impression que l’IA est peut-être enfin en train de se heurter au même mur.
Je suis dans la crypto depuis assez longtemps pour cesser de réagir à chaque fois qu’un projet prétend qu’il est en train de “redéfinir” quelque chose.
La plupart du temps, ces mots ne sont que des emballages recyclés autour des mêmes vieilles incitations. Un nouveau token, un nouveau branding, la même réalité en dessous : quelques initiés capturent la valeur, la foule fournit la liquidité, et finalement le récit se déplace ailleurs.
C’est probablement pour ça que je suis devenu plus lent à m’enthousiasmer pour quoi que ce soit lié à l’IA ces derniers temps. Le secteur donne déjà l’impression d’être surpeuplé de promesses démesurées. Chaque semaine, il y a un autre protocole qui affirme qu’il va décentraliser l’intelligence, tokeniser des agents, réinventer le calcul, ou remplacer Internet lui-même. Au bout d’un moment, tout finit par se fondre dans le même bruit de fond.
Mais de temps en temps, quelque chose attire mon attention, non pas parce que j’y crois soudainement, mais parce que ça semble viser un problème qui existe vraiment.
OpenLedger fait partie de ces projets qui comptent pour moi.
Je ne dis pas que ça fonctionne. Je ne dis pas que ça gagne. Je ne dis même pas que le modèle est durable. Honnêtement, je ne sais pas encore.
Mais je continue de remarquer que la question sous-jacente qu’il pose me paraît plus réelle que la plupart des récits sur l’IA qui flottent dans la crypto en ce moment.
La question est simple : si les modèles d’IA deviennent l’une des structures les plus précieuses au monde, pourquoi presque personne ne sait d’où vient réellement la valeur ?
Ça semble évident au premier abord, mais plus on y pense, plus l’ensemble de l’économie de l’IA paraît étrange.
La plupart des systèmes d’IA d’aujourd’hui sont construits à partir d’océans de données collectées auprès de personnes qui ne voient généralement jamais de rémunération, de droits de propriété, ou même une simple reconnaissance. Des écrivains, des artistes, des chercheurs, des utilisateurs de forums, des développeurs, des communautés de niche, des archives Internet au hasard — tout cela est absorbé dans des modèles qui finissent par devenir des produits qui valent des milliards.
Et d’une manière ou d’une autre, tout le monde a fini par accepter que c’est normal.
Peut-être parce que les systèmes sont devenus trop grands pour être remis en question. Peut-être parce que les entreprises qui les construisent vont plus vite que la réglementation. Peut-être parce que personne ne pouvait raisonnablement retracer l’attribution une fois que les modèles atteignent une certaine échelle.
Cette dernière partie compte.
Pendant des années, l’un des plus gros problèmes de l’IA, c’est l’attribution elle-même. Une fois qu’un modèle s’entraîne sur suffisamment de données, retracer l’influence devient flou. Le tout se transforme en boîte noire. Une boîte noire utile parfois, mais quand même une boîte noire.
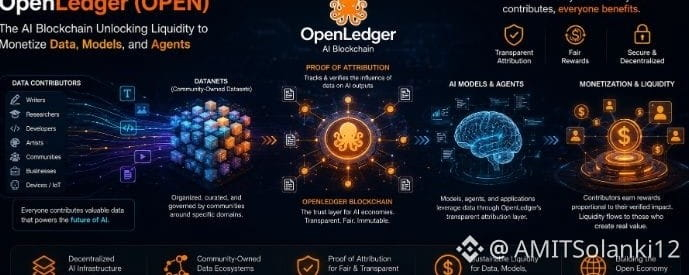
C’est la partie autour de laquelle OpenLedger revient constamment avec cette idée de Proof of Attribution.
Le concept sonne presque trop ambitieux quand on le lit pour la première fois. Le protocole essaie de relier les sorties du modèle aux données qui les ont influencées, puis de récompenser les contributeurs proportionnellement via le réseau.
J’ai déjà vu la crypto tenter des choses similaires auparavant, sous des formes différentes. Des royalties musicales. Des économies de créateurs. Des incitations au stockage. Des marchés de l’attention. Des marketplaces de données.
La plupart d’entre eux finissaient par se heurter au même mur : mesurer une contribution de manière significative est brutalement difficile.$OPEN