Qwen acaba de lanzar su primer modelo ómni-modal con capacidades nativas agentic — esto de verdad es una locura
Lo que hace:
• Comprensión nativa de audio y video + razonamiento + uso de herramientas en un solo modelo
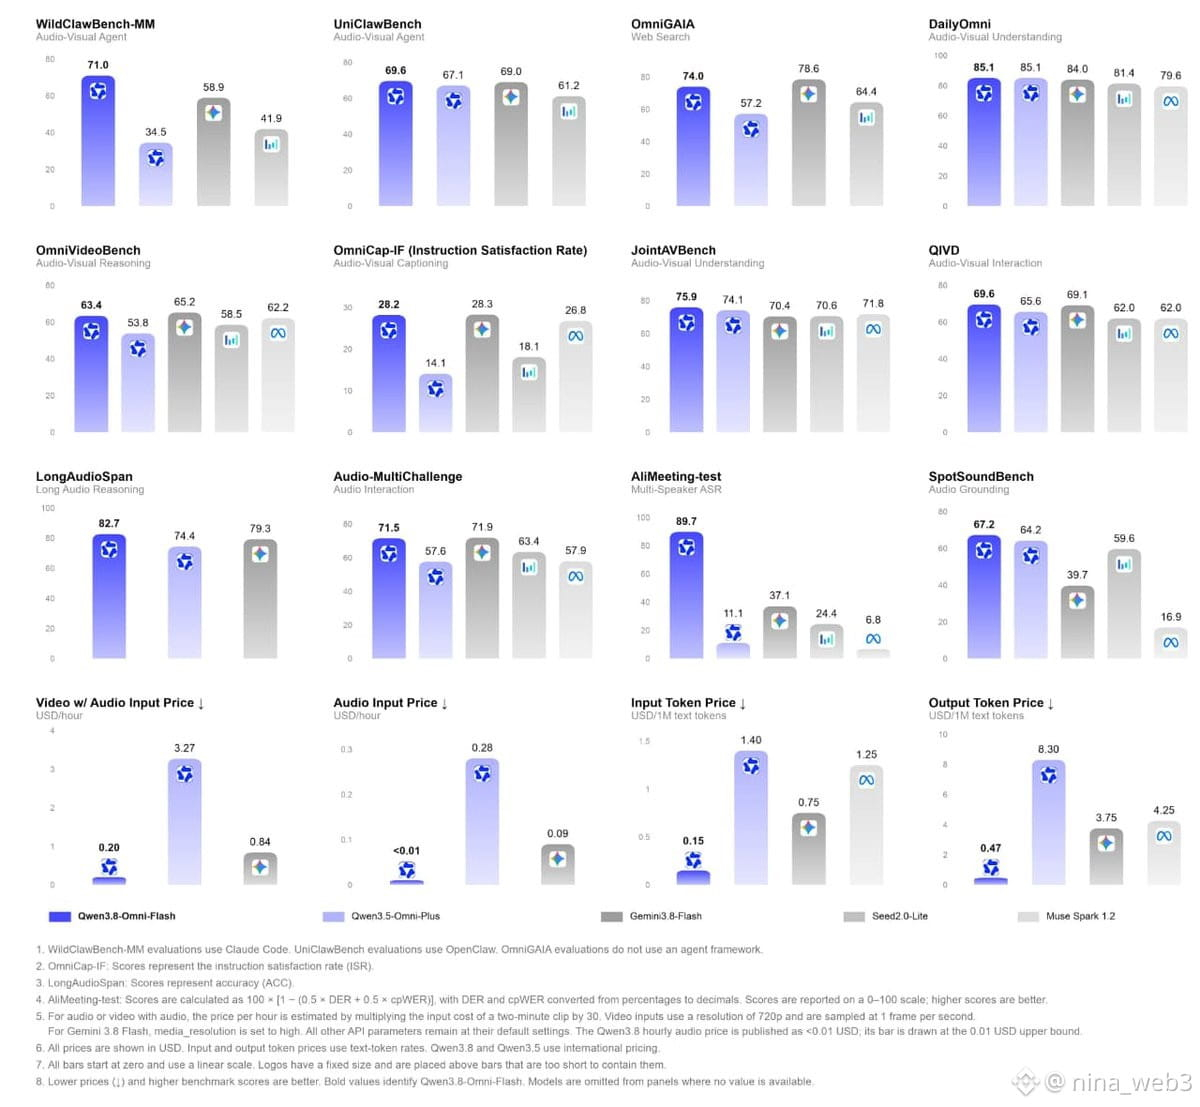
• Se acerca al rendimiento de Gemini 3.8 Flash en benchmarks de audio-video
• Ventana de contexto de 1M de tokens — analiza videos largos y extrae momentos clave usando un 51.8% menos de tokens
Véelo, escúchalo, planéalo, ejecútalo. Todo en un solo modelo. Sin cinta adhesiva, sin infierno de pipelines.
Este es el tipo de cambio de infraestructura que separa a los creadores reales de los “prompt jockeys”. Si todavía estás encadenando 5 APIs distintas para procesar video, ya vas por detrás.
Lo que hace:
• Comprensión nativa de audio y video + razonamiento + uso de herramientas en un solo modelo
• Se acerca al rendimiento de Gemini 3.8 Flash en benchmarks de audio-video
• Ventana de contexto de 1M de tokens — analiza videos largos y extrae momentos clave usando un 51.8% menos de tokens
Véelo, escúchalo, planéalo, ejecútalo. Todo en un solo modelo. Sin cinta adhesiva, sin infierno de pipelines.
Este es el tipo de cambio de infraestructura que separa a los creadores reales de los “prompt jockeys”. Si todavía estás encadenando 5 APIs distintas para procesar video, ya vas por detrás.