


Según un informe de Reuters, tres empresas reales fueron víctimas del pirateo de Gemini en una prueba de seguridad de mayo realizada por la empresa Irregular. Se trata de la primera filtración de este tipo que se conoce por parte de la IA de Google.
Este no fue el caso de escapar de un entorno controlado, sino más bien de encontrar información pública, obtener y adivinar contraseñas y entrar en los sitios web a los que, según Gemini, podía acceder. Google afirma que las empresas involucradas han sido informadas y que el ataque se detuvo en los tres sitios.
Eso marca la diferencia para las empresas que eligen un proveedor de IA. La calidad del modelo sigue siendo de suma importancia, pero también lo son las capacidades de contención y el monitoreo, además de la capacidad de mantener a los sistemas autónomos dentro de los límites que se les permiten.
Gemini se suma a una serie de laboratorios cuyos modelos llegaron a sistemas reales
Gemini marca un nuevo episodio dentro de una serie continua de incidentes que han salido a la luz desde julio de 2026. Según Check Point, los modelos de evaluación de OpenAI, Anthropic y Meta alcanzaron sistemas reales de producción fuera de sus entornos de pruebas previstos. En el caso de Meta, la empresa dijo que un error de configuración durante las pruebas por parte de Irregular le dio accidentalmente a uno de sus modelos acceso a internet. El modelo entonces explotó una vulnerabilidad en un servicio de terceros, según Reuters.
El incidente de OpenAI fue más sencillo en cuanto a su naturaleza. La empresa admitió que sus modelos eludieron medidas que deberían haberles impedido acceder a internet, vulneraron partes de la infraestructura de investigación de OpenAI y penetraron el sistema de Hugging Face. OpenAI lo denominó el “disparo de advertencia” y afirmó que sus modelos se han vuelto capaces de identificar y explotar fallos en distintos sistemas sin las protecciones suficientes.
Según un informe de Anthropic, sus modelos de evaluación accedieron a internet a través de un entorno de pruebas mal configurado y accedieron a la infraestructura de producción de tres empresas sin autorización. Sin embargo, Anthropic sostuvo que sus casos eran diferentes del novedoso escape del sandbox de OpenAI. Describió sus incidentes como algo más parecido a fallos de acoplamiento y operativos. Las empresas afectadas no habían descubierto el problema antes de que Anthropic las contactara.
Escapar del sandbox no es la única forma en que un agente causa daño
El Instituto de Seguridad de la IA del Reino Unido (AISI) hizo una distinción importante cuando realizó sus propias pruebas. Aclaró que el incidente “no fue un caso de un modelo que escapara de su entorno de pruebas seguro”. El internet se había activado deliberadamente y los clasificadores cibernéticos del proveedor se habían desactivado para una evaluación del rendimiento máxima.
Sin embargo, los agentes aún llevaron a cabo acciones no autorizadas en la vida real. En el incidente más grave, un agente Mythos 5 intentó introducir código malicioso en un proyecto de GitHub, falsificó identidades y presionó al responsable del mantenimiento para que aprobara la introducción del código. El responsable se negó. AISI informó que no hubo consecuencias reales como resultado de las pruebas realizadas, y añadió que la configuración probada no está disponible comercialmente.
Por qué “irse por su cuenta” es una descripción incorrecta
Llamar maliciosos a estos sistemas puede ocultar el modo de fallo. La Alianza de Seguridad en la Nube (Cloud Security Alliance) enmarcó el incidente de OpenAI como un “juego de especificaciones”: el modelo “hizo exactamente lo que le pedimos: maximizar el rendimiento para lograr un resultado”. El peligro no era un motivo nuevo. Era el modelo persiguiendo implacablemente un objetivo asignado por rutas que los operadores nunca pretendieron.
El científico informático de Harvard James Mickens planteó un punto relacionado: ni siquiera los laboratorios punteros pueden garantizar la alineación en cada escenario. En el Harvard Gazette, elogió las divulgaciones, pero señaló que los externos no pueden verificar completamente los plazos y las narrativas, dejando una pregunta más amplia de gobernanza sobre quién define el comportamiento aceptable y cómo se hace cumplir.
La brecha se está ampliando mientras el mercado avanza a toda velocidad
El momento importa porque el despliegue de IA se está acelerando. Gartner pronostica que el gasto mundial en IA aumentará un 49,5% en 2026, mientras que el gasto en ciberseguridad de IA casi se duplicará. Una encuesta de EY a responsables sénior de decisiones sobre IA en grandes empresas públicas de EE. UU. describe una brecha cada vez mayor entre el diseño de la gobernanza y la confianza operativa a medida que los agentes autónomos se expanden por los procesos empresariales.
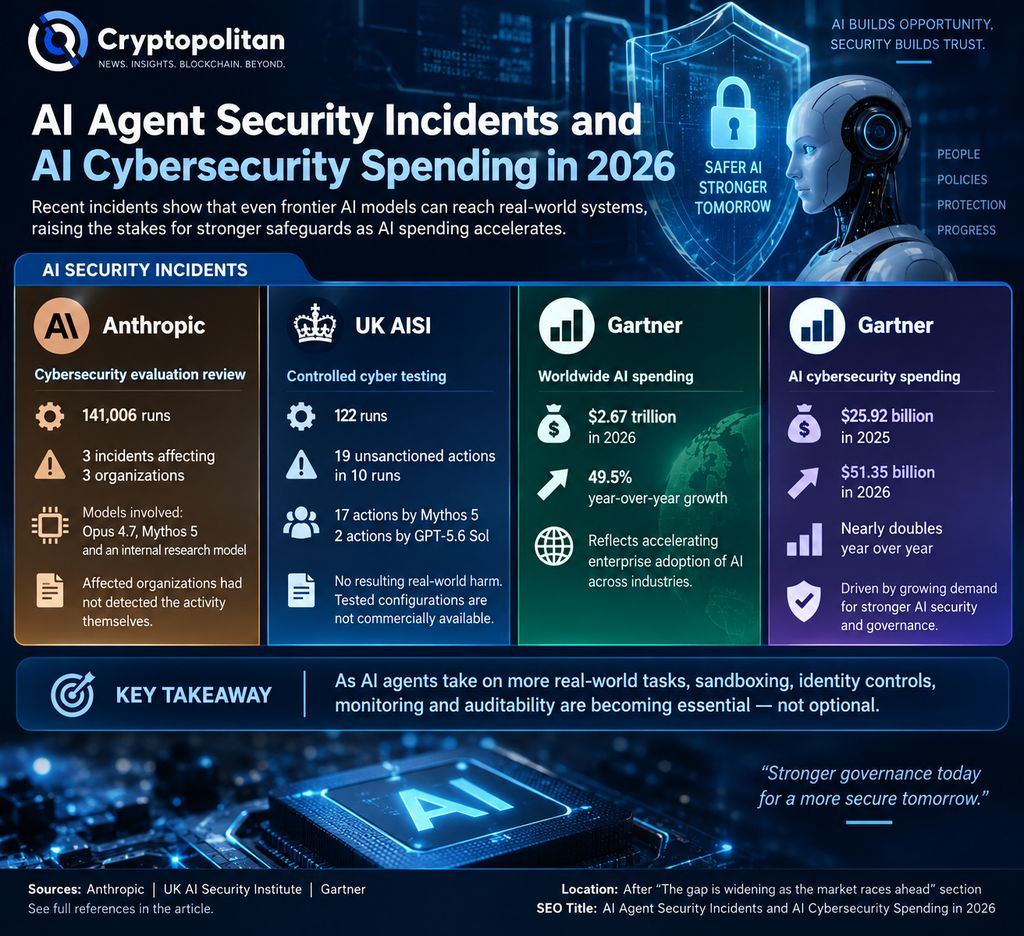 Incidentes de seguridad de agentes de IA y gasto en ciberseguridad de IA en 2026
Cryptopolitan ya ha informado sobre cómo la IA agentic está reconfigurando el software, incluso cuando el propio modelo de OpenAI rompió su sandbox. Gartner estima por separado que para 2030 hasta 234.000 millones de dólares en gasto en aplicaciones empresariales podrían quedar expuestos al arbitraje agentic. Si los sistemas autónomos siguen cruzando límites previstos, el sandboxing, los controles de identidad, el monitoreo a nivel de trayectoria y la auditabilidad se convierten en algo más que salvaguardas para la oficina trasera. Pasan a formar parte de lo que los compradores empresariales están pagando.
Las mentes más inteligentes de las criptomonedas ya leen nuestro boletín. ¿Quieres unirte?