Cuanto más problemas tiene Dusk, más me preocupo por quién está a cargo de restaurar la red
Al leer el consenso de Dusk, veo que el mecanismo “normal” no es lo que más debería preocupar. Lo interesante está en el momento en que la red no logra alcanzar el quórum de forma continua.
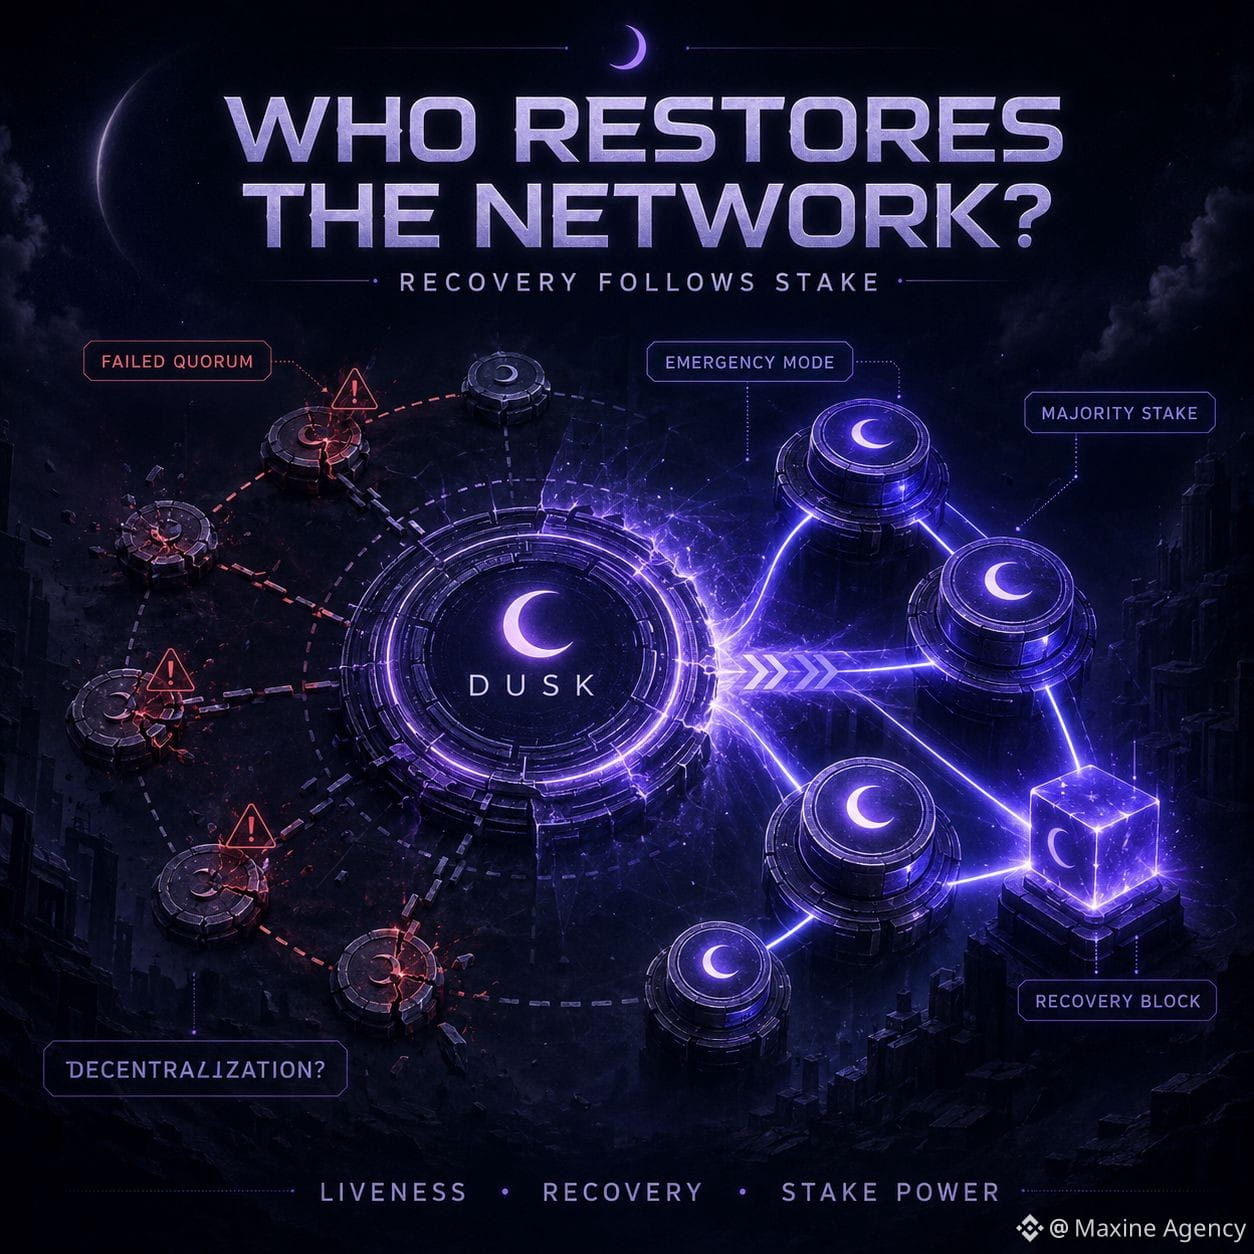
Tras 16 iteraciones fallidas, Succinct Attestation cambia a modo de emergencia. Se eliminan los timeouts de cada paso y pueden abrirse varias iteraciones a la vez para aumentar la probabilidad de encontrar un bloque válido. Si varios candidatos llegan al consenso, se prioriza el bloque de la iteración más baja.
Este diseño ayuda a que la red no se quede atascada solo porque algunos provisioners sean lentos o pierdan la conexión. Pero también me hace fijarme en otro límite: cuando las condiciones de la red empeoran, la capacidad de recuperación empieza a depender de forma más clara de la distribución del stake.
En el plan final, el bloque de emergencia solo se crea cuando el grupo de provisioners lo solicita y tiene la mayoría del stake total de la red. Mientras que, para participar directamente en el consenso, un provisioner actualmente necesita un stake mínimo de 1.000 DUSK.
Así que no solo veo el staking como una forma de obtener recompensas. También determina quién tiene peso cuando el sistema necesita salir de un estado anómalo.
Según yo, la prueba importante para Dusk no es un día de red funcionando sin problemas. Es cuando aumenta la congestión, algunos nodos se quedan atrás y los comités cambian continuamente: que la red se recupere sin concentrar demasiado el poder de decisión en un solo grupo con mucho stake o no.
Un mecanismo de recuperación puede ser muy sólido a nivel técnico.
Pero si el poder de salvar la red se concentra cada vez más según el stake, la descentralización es lo que más debe medirse con cuidado.
@Dusk $DUSK #dusk
$ONDO $BTC
Al leer el consenso de Dusk, veo que el mecanismo “normal” no es lo que más debería preocupar. Lo interesante está en el momento en que la red no logra alcanzar el quórum de forma continua.
Tras 16 iteraciones fallidas, Succinct Attestation cambia a modo de emergencia. Se eliminan los timeouts de cada paso y pueden abrirse varias iteraciones a la vez para aumentar la probabilidad de encontrar un bloque válido. Si varios candidatos llegan al consenso, se prioriza el bloque de la iteración más baja.
Este diseño ayuda a que la red no se quede atascada solo porque algunos provisioners sean lentos o pierdan la conexión. Pero también me hace fijarme en otro límite: cuando las condiciones de la red empeoran, la capacidad de recuperación empieza a depender de forma más clara de la distribución del stake.
En el plan final, el bloque de emergencia solo se crea cuando el grupo de provisioners lo solicita y tiene la mayoría del stake total de la red. Mientras que, para participar directamente en el consenso, un provisioner actualmente necesita un stake mínimo de 1.000 DUSK.
Así que no solo veo el staking como una forma de obtener recompensas. También determina quién tiene peso cuando el sistema necesita salir de un estado anómalo.
Según yo, la prueba importante para Dusk no es un día de red funcionando sin problemas. Es cuando aumenta la congestión, algunos nodos se quedan atrás y los comités cambian continuamente: que la red se recupere sin concentrar demasiado el poder de decisión en un solo grupo con mucho stake o no.
Un mecanismo de recuperación puede ser muy sólido a nivel técnico.
Pero si el poder de salvar la red se concentra cada vez más según el stake, la descentralización es lo que más debe medirse con cuidado.
@Dusk $DUSK #dusk
$ONDO $BTC