He ejecutado suficiente infraestructura como para saber que el verdadero costo no es la caída en sí, sino lo que haces después.
Cuando un nodo de Dusk se desconecta o se sale de sincronía, te enfrentas a dos caminos.
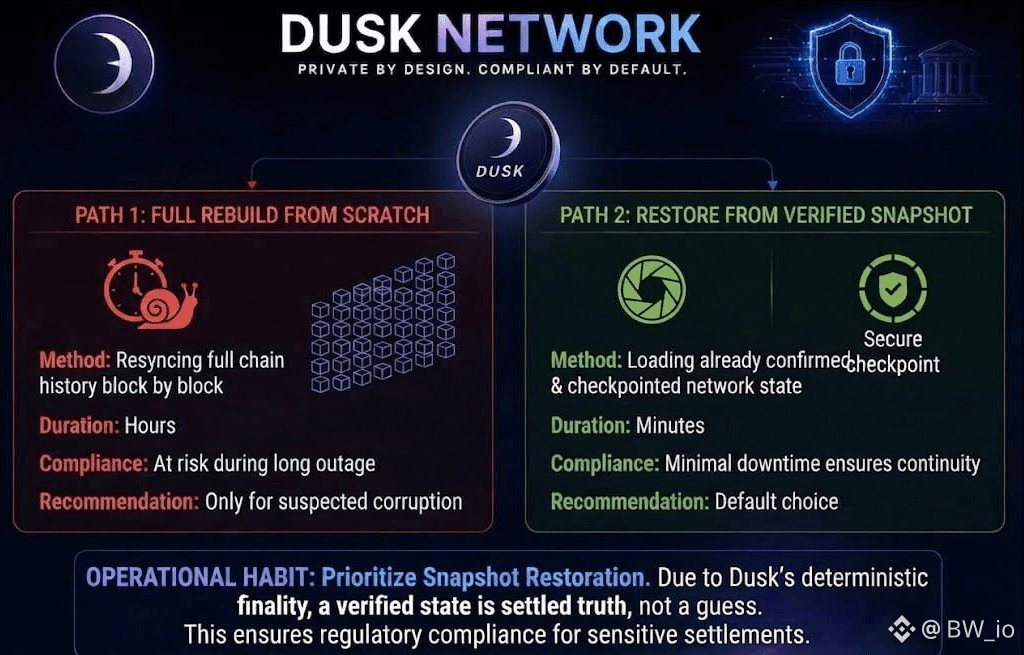
Puedes reconstruir desde cero, resincronizando todo el historial de la cadena bloque por bloque; es seguro, pero lento y te consume horas que no tienes durante un incidente. O puedes restaurar desde una instantánea de estado verificada, que ya fue marcada como punto de control y confirmada frente al consenso de la red, y volver a estar en línea en una fracción del tiempo.
Yo me inclino por el segundo camino cada vez, porque la finalización determinista de Dusk significa que un estado verificado no es una suposición: es una verdad ya asentada sobre la que el protocolo ya acordó.
Eso importa más aquí que en la mayoría de las cadenas, ya que estos nodos a menudo están respaldando liquidaciones reguladas, no solo transacciones de gas. La indisponibilidad en una red que mueve valores reales no es solo una molestia: es una cuestión de cumplimiento.
Así que el hábito operativo que recomendaría es sencillo: no trates la restauración desde instantáneas como un atajo, trátala como el comportamiento predeterminado, y reserva las reconstrucciones completas para cuando realmente sospeches corrupción.
Es una elección operativa pequeña, pero es la diferencia entre minutos de indisponibilidad y horas.
@Dusk #dusk $DUSK $GPS $STAR
Cuando un nodo de Dusk se desconecta o se sale de sincronía, te enfrentas a dos caminos.
Puedes reconstruir desde cero, resincronizando todo el historial de la cadena bloque por bloque; es seguro, pero lento y te consume horas que no tienes durante un incidente. O puedes restaurar desde una instantánea de estado verificada, que ya fue marcada como punto de control y confirmada frente al consenso de la red, y volver a estar en línea en una fracción del tiempo.
Yo me inclino por el segundo camino cada vez, porque la finalización determinista de Dusk significa que un estado verificado no es una suposición: es una verdad ya asentada sobre la que el protocolo ya acordó.
Eso importa más aquí que en la mayoría de las cadenas, ya que estos nodos a menudo están respaldando liquidaciones reguladas, no solo transacciones de gas. La indisponibilidad en una red que mueve valores reales no es solo una molestia: es una cuestión de cumplimiento.
Así que el hábito operativo que recomendaría es sencillo: no trates la restauración desde instantáneas como un atajo, trátala como el comportamiento predeterminado, y reserva las reconstrucciones completas para cuando realmente sospeches corrupción.
Es una elección operativa pequeña, pero es la diferencia entre minutos de indisponibilidad y horas.
@Dusk #dusk $DUSK $GPS $STAR