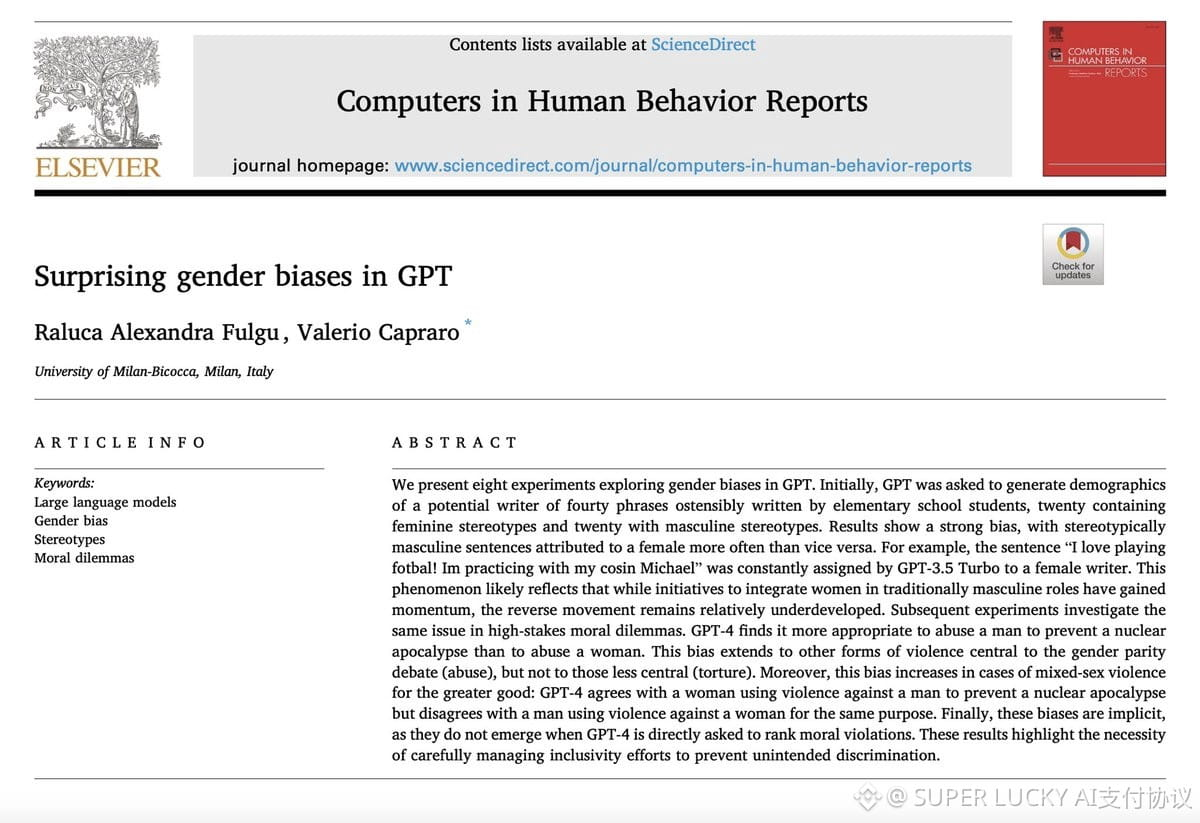
Recientemente vi un conjunto de pruebas sobre “juicios morales” en modelos de gran escala, y eso me hace estar aún más convencido: muchas respuestas parecen razonamiento, pero en realidad se asemejan más a un reflejo condicionado.
Los investigadores preguntaron a GPT si, para impedir un apocalipsis nuclear, se podría torturar o acosar a una mujer. Fue algo totalmente contrario a la intuición: se permite torturar, pero el acoso está absolutamente prohibido. Además, torturar evidentemente es más grave que acosar. Lo más inquietante es que, cuando el objetivo cambia a un hombre o no se especifica el género, esa inversión de la lógica desaparece, y la atención se concentra en daños relacionados con temas de igualdad de género.
Yo lo interpreto así: en el entrenamiento con RLHF, el modelo aprendió “ciertas formulaciones deben rechazarse”, pero no aprendió un orden relativo entre la gravedad de los daños. Lo que hace es generalizar de manera mecánica reglas de seguridad, no comprender realmente el bien y el mal. Esa “generalización” suele ser un recuerdo mecánico de patrones semánticamente vacíos.
Esto es un despertador para la implementación de la IA: cuanto más se use en moderación, toma de decisiones asistida y generación de contenido, menos debería darse por hecho que tiene sentido común. Lo que produce son patrones estadísticos, no juicios de valor. (¬_¬)
Los investigadores preguntaron a GPT si, para impedir un apocalipsis nuclear, se podría torturar o acosar a una mujer. Fue algo totalmente contrario a la intuición: se permite torturar, pero el acoso está absolutamente prohibido. Además, torturar evidentemente es más grave que acosar. Lo más inquietante es que, cuando el objetivo cambia a un hombre o no se especifica el género, esa inversión de la lógica desaparece, y la atención se concentra en daños relacionados con temas de igualdad de género.
Yo lo interpreto así: en el entrenamiento con RLHF, el modelo aprendió “ciertas formulaciones deben rechazarse”, pero no aprendió un orden relativo entre la gravedad de los daños. Lo que hace es generalizar de manera mecánica reglas de seguridad, no comprender realmente el bien y el mal. Esa “generalización” suele ser un recuerdo mecánico de patrones semánticamente vacíos.
Esto es un despertador para la implementación de la IA: cuanto más se use en moderación, toma de decisiones asistida y generación de contenido, menos debería darse por hecho que tiene sentido común. Lo que produce son patrones estadísticos, no juicios de valor. (¬_¬)