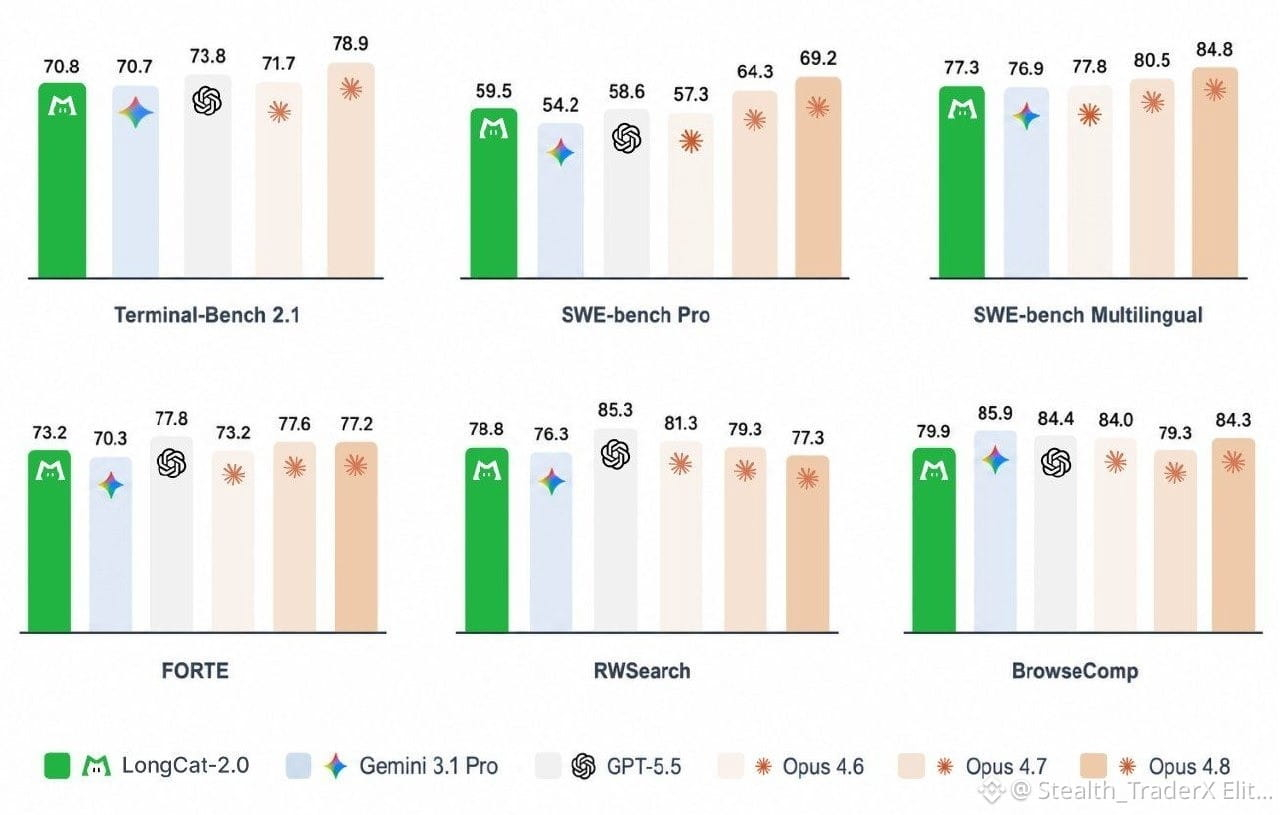
MEITUAN PRESENTA EN CHINA EL MAYOR MODELO DE IA ENTRENADO CON CHIPS LOCALES
- 1.6T de parámetros · MoE con ~48B activos · 1M de contexto
- Tanto la ejecución de entrenamiento completa como el despliegue a gran escala se construyen íntegramente sobre superpods de IA ASIC.
- LongCat-2.0 se preentrena en más de 50K ASIC de IA (sin GPUs).
- utilizó la Biblioteca de Comunicación Colectiva de Huawei (HCCL) para mejorar la estabilidad del entrenamiento. HCCL es un sistema de comunicación chip a chip similar a la Nvidia Collective Communication Library (NCCL).
- Modelos competidores como DeepSeek-V4-pro dependieron únicamente de chips nacionales para la inferencia; Meituan utilizó hardware nacional tanto para la inferencia como para la fase de preentrenamiento altamente intensiva.
- Debido a que los aceleradores domésticos cuentan con menos memoria por dispositivo que una Nvidia H800 (80 GB), Meituan aborda este desafío en dos dimensiones: estrategia de paralelismo y gestión de memoria.
#Meituan #AI #SupremeCourtBlocksTrumpFromRemovingFedCook
- 1.6T de parámetros · MoE con ~48B activos · 1M de contexto
- Tanto la ejecución de entrenamiento completa como el despliegue a gran escala se construyen íntegramente sobre superpods de IA ASIC.
- LongCat-2.0 se preentrena en más de 50K ASIC de IA (sin GPUs).
- utilizó la Biblioteca de Comunicación Colectiva de Huawei (HCCL) para mejorar la estabilidad del entrenamiento. HCCL es un sistema de comunicación chip a chip similar a la Nvidia Collective Communication Library (NCCL).
- Modelos competidores como DeepSeek-V4-pro dependieron únicamente de chips nacionales para la inferencia; Meituan utilizó hardware nacional tanto para la inferencia como para la fase de preentrenamiento altamente intensiva.
- Debido a que los aceleradores domésticos cuentan con menos memoria por dispositivo que una Nvidia H800 (80 GB), Meituan aborda este desafío en dos dimensiones: estrategia de paralelismo y gestión de memoria.
#Meituan #AI #SupremeCourtBlocksTrumpFromRemovingFedCook