Déjame contarte cómo empecé con OpenLedger y por qué tuve que replantear completamente mi lectura inicial.
Cuando lo miré por primera vez, mi instinto fue simple. Las empresas de IA tomaban datos sin pagar. OpenLedger construye la infraestructura para compensar a los contribuyentes. Compensación justa, atribución en cadena, flujos de pago automáticos. Una historia clara. Fácil de entender.
Pasé dos semanas pensando que esa era toda la tesis.
Luego empecé a tirar de un hilo que cambió todo.
La narrativa de los pagos es real. Pero no es lo más importante que OpenLedger está resolviendo.
Esto es lo que quiero decir.
He pasado por suficientes ciclos de tecnología empresarial para saber cómo funciona realmente la adopción institucional. No sucede porque alguien publique un whitepaper sobre justicia. No ocurre porque el modelo de compensación sea elegante. Las empresas se mueven cuando su asesor legal les dice que el costo de no hacerlo supera el costo de cambiar.
Así que empecé a hacer una pregunta diferente.
No "¿quién se beneficia de la compensación justa de datos?"
Sino "¿quién está a punto de ser demandado si no puede responder preguntas básicas sobre sus datos de entrenamiento en la fase de descubrimiento?"
La respuesta a esa pregunta es una lista muy larga de empresas muy grandes.
Piensa en lo que realmente está sucediendo en la litigación de IA en este momento.
El caso del New York Times contra OpenAI no se trata realmente de dinero. Se trata de descubrimiento. Cuando llegue a juicio, los abogados harán preguntas muy específicas. ¿Qué artículos se utilizaron? ¿Cuántas veces? ¿Qué peso tuvieron en el entrenamiento? ¿Se violaron los términos de licencia?
Esas preguntas requieren respuestas. Y las empresas que no pueden responderlas claramente y que genuinamente no saben qué datos entrenaron sus modelos o de dónde vinieron enfrentan un tipo diferente de exposición que las empresas que pueden producir una cadena de atribución verificable.
Aquí es donde OpenLedger deja de ser una historia de "pagar a los creadores de manera justa" y se convierte en algo más estructuralmente importante.
La Prueba de Atribución es una infraestructura de procedencia. Crea un registro criptográfico de qué datos se usaron, cómo influyeron en los resultados del modelo y quién los contribuyó. Ese registro no solo es útil para pagar a los contribuyentes.
Es una defensa legal.
Quiero ser honesto sobre algo que me tomó un tiempo asimilar.
Las empresas que más necesitan esto son las mismas que son más resistentes a adoptarlo.
OpenAI, Google, Anthropic, Meta — estas empresas tienen equipos legales diseñados específicamente para argumentar que sus prácticas de datos actuales son defendibles. No van a adoptar voluntariamente la infraestructura de atribución que aumenta su estructura de costos y crea registros explícitos de lo que hicieron con los datos de entrenamiento.
La adoptarán cuando los tribunales les digan que deben hacerlo. O cuando los reguladores impongan la divulgación. O cuando los costos legales de la opacidad superen los costos operativos de la transparencia.
Ese momento aún no ha llegado.
Pero he visto suficientes ciclos regulatorios para saber cómo terminan. Lento, luego de golpe. La industria del tabaco luchó durante décadas. Luego ya no lo hizo.
La pregunta para $OPEN no es si ese momento llegará.
Es si OpenLedger está operativo, probado e integrado en suficientes flujos de trabajo antes de que eso suceda, para que cuando las empresas se vean obligadas a moverse, haya un lugar creíble al que puedan ir.
Esto es lo que observo ahora en lugar del precio del token.
Pilotos empresariales. No anuncios, pilotos reales donde una organización real está probando la infraestructura de atribución en un flujo de trabajo real.
Consultas del equipo legal. Cuando los procesos de adquisición de las empresas de IA comiencen a incluir "verificación de procedencia de datos" como un requisito, esa es la señal.
Lenguaje regulatorio. Cada vez que la ley de IA de la UE o la legislación de EE. UU. usa palabras como "procedencia verificable" o "datos de entrenamiento auditables", ese es un viento a favor que no le importa los ciclos del mercado cripto.
Ninguna de esas señales está gritando todavía.
Pero están murmurando. Y en infraestructura, los murmullos tienden a convertirse en rugidos más rápido de lo que nadie espera.
Estoy posicionado para observar. No estoy completamente convencido de que suceda en la línea de tiempo que requieren las economías de tokens de $OPEN. Pero estoy lo suficientemente convencido de que no puedo dejar de prestar atención.
¿Qué te haría sentir seguro de que la adopción empresarial de la infraestructura de atribución de IA está realmente sucediendo y no solo se está discutiendo?
@OpenLedger $OPEN #OpenLedger

Artículo
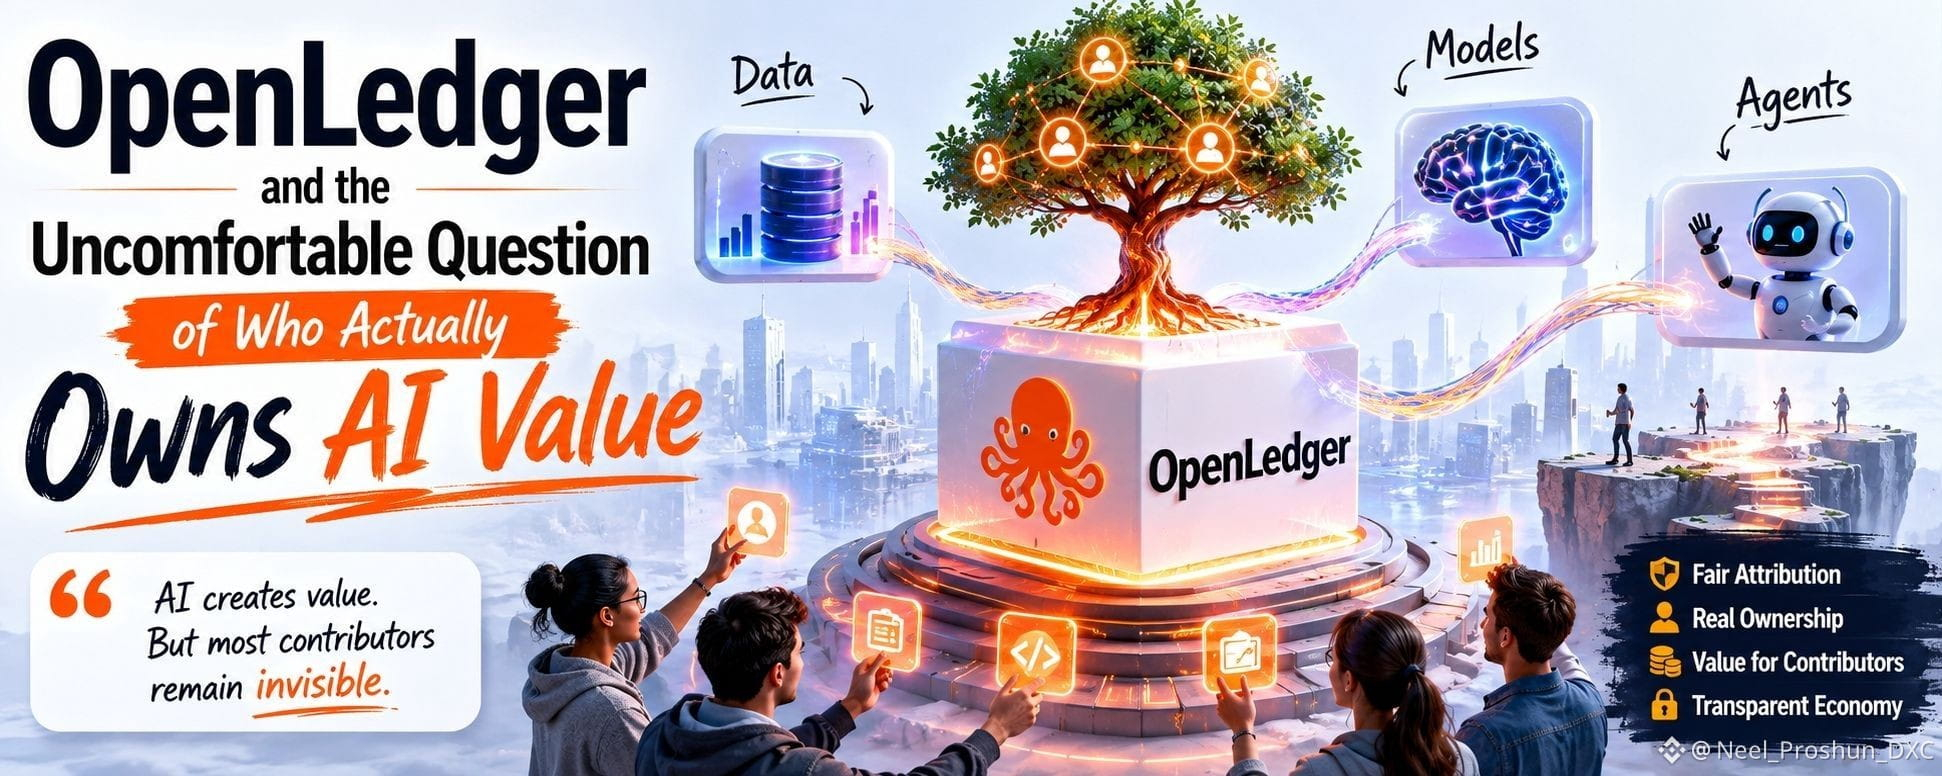
Solía pensar que OpenLedger se trataba de pagar a los creadores. Estaba equivocado sobre lo que realmente está resolviendo.
Aviso legal: Incluye opiniones de terceros. No es asesoramiento. Binance Ai puede utilizarse sin garantía. Consultar Términos y condiciones.