
Al organizar la computadora por la tarde, me detuve a revisar unas viejas notas de proyectos donde había hecho registros a mano de depuración de contratos inteligentes. Ahí había un montón de gráficos de consumo de gas y estrategias para identificar fallos en la sincronización de estados en diferentes casos extremos, y no pude evitar reírme un poco. En estos años, he alimentado muchas experiencias prácticas y datos en diversas herramientas para validar mis ideas, y me di cuenta de que la verdadera experiencia valiosa a menudo es fácilmente cosechada en plataformas centralizadas, mientras que los contribuyentes tienen dificultades para obtener una recompensa justa. Esta experiencia me llevó a ser más cauteloso con los proyectos que afirman querer reestructurar el valor de los datos.
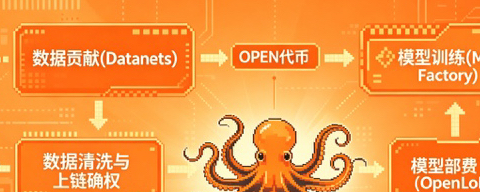
Es justamente con esa mentalidad que últimamente el “cárter” ha puesto su atención en OpenLedger, un proyecto que se menciona cada vez más dentro de la comunidad. Al principio no tenía grandes expectativas, porque he visto demasiadas propuestas con la etiqueta de “IA” que solo hacían trabajo superficial. Pero cuando invertí algunos días en leer con seriedad @OpenLedger su código central de protocolo, y especialmente ese módulo de red descentralizada de datos llamado Datanets, descubrí que realmente están intentando una ruta bastante pragmática: llevar el flujo de valor del proceso de inferencia de IA a una liquidación verificable, asentada de forma comprobable en la cadena de bloques.
El mecanismo de “payable AI” que proponen: su núcleo consiste en una combinación de identificadores cifrados y un diseño modular de contratos, de modo que cada llamada al modelo, cada contribución de datos o cada aporte de potencia de cómputo pueda rastrearse con claridad y reciba la compensación correspondiente. Imagina que un desarrollador sube a la red un módulo de extracción de características propietario que ya entrenó. Luego, si un equipo de cuantificación llama a ese módulo para ayudar a juzgar el mercado, el protocolo subyacente, según los pesos de contribución predefinidos, separa automáticamente los costos y los transfiere a las direcciones relevantes. En términos de ideología, el diseño es bastante limpio: intenta descentralizar la asignación que antes estaba totalmente monopolizada por grandes plataformas y devolvérsela a quienes aportan de verdad.
Desde la perspectiva de un ingeniero, #OpenLedger lo que más me gusta de esta arquitectura es su enfoque de descomposición modular. Datanets organiza de forma relativamente independiente la capa de datos, la capa de modelos y la capa de liquidación, lo que facilita iteraciones y mejoras parciales posteriores sin que, si falla algún eslabón, todo el sistema quede colapsado. Yo mismo, siguiendo la documentación, ejecuté varias veces en la testnet el flujo de llamadas extremo a extremo; la curva de entrada no es baja, pero la lógica es razonablemente clara. Para quienes tienen experiencia con solidity y sistemas distribuidos, en uno o dos días se puede montar la interacción básica. Y una vez que se ejecuta realmente, el rendimiento en latencia y costos también resulta más estable de lo que yo esperaba. Claro, esto solo es una prueba a pequeña escala; en escenarios reales con alta concurrencia habrá que observar durante más tiempo. $OPEN
Pero también lo entiendo: cualquier intento de este tipo no puede eludir los desafíos reales de ingeniería. Depender en gran medida de un mecanismo de liquidación en tiempo real on-chain; al enfrentarse a tareas de IA multimodales y a gran escala con alta concurrencia, la latencia de red y la presión por sincronización de nodos se amplificarán rápidamente. Yo ya he sufrido en otras cadenas de bloques en periodos de carga alta: cuando había demoras de confirmación frecuentes y una volatilidad repentina de costos, se rompían directamente muchos flujos de automatización que habían sido diseñados. Si Datanets no puede seguir iterando de forma constante en la expansión de nodos y en la optimización por fragmentación (sharding), este riesgo podría hacer que algunos usuarios sientan que es incluso menos confiable que los servicios centralizados tradicionales. $BTC
Además, en su red, por ahora, los tipos de datos que circulan están bastante concentrados: principalmente giran en torno a registros estructurados relacionados con las finanzas y a parte de conjuntos de entrenamiento públicos. Esto, sin duda, permite que las validaciones tempranas sean más enfocadas, pero también significa que todavía hay una distancia considerable para soportar aplicaciones de IA verdaderamente diversas entre industrias. Si el ecosistema de desarrolladores no puede enriquecerse rápidamente, y si no se siguen inyectando datos nuevos de alta calidad, todo el ciclo de distribución de valor puede terminar atrapado en una dinámica de baja actividad, convirtiéndose en un circuito de autosuficiencia entre unos pocos nodos.
A pesar de estos posibles problemas, sigo manteniendo un reconocimiento cauteloso hacia este rumbo. Recuperar el poder de fijación de precios del lado de la oferta de IA de manos de unos pocos gigantes, y bajar con tecnología blockchain el umbral para que los desarrolladores comunes puedan monetizar sus recursos únicos, por sí mismo merece un intento serio. Al menos les ofrece una nueva ruta posible a quienes tienen conjuntos de datos más nicho o modelos optimizados.
En los próximos meses, planeo seguir observando como observador su actividad real en la cadena: el número de llamadas efectivas a los contratos inteligentes, la curva de crecimiento de direcciones de carga de datos independientes dentro de la red Datanets y la estabilidad de la liquidación entre módulos. Estos datos serán más honestos que cualquier whitepaper. Cuando termine el periodo de observación, decidiré en función del desempeño real si debo dedicarles más tiempo y esfuerzo. En general, mantengo un optimismo contenido hacia estas exploraciones que ponen la intención técnica en el código: no porque suene tan revolucionario, sino porque no evita la complejidad del mundo real en los detalles de ingeniería.