
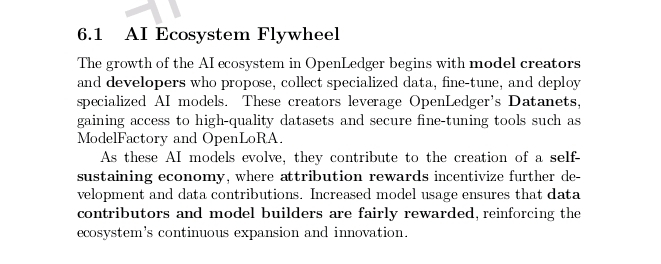

Hermanos, escuchen lo que les digo. La semana pasada hice una locura. Resulta que solicité participar como nodo validador en OpenLedger. No un nodo grande, sino de esos donde los pequeños traders podemos participar. Me encargan de revisar la calidad de salida del modelo. Cada vez que el modelo realiza una ronda de inferencia, el sistema selecciona aleatoriamente algunos resultados y los validadores los puntúan. Si tu juicio coincide con el de la mayoría, recibes una recompensa. Si te pasas de la raya, te descuentan de tu staking de@OpenLedger .
Pensé, ¿qué tan difícil puede ser esto? Si el modelo es bueno o no, se ve a simple vista. Así que hice staking de un poco de dinero y empecé feliz a aceptar tareas.
La primera tarea era generar comentarios de código. La salida del modelo estaba bastante bien, así que le di una puntuación aceptable. Después de enviar mi calificación, me di cuenta de que la puntuación promedio de los demás era un poco más alta que la mía. Me dio un vuelco el corazón, pero no le presté mucha atención. Luego llegó la segunda tarea. La pregunta era: "¿cómo determinar si una dirección es un contrato inteligente?" La respuesta que dio el modelo fue que solo había que mirar el saldo. Eso es claramente incorrecto. Sin dudarlo, le di cero puntos y escribí un comentario diciendo que esa respuesta podría llevar a confusión.
El segundo día, cuando abrí el panel, vi que me habían descontado el valor de unas buenas tandas de “barbacoa” con$OPEN . En ese momento me quedé en blanco.
Al leer bien las explicaciones del descuento me di cuenta de esto: en el conjunto de datos de entrenamiento de ese modelo hay un patrón especial de interacción on-chain. Bajo ese tipo de patrón, efectivamente el saldo puede ayudar a la hora de juzgar. Aunque el modelo no aclaró bien las condiciones previas, el sistema consideró que su respuesta “es válida parcialmente en un contexto específico”, así que no debería haber recibido cero puntos.
Fue entonces cuando lo entendí: cuando eres validador en OpenLedger, no estás “adivinando” por puro sentido común, sino que debes comprender los límites del entrenamiento del modelo. En qué conjunto de datos se afinó, qué áreas domina, y qué limitaciones tiene. Ya está claro: no solo no gané dinero, además me tocó pagar una barbacoa. Fue tan doloroso como cuando hace años perdí dinero por jugar al principiante con mi primera compra de Bitcoin. Cuando Bitcoin te hace perder, al menos puedes consolarte pensando que fue volatilidad; esto, en cambio, es por falta de profesionalismo.
Luego me volví más listo: antes de aceptar una tarea, primero consulto la información básica de ese modelo, para ver cuál es el rango de datos con los que se entrenó y en qué tipo de problemas es bueno. Después, lo combino con los criterios de validación del documento, y voy puntuando punto por punto. Hice esto durante dos días. Poco a poco las recompensas fueron recuperando lo que antes me habían penalizado.
De paso, les cuento las lecciones que aprendí a la mala, para que mis hermanos no caigan en lo mismo. Primero: no asumas que lo sabes todo. La salida del modelo a veces acierta, pero no sabes por qué acierta. Segundo: si no estás seguro, el sistema te permite saltarte esa tarea; no te descuentan dinero. Tercero: mira con detenimiento los comentarios y los patrones de puntuación de los validadores excelentes; aprende de su lógica de juicio.
En pocas palabras, este mecanismo de OpenLedger entrega el control de la calidad del modelo a la comunidad: quien se toma las cosas en serio, cumple; quien vaga, también se nota. En la cadena queda claro de inmediato. Esto es distinto al consenso de “solo potencia de cálculo” de Bitcoin y Ethereum. Bitcoin depende de que los mineros calculen hashes; Ethereum depende del staking y el bloqueo de fondos. Pero en el consenso de OpenLedger hay un tercer eje: el criterio humano. Mi estrategia actual es aceptar únicamente tareas de validación de las áreas que conozco, por ejemplo, preguntas y respuestas sobre seguridad de blockchain o validación de formatos de datos. Las demás, las salto directamente. Prefiero no ganar nada antes que opinar sin fundamento.
La verdad, cuando me penalizaron me sentí bastante molesto. Pero ahora que lo pienso, esto hizo que me tomara en serio investigar el marco de validación de OpenLedger. Aprendí muchísimo más que solo leyendo la whitepaper.
Lo siguiente que planeo es preparar una nota sobre cómo validar y puntuar, y publicarla en la zona de discusión de la comunidad. Espero que ayude a los hermanos que están empezando. No repitan mis errores y caigan en el mismo pozo#OpenLedger