
 Una cosa que creo que el mercado todavía no entiende sobre la inteligencia artificial es que las empresas no están realmente optimizando para la inteligencia.
Están optimizando para la supervivencia.
Suena cínico hasta que ves cómo se toman realmente las decisiones tecnológicas en las empresas.
A las juntas no les importa si un modelo es filosóficamente impresionante. A los departamentos legales no les importa si la arquitectura es elegante. A los equipos de cumplimiento no les emociona despertarse pensando en benchmarks de razonamiento de frontera. La mayoría de las corporaciones, al final, se preocupan por una cosa:
¿Puede este sistema crear valor sin generar más tarde una exposición incontrolable?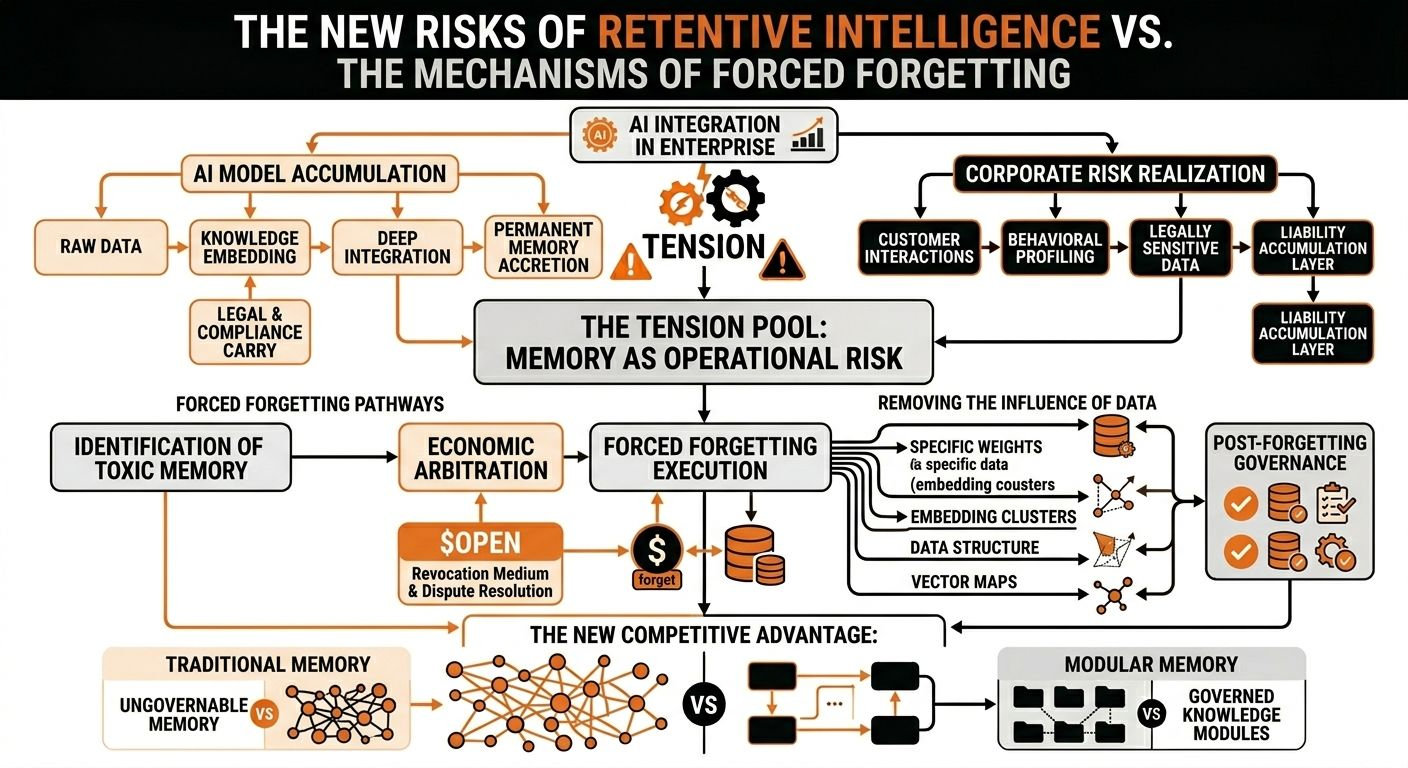
Por eso OpenLedger sigue volviéndose más interesante para mí cuanto más pienso en hacia dónde se dirige la IA empresarial.
La mayoría de las personas aún ve OpenLedger a través de la lente familiar de la IA descentralizada. Los contribuidores de datos, los sistemas de atribución, los Datanets, la coordinación del modelo, los incentivos de tokens mediante $OPEN. Bien. Esa interpretación a nivel superficial existe.
Pero cada vez más sospecho que la capa más importante es otra cosa totalmente distinta.
OpenLedger podría estar posicionándose de hecho alrededor de un futuro en el que la ignorancia selectiva se vuelva estratégicamente económica.
Porque ahora mismo el mercado de la IA sigue atrapado en una psicología de acumulación. Cada empresa cree que la ventaja competitiva proviene de retener la mayor cantidad de información posible. Más interacciones con clientes. Más patrones de comportamiento. Más registros históricos. Más contexto propietario.
El supuesto subyacente de esta estrategia es simple: más memoria equivale a mejor inteligencia.
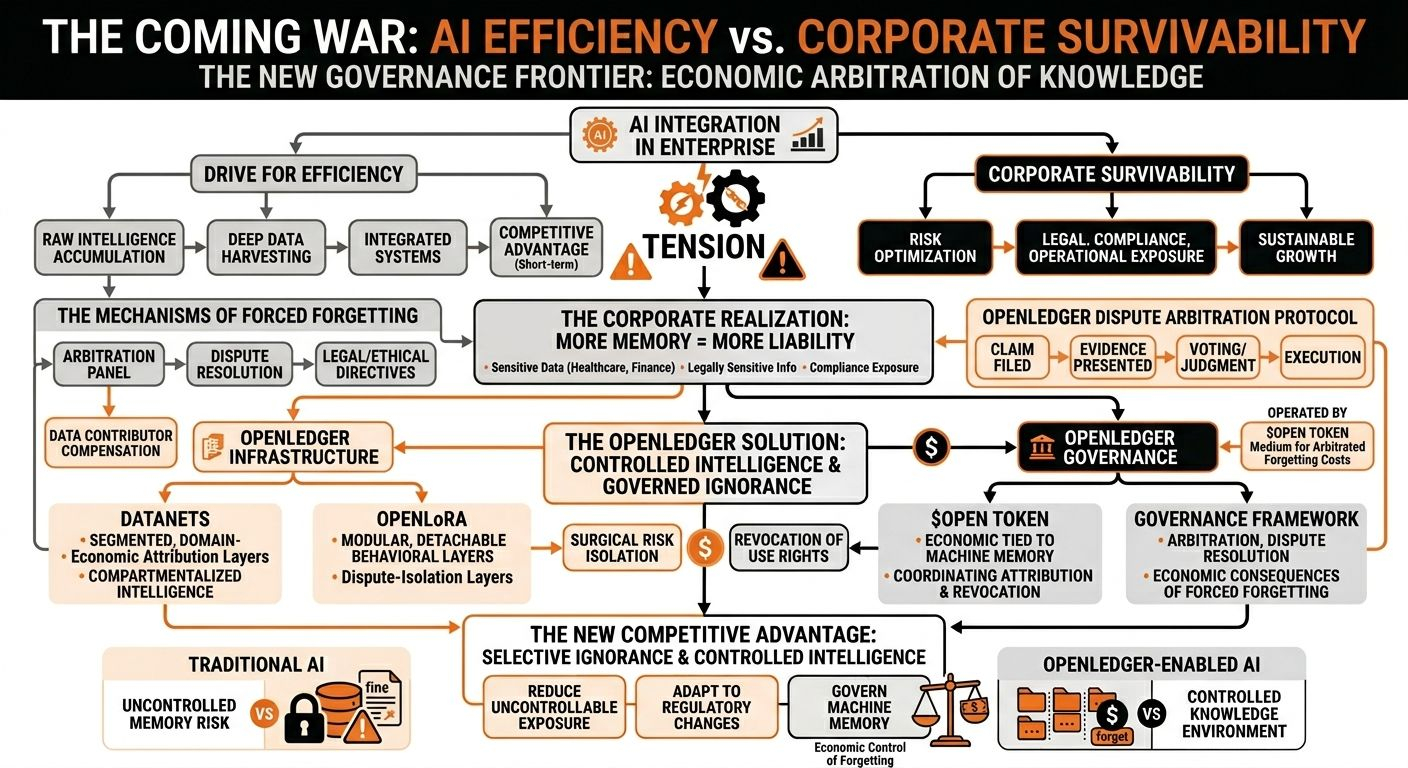
Pero esa lógica se rompe en silencio cuando la propia memoria empieza a generar riesgos legales, operativos y financieros más rápido de lo que genera valor.
Y honestamente, creo que muchas empresas están mucho más cerca de esa realidad de lo que entiende el mercado público.
En este momento, la mayoría de los sistemas corporativos de IA todavía operan en entornos relativamente controlados. Copilotos internos. Aumento de servicio al cliente. Automatización de flujos de trabajo. Soporte de analítica. Pero cuanto más se adentra la IA en industrias reguladas y en infraestructura crítica para la toma de decisiones, más peligrosa se vuelve la inteligencia retenida.
Porque la memoria corporativa no es neutral.
Un modelo de salud que retiene contexto sensible de diagnóstico no es solo “inteligente”. Está cargando con responsabilidad. Un sistema de asesoría financiera entrenado con años de datos de comportamiento de clientes no es solo personalizado. Está acumulando exposición al cumplimiento. Un agente empresarial que absorbe comunicaciones internas podría, sin querer, convertirse en un archivo permanente de información legalmente sensible.
Y la parte realmente incómoda es esta:
La mayoría de los sistemas de IA son, estructuralmente, terribles para olvidar de forma limpia.
Eso crea un futuro extraño en el que las empresas tal vez compitan cada vez menos sobre cuánto saben sus sistemas…
y más sobre qué tan precisamente pueden controlar lo que esos sistemas están autorizados a seguir sabiendo.
Esa distinción se siente muchísimo subvalorada ahora mismo.
Porque una vez que los datos quedan integrados en capas ajustadas (fine-tuned), sistemas de recuperación, espacios vectoriales y el propio comportamiento del modelo, la eliminación deja de funcionar como la eliminación tradicional de software. Las empresas están descubriendo poco a poco que “eliminar los datos” y “eliminar la influencia de los datos” son problemas de ingeniería completamente distintos.
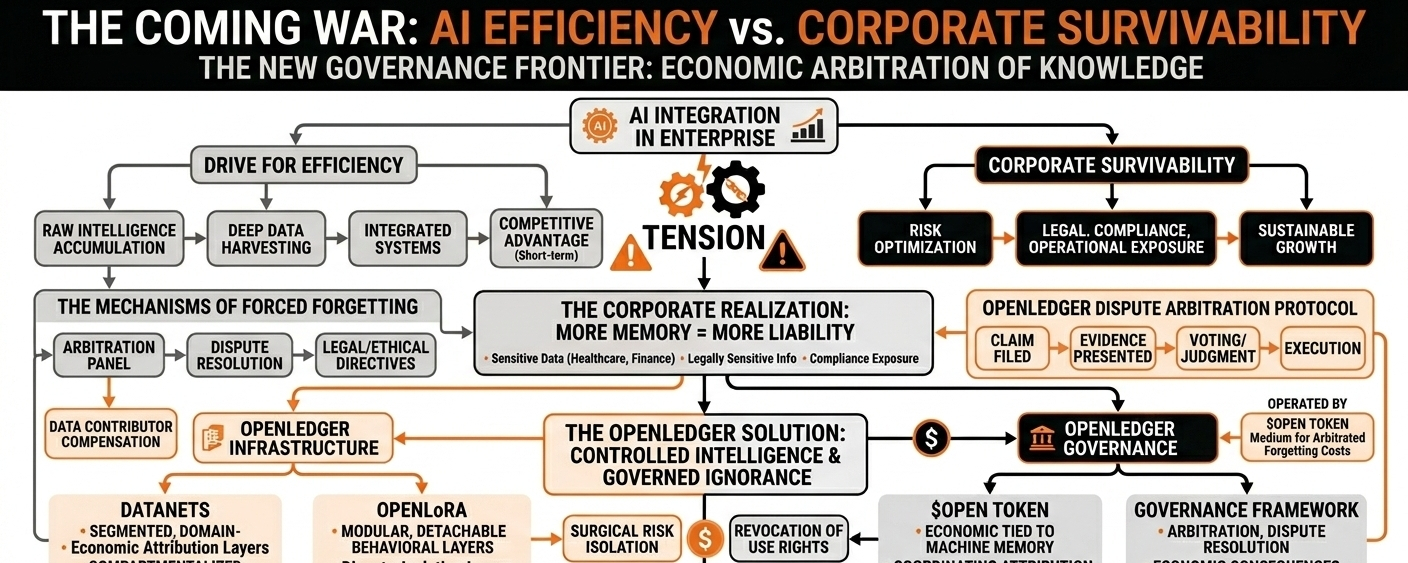
Ahí es donde OpenLedger empieza a parecerse menos a un mercado descentralizado de datos y más a infraestructura para la compartimentación del riesgo corporativo.
La arquitectura Datanet es interesante por esta razón exacta. En lugar de tratar la inteligencia como un único gran grupo de memoria indiferenciada, la estructura empuja hacia entornos de conocimiento segmentados y específicos del dominio, vinculados a la atribución y la rendición de cuentas económica.
A primera vista, eso suena ineficiente en comparación con la acumulación centralizada de IA a fuerza bruta.
A largo plazo, tal vez llegue a volverse operativamente necesario.
Porque la inteligencia compartimentada es más fácil de gobernar que la memoria generalizada permanente.
Eso también es por lo que OpenLoRA parece mucho más importante de lo que la mayoría de las personas se da cuenta ahora. El mercado tiende a enmarcarlo como una capa de eficiencia para desplegar adaptaciones ligeras de modelos de forma barata. Pero la implicación más profunda es la flexibilidad arquitectónica.
Si la inteligencia puede modularizarse, también puede desvincularse.
Eso cambia toda la economía del riesgo de IA empresarial.
Una corporación ya no necesita volver a entrenar un sistema fundacional completo cada vez que cambia un marco regulatorio o cuando un conjunto de datos se vuelve problemático. Ciertas capas de comportamiento pueden aislarse teóricamente, desconectarse, reemplazarse o des-depreciarse económicamente.
En otras palabras, OpenLoRA no solo está ayudando a que la IA se especialice.
Está ayudando a que la IA se vuelva desechable de forma selectiva.
Eso podría terminar siendo increíblemente valioso más adelante.
Especialmente porque las empresas rara vez optimizan por el idealismo. Optimizan por la exposición controlable. La capacidad de aislar quirúrgicamente el riesgo operativo sin colapsar toda la pila del sistema es algo por lo que históricamente las corporaciones pagan primas enormes.
Y esto me devuelve a $OPEN itself.
Creo que la mayoría de la gente todavía valora el token con la lógica estándar de la infraestructura cripto: más uso, más transacciones, más actividad del ecosistema, más demanda.
Quizá.
Pero la posibilidad más interesante es que $OPEN e se vincule económicamente con la propia gobernanza de la memoria de las máquinas. No solo facilitando flujos de inteligencia, sino coordinando el costo, la atribución, la persistencia y la eliminación eventual de capas de inteligencia que operan en sistemas empresariales.
Ese es un mercado mucho más extraño de lo que la gente se imagina.
Porque una vez que la memoria lleva peso financiero y legal, la infraestructura de IA deja de ser únicamente técnica.
Se vuelve político.
¿Quién controla los derechos de revocación?
¿Quién arbitra las disputas entre contribuidores y empresas?
¿Quién decide cuándo la inteligencia retenida se vuelve insegura?
¿Quién asume las consecuencias económicas del olvido forzado?
Esos conflictos no tienen respuestas claras.
Y honestamente, es precisamente por eso que esta área se siente estructuralmente importante.
El mercado de la IA todavía se comporta como si la inteligencia “cruda” siguiera siendo el recurso escaso.
Cada vez pienso más que la inteligencia controlada se volverá más escasa.
Eso cambia qué capas de infraestructura importan más.
OpenLedger podría fallar, sin duda. La mayoría de los protocolos de infraestructura también. La complejidad operativa por sí sola es un desafío serio. Las empresas pueden seguir prefiriendo la opacidad centralizada simplemente porque es más fácil y rápido.
Pero si los sistemas de IA eventualmente se integran tan profundamente en la vida económica que la memoria incontrolada se convierte en riesgo institucional…
entonces las empresas capaces de gestionar la ignorancia de las máquinas podrían volverse más valiosas que las empresas que simplemente construyen máquinas más inteligentes.
Y cada vez más, OpenLedger se siente como uno de los pocos proyectos que ya está construyendo alrededor de esa tensión futura antes de que el mercado la vea por completo.
#OpenLedger #openledger $BSB @OpenLedger
#BitcoinBreaksBelow75KAsWarshTakesFedHelm #FenwickWestSettlesFTXFor54M #SECHaltsInnovationExemption