
Como desarrollador independiente, me tomé un mes y medio para construir desde cero una aplicación de escritorio de monitoreo y análisis inteligente de activos de doble cadena llamada "Xiao Nan Web3 Sentinel". Soporta todas las cadenas compatibles con EVM y la cadena de Solana, e integra funciones avanzadas como interpretación de transacciones de IA, notificaciones multicanal y agregación de datos en cadena, y ha estado funcionando de manera estable durante varios meses.
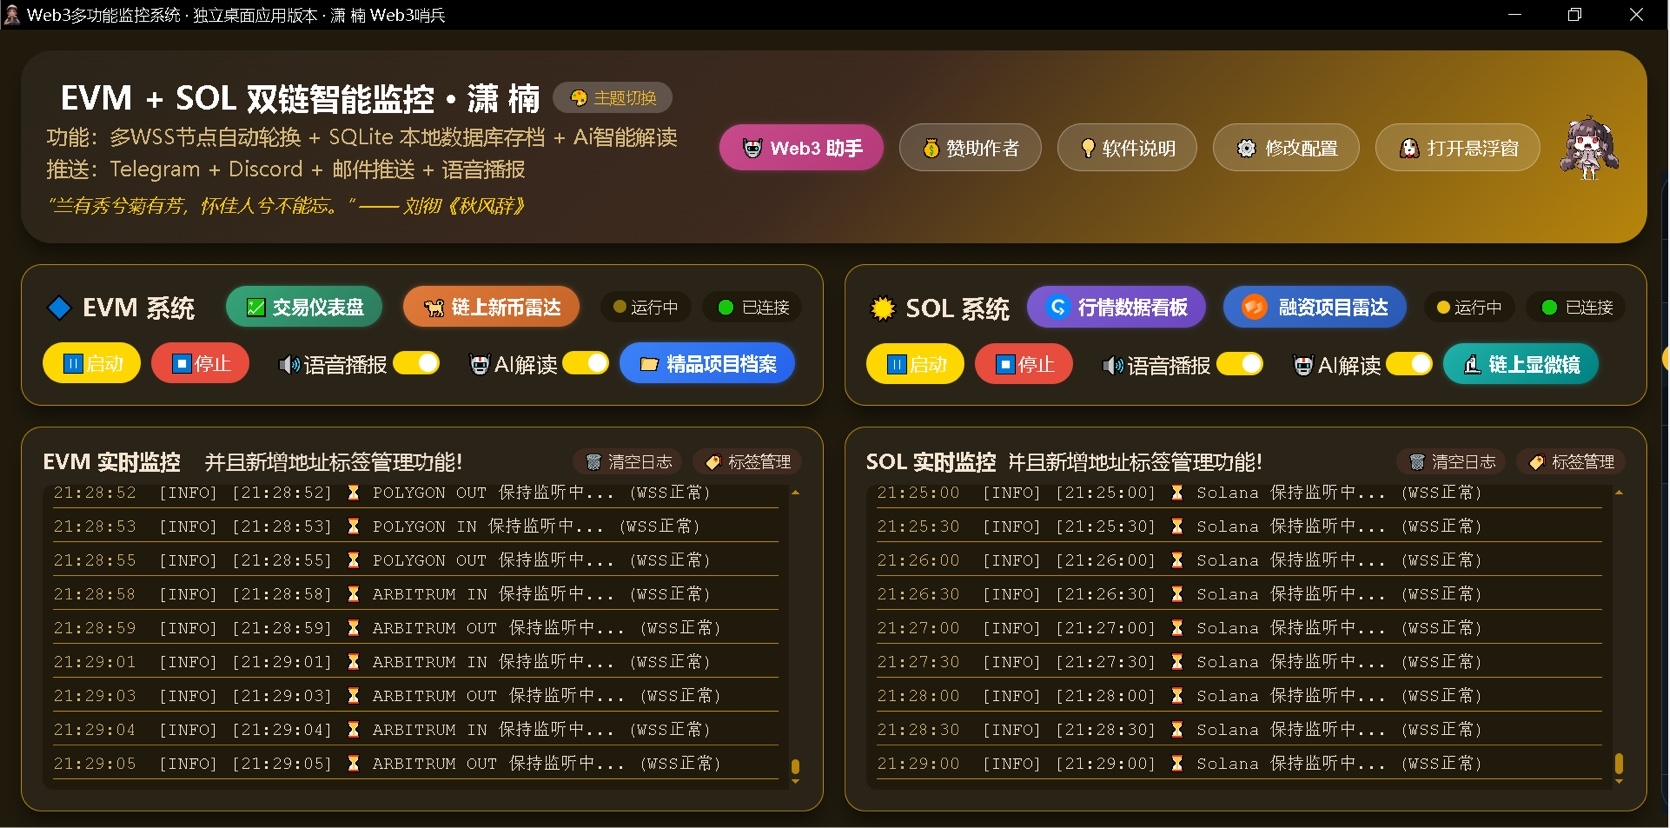
Anteriormente publiqué un resumen técnico, pero siempre sentí que el análisis de la implementación central no era lo suficientemente "satisfactorio". Por lo tanto, decidí escribir este análisis técnico en profundidad, compartiendo sin reservas las decisiones de diseño y los detalles de implementación que están ocultos en el código desde las dimensiones de la arquitectura de procesos, el modelo de I/O, la consistencia de datos y la ingeniería de IA. Espero que este artículo pueda proporcionar algunas referencias valiosas a los desarrolladores que también exploran en el ámbito de Web3.
1. Arquitectura de procesos: ¿por qué elegir “proceso principal + múltiples subprocesos”?
Muchos scripts de monitoreo de Python en el mercado usan una sola instancia con asyncio a lo grande, pero desde el diseño inicial decidí con firmeza adoptar una arquitectura de microkernel: “proceso principal (GUI) + subprocesos independientes (EVM/SOL)”.
1.1 El aislamiento y la estabilidad lo superan todo
Las conexiones persistentes de WebSocket disparan fácilmente reconexiones con excepciones cuando hay fluctuaciones de red, e incluso la extensión C de la librería subyacente puede colapsar por razones desconocidas. Si mezclas la GUI con la lógica de monitoreo dentro de un mismo proceso, cualquier excepción no capturada o infracción de acceso a memoria puede causar que toda la aplicación de escritorio se cierre de golpe. Al aislar la lógica de monitoreo EVM y Solana en subprocesos independientes usando subprocess.Popen, implementé un aislamiento a nivel físico: si Evm.py colapsa o se le aplica Kill forzado, la ventana principal sigue funcionando, el icono de la bandeja no desaparece y el usuario puede hacer clic en “Iniciar” para volver a levantarlo.
Transmisión de logs: el proceso principal captura el stdout del subproceso mediante un pipe, usa un hilo forwardoutput para leer línea por línea, limpiar códigos de color ANSI y luego inyectar el DOM del frontend con window.evaluate_js; así, al mismo tiempo que se refrescan los logs en tiempo real, el hilo de la UI permanece ligero.
1.2 Detalles de la gestión del ciclo de vida
En core_process.py, detener el subproceso no es simplemente llamar a terminate(). Implementé un mecanismo de respaldo para remate fuerte:
python
proc.terminate()
proc.wait(timeout=3)
if proc.poll() is None:
proc.kill()
proc.wait(timeout=2)
if proc.poll() is None:
os.system(f'taskkill /F /PID {proc.pid}')
Este conjunto de acciones garantiza que, incluso si el intérprete de Python se bloquea, Windows pueda limpiar completamente el árbol de procesos a nivel subyacente, evitando procesos residuales que mantengan ocupados puertos o bloqueos de base de datos, lo que impediría que el siguiente inicio tenga éxito.
2. Modelo de E/S y conexiones de alta disponibilidad: no es solo asyncio
2.1 Modo híbrido de monitoreo: WSS en tiempo real + compensación por RPC
Para las monedas nativas de la cadena EVM, como no hay un log estándar del evento Transfer, no se puede suscribir mediante WSS. Diseñé un compensador de polling: cada 60 segundos obtiene eth_getBalance mediante RPC, lo compara con una instantánea en memoria y, si la diferencia supera 1e-18, activa el envío. Aunque parezca un mecanismo sencillo, en realidad es la última línea de defensa cuando la suscripción WSS deja de funcionar.
Para tokens y NFTs, el sistema se suscribe a logs y procesa con precisión los eventos TransferSingle y TransferBatch de ERC1155. En particular, para TransferBatch, el campo data contiene un arreglo dinámico; implementé un análisis manual de desplazamientos basado en la especificación ABI, en lugar de depender de librerías pesadas, reduciendo drásticamente el costo de análisis.
2.2 Retardo exponencial del WSS y conmutación en caliente de nodos
En entornos de producción, los nodos públicos de RPC/WSS pueden limitar el ancho de banda o caerse en cualquier momento. Implementé en chain_wss_monitor_direction la estrategia de rotación de nodos y reconexión:
Pool de nodos: en el archivo de configuración, configura varios WSS_NODES para cada cadena. Al iniciar, se elige aleatoriamente o en orden un nodo.
Algoritmo de retroceso: después de una desconexión, el intervalo de reintento empieza en 5 segundos y se duplica en cada ocasión hasta llegar a 60 segundos, evitando tormentas de reconexión tipo DDoS antes de que el nodo se recupere.
Adaptación al entorno de red en China: el sistema admite configurar la dirección HTTP del software de proxy local. Al usar la librería websockets_proxy, se reenvía el tráfico WSS al proxy, restaurando una comunicación estable con nodos en el extranjero.
2.3 Pipeline asíncrono de análisis para Solana
La velocidad de producción de bloques en Solana es extremadamente rápida y la estructura de las transacciones es compleja. Para evitar que las llamadas a la API de Helius bloqueen la recepción de mensajes WSS, diseñé un modelo desacoplado productor-consumidor:
Productor: cuando WSS logsSubscribe recibe una firma, la coloca inmediatamente en asyncio.Queue o dispara directamente una asyncio.create_task en segundo plano.
Consumidor: una tarea asíncrona independiente se encarga de llamar a la interfaz Helius /v0/transactions, y analizar campos como nativeTransfers, tokenTransfers, events.nft, etc.
Esto garantiza que el bucle recv() de la conexión WSS nunca quede bloqueado por solicitudes HTTP lentas, asegurando la inmediatez de los mensajes en entornos con TPS extremadamente alto.
3. Consistencia de datos: de la deduplicación en memoria a las restricciones de SQLite
3.1 Lado EVM: índice único en base de datos
En el monitoreo EVM, la misma transacción puede procesarse varias veces por razones como reconexión WSS o compensación por polling. Depender solo del set en memoria no basta para manejar reinicios del proceso. Por eso, diseñé una restricción única compuesta para la tabla tx_history:
sql
UNIQUE(tx_hash, log_index, address)
Cualquier inserción duplicada se descarta silenciosamente mediante SQLite con ON CONFLICT IGNORE, garantizando la idempotencia a nivel del núcleo de la base de datos. Para las transferencias de monedas nativas que no tienen log_index, se degrada usando tx_hash + address como clave compuesta.
3.2 Lado Solana: deduplicación de firmas dentro de una ventana de tiempo
En Solana no existe el concepto de log_index, y el análisis de Helius puede generar múltiples registros. Uso un set en memoria para almacenar las firmas procesadas más recientemente. Además, con la idea de una variante de LimitedSizeDict, cuando el conjunto de firmas supera 1000, se limpia automáticamente la mitad (o bien usando OrderedDict para extraer la entrada más antigua). Esta deduplicación con ventana deslizante logra un buen equilibrio entre rendimiento y precisión.
4. Ingeniería de IA: tolerancia a múltiples proveedores y el arte del análisis de JSON
4.1 Programación dinámica guiada por características
MultiAIClient es el núcleo del módulo de IA. No es simplemente una rama if-else, sino un planificador basado en banderas de características. En el archivo de configuración se definen las funciones que admite cada proveedor (por ejemplo, transaction_insight, daily_report, etc.). Cuando llega una solicitud de interpretación, el sistema filtra la lista de proveedores que admiten esa característica, envía la petición según la prioridad y, si hay tiempo de espera o falla, hace una degradación automática al siguiente.
4.2 Análisis defensivo de la salida del LLM
La salida de un modelo grande en formato JSON inestable es lo habitual. Mi flujo de trabajo es mucho más complejo que simplemente json.loads:
Limpieza: remover los marcadores de bloques de código Markdown json` y。
Extracción por regex: si el análisis falla, usa directamente la expresión regular r'"insight"\s*:\s*"([^"]*)"' para extraer el campo de forma “a la fuerza”; esta es la última línea de defensa.
Mapeo de campos: compatibilidad con varias denominaciones de keys como insight / Insight / interpretación, etc.
Este mecanismo garantiza que, incluso si Moonshot o DeepSeek devuelven “medio JSON”, el frontend aún pueda mostrar una interpretación válida sin lanzar JSONDecodeError que provoque una pantalla en blanco.
5. Memoria y rendimiento: LimitedSizeDict y colas asíncronas
5.1 Diccionario finito de capacidad personalizada
La biblioteca estándar de Python no incluye LRU y no trae diccionarios con tamaño limitado. Con base en collections.OrderedDict implementé LimitedSizeDict:
python
def setitem(self, key, value):
if len(self) >= self.max_size:
self.popitem(last=False) # Elimina el elemento insertado más antiguo
super().__setitem__(key, value)
Esta sencilla estructura de datos se usa para caché de información de tokens, caché de precios y caché de metadatos de NFTs. Garantiza que, durante ejecuciones prolongadas, el uso de memoria no crezca linealmente con la cantidad de direcciones monitoreadas, sino que se mantenga en un nivel extremadamente bajo y estable.
5.2 Escritura asíncrona serializada de logs de Solana
Los detallados logs de transacciones de Solana deben escribirse en archivos JSON. Si varios corutinas hacen json.dump al mismo tiempo, es muy fácil que el formato del archivo se corrompa. Introduje asyncio.Queue:
Todas las solicitudes de escritura de logs ponen los datos en la cola.
El único corutina en segundo plano filewriter bloquea esperando la cola; después de sacar los datos, ejecuta la E/S de archivos.
Esto evita tanto los bloqueos complejos de hilos como aprovecha las características asíncronas para garantizar la seguridad de los datos bajo alta concurrencia.
6. Comunicación bidireccional entre frontend y backend: integración profunda de pywebview
6.1 Inyección de JS API
pywebview permite exponer directamente métodos de objetos Python al JavaScript del frontend. Mi clase Api hereda de múltiples Mixin; todos los métodos públicos que empiezan con def se convierten automáticamente en miembros de window.pywebview.api. Esto me permite implementar separación frontend-backend con un costo muy bajo; el frontend solo necesita centrarse en la interacción de la UI.
6.2 Instancia independiente de ventanas flotantes y comunicación
La ventana flotante no es un sub-DIV de la ventana principal, sino una segunda ventana independiente creada por pywebview. La administro con FloatingWindowManager y uso la instancia js_api del proceso principal para inyectar código JS en la ventana flotante (evaluate_js), logrando que los logs de la ventana principal se envíen en tiempo real a la flotante. Este diseño garantiza que, aunque se cierre la ventana flotante, no afecte la tarea principal de monitoreo.
7. Empaquetado de aplicaciones de escritorio: los “baches” profundos de PyInstaller y prácticas de ingeniería
Entregar un proyecto Python a usuarios finales sin base técnica empaquetado en un EXE independiente es un paso indispensable. PyInstaller parece una simple orden, pero en proyectos complejos, detrás hay un sinfín de detalles que pueden hacer colapsar al desarrollador. Esta sección comparte algunos de los “baches” típicos y sus soluciones que encontré durante el empaquetado del “Alerta Web3 de Xiaonan”.
7.1 Importación implícita y --hidden-import
PyInstaller construye el árbol de dependencias mediante el análisis estático de las sentencias import en el archivo de entrada. Sin embargo, muchas librerías (como pystray, websockets) usan importlib.import_module o carga dinámica de submódulos mediante import, lo que hace que el EXE empaquetado lance ModuleNotFoundError en tiempo de ejecución.
La clave para resolver este problema está en localizar hacia atrás el módulo faltante según el mensaje de error y declarar explícitamente --hidden-import en el comando de empaquetado. Por ejemplo, en este proyecto, la funcionalidad del icono de la bandeja debe agregarse:
bash
--hidden-import pystray._win32
--hidden-import pystray._util
--hidden-import win32event
--hidden-import win32api
Esto exige que los desarrolladores comprendan cierta estructura interna de las librerías dependientes. Por lo general, se necesita combinar lectura del código fuente y prueba y error repetida para listar completamente todas las dependencias implícitas.
7.2 --collect-all y trampas con archivos de recursos
La librería pywebview no solo incluye código Python: también depende de archivos HTML/JS del frontend y del runtime Edge WebView2. El análisis predeterminado de PyInstaller no puede detectar estos recursos no relacionados con código. Si no se hace nada, tras empaquetar la aplicación, esta mostrará pantalla en blanco porque no encontrará index.html o webview.js.
La manera correcta es usar --collect-all pywebview. Este parámetro obliga a que PyInstaller copie todos los archivos dentro del directorio del paquete pywebview (incluidos binarios y recursos estáticos) al directorio de empaquetado. Esta es la práctica estándar para manejar este tipo de librerías GUI “pesadas”.
7.3 Dependencias binarias y compresión UPX
Las librerías como pywin32 y Pillow que dependen del proyecto incluyen archivos binarios .pyd y .dll. Estos archivos pesan bastante y, después de empaquetar con PyInstaller, no se comprimen automáticamente. Al integrar la herramienta UPX y especificar --upx-dir en el comando de empaquetado, puedes comprimir en alta proporción los binarios dentro del EXE final (normalmente reduce entre 30%-50% del tamaño). Ten en cuenta que unos pocos antivirus antiguos podrían dar falsos positivos a programas empaquetados con UPX; para el público técnico, la probabilidad es muy baja y se puede resolver enviando el archivo de muestra.
7.4 “Congelar” rutas y sys._MEIPASS
Este es el concepto más fundamental en el empaquetado con PyInstaller. Durante el desarrollo, el programa accede a archivos de configuración y recursos de imágenes mediante file o rutas relativas. Después de empaquetarlo como un único EXE, todos los recursos se descomprimen en un directorio temporal; la ruta de ese directorio se guarda en la variable sys._MEIPASS.
Los desarrolladores deben reemplazar globalmente toda la lógica de acceso a archivos en el código, con el siguiente paradigma típico:
python
def get_resource_path(relative_path):
if getattr(sys, 'frozen', False):
base = sys._MEIPASS
else:
base = os.path.abspath(".")
return os.path.join(base, relative_path)
Ignorar esta adaptación hará que, en tiempo de ejecución, el programa no encuentre ningún archivo externo; esta es la “pesadilla de rutas” más común que sufren los principiantes al empaquetar. Mi solución consiste en encapsular esta función en utils.py, para que todo el proyecto la invoque de forma uniforme y se garantice un comportamiento consistente de rutas antes y después del empaquetado.
7.5 Tratamiento especial de subprocesos
Este sistema utiliza una arquitectura donde el proceso principal inicia los subprocesos. Después del empaquetado, los scripts de subproceso Evm.py y Sol.py también quedan encapsulados dentro del EXE. Si el proceso principal intenta iniciar usando python.exe Evm.py, fallará por no encontrar archivos. Mi solución es que, cuando el proceso principal inicia los subprocesos, detecta dinámicamente si se está en modo de empaquetado y pasa el parámetro correcto --main-exe-dir, para que el subproceso pueda localizar el directorio externo donde están los archivos de configuración. Los detalles de esta lógica ya se describieron en la sección de arquitectura de procesos; aquí no se repite.
8. Conclusión
Al revisar todo el proceso de desarrollo, desde un script único hasta una arquitectura de multiproceso; desde un WebSocket “en crudo” hasta un pool de nodos de alta disponibilidad; desde simples logs con print hasta almacenamiento estructurado en SQLite. Cada paso fue una profundización en la comprensión de la ingeniería. La exploración en la etapa de empaquetado me hizo aún más claro esto: que el software se mantenga estable solo es el primer paso; que el usuario pueda usarlo con facilidad es la entrega real.
Esto no es solo una herramienta de monitoreo; es la culminación de mi experiencia práctica en programación asíncrona, gestión de procesos, integración de IA, desarrollo de software de escritorio y otros campos.
Si le interesan los detalles técnicos de cualquier parte del texto, lo invito a visitar mi GITHUB:
https://github.com/pingdj/Web3
Obtenga el software y más documentación técnica. También espero conversar e intercambiar ideas con todos en el Binance Plaza.
Perfil del autor: Xiaonan, desarrollador independiente full-stack y Web3, enfocado en aplicaciones de escritorio con Python, análisis de datos de blockchain y la implementación de ingeniería de IA.
