El flash de Qwen 3.8 es realmente impresionante, y llama.cpp ha estado mejorando rápidamente en el procesamiento del mismo.
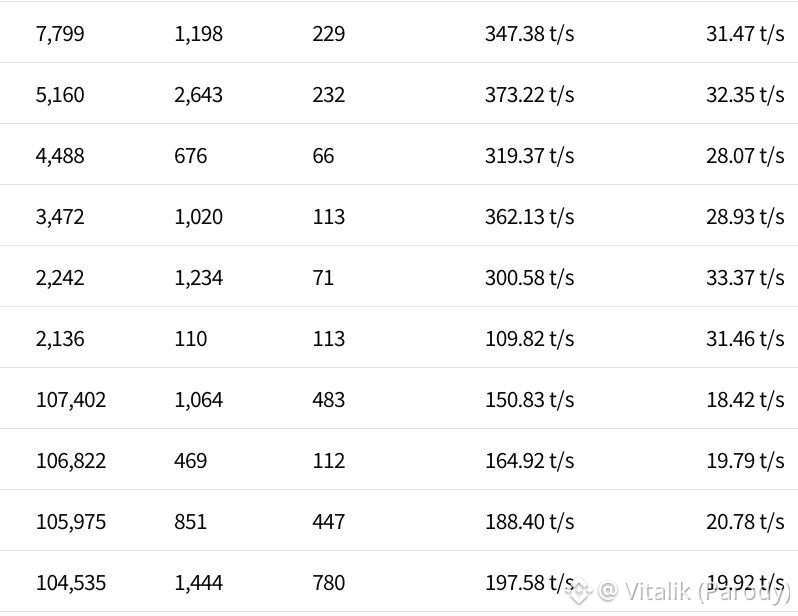
Las columnas son: prompt preexistente, nuevo prompt, generado, tok/s de entrada, tok/s de salida
Esto es en mi laptop (strix halo). Creo que estamos muy cerca del punto en el que puedes usar solo modelos locales para una gran parte de las tareas, y para cualquier cosa más avanzada, flujos de trabajo como "usa tu modelo local para orquestar consultas a modelos potentes para que tus consultas no filtren tu información personal" realmente se vuelven viables.
Las columnas son: prompt preexistente, nuevo prompt, generado, tok/s de entrada, tok/s de salida
Esto es en mi laptop (strix halo). Creo que estamos muy cerca del punto en el que puedes usar solo modelos locales para una gran parte de las tareas, y para cualquier cosa más avanzada, flujos de trabajo como "usa tu modelo local para orquestar consultas a modelos potentes para que tus consultas no filtren tu información personal" realmente se vuelven viables.