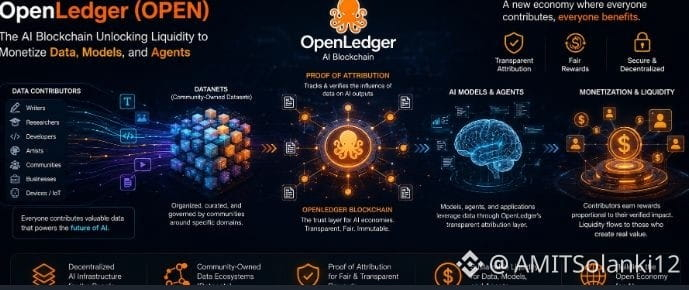
$OPEN
#OpenAIToConfidentiallyFileForIPO OpenLedger y la Extraña Sensación de que la IA Podría Estar Chocando con el Mismo Muro.
He estado en el mundo cripto el tiempo suficiente para dejar de reaccionar cada vez que un proyecto afirma que está “redefiniendo” algo.
La mayoría de las veces, esas palabras son solo un empaque reciclado alrededor de los mismos viejos incentivos. Nuevo token, nueva marca, misma realidad subyacente: unos pocos insiders capturan el valor, la multitud proporciona liquidez, y eventualmente la narrativa se mueve a otro lado.
Probablemente por eso me he vuelto más lento para emocionarme por cualquier cosa relacionada con la IA últimamente. El espacio ya se siente abarrotado de promesas exageradas. Cada semana hay otro protocolo que afirma que va a descentralizar la inteligencia, tokenizar agentes, reinventar la computación, o reemplazar el internet mismo. Después de un tiempo, todo se mezcla en el mismo ruido de fondo.
Pero de vez en cuando, algo llama mi atención, no porque de repente crea en ello, sino porque parece enfocado en un problema que realmente existe.
OpenLedger es uno de esos proyectos para mí.
No estoy diciendo que funcione. No estoy diciendo que gane. Ni siquiera estoy diciendo que el modelo sea sostenible. Honestamente, aún no lo sé.
Pero sigo notando que la pregunta subyacente que está haciendo se siente más real que la mayoría de las narrativas de IA que flotan en cripto ahora mismo.
La pregunta es simple: si los modelos de IA se están convirtiendo en algunos de los sistemas más valiosos del mundo, ¿por qué casi nadie sabe de dónde proviene realmente el valor?
Eso suena obvio al principio, pero cuanto más lo piensas, más extraña comienza a verse toda la economía de la IA.
La mayoría de los sistemas de IA hoy en día están construidos sobre océanos de datos recopilados de personas que generalmente nunca ven compensación, propiedad, o incluso reconocimiento. Escritores, artistas, investigadores, usuarios de foros, desarrolladores, comunidades de nicho, archivos aleatorios de internet — todo se absorbe en modelos que eventualmente se convierten en productos que valen miles de millones.
Y de alguna manera todos simplemente aceptaron que esto es normal.
Quizás porque los sistemas se volvieron demasiado grandes para cuestionarlos. Quizás porque