
#openledger
openledger
17.3M vistas
202,843 están debatiendo
Hot
Lo último
OPENLEDGER: QUIZÁS EL FUTURO NO SEA UN REY GIGANTE DE IACreo que el mundo de la IA tiene una extraña obsesión con el tamaño. Modelo más grande, mayor capacidad de cómputo, más benchmarks, anuncios más grandes. Todos quieren construir el cerebro gigante que lo sabe todo. Suena poderoso, sí... pero también un poco gracioso, porque la mitad del tiempo ese cerebro gigante aún responde mal a una simple pregunta de nicho con total confianza.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
OPENLEDGER: QUIZÁS EL FUTURO NO SEA UN REY GIGANTE DE IA
Creo que el mundo de la IA tiene una extraña obsesión con el tamaño. Modelo más grande, mayor capacidad de cómputo, más benchmarks, anuncios más grandes. Todos quieren construir el cerebro gigante que lo sabe todo. Suena poderoso, sí... pero también un poco gracioso, porque la mitad del tiempo ese cerebro gigante aún responde mal a una simple pregunta de nicho con total confianza.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
461
·
--
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@Openledger | #OpenLedger
$OPEN
{future}(OPENUSDT)
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
2
2
66
·
--
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @Openledger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @Openledger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@Openledger $OPEN #OpenLedger
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @OpenLedger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
71

Artículo
Por qué OpenLedger ($OPEN) está entrando en una de las tendencias más grandes en cripto y IA¡Yo; Binance Square FanFollow! El mercado cripto siempre está buscando la próxima narrativa importante. En los últimos años, hemos visto que DeFi, NFTs, redes de Capa 2 y Activos del Mundo Real han ganado atención. Hoy, una de las tendencias más fuertes es la combinación de Inteligencia Artificial y tecnología blockchain.
Aquí es donde OpenLedger ($OPEN) se vuelve interesante.
Muchos sistemas de IA dependen de enormes cantidades de datos, pero las personas que contribuyen con esos datos a menudo reciben poco reconocimiento o recompensa. OpenLedger está trabajando en un enfoque diferente. Su objetivo es crear un ecosistema donde los contribuyentes de datos, desarrolladores y creadores de IA puedan participar en el valor que ayudan a crear.
Por qué OpenLedger ($OPEN) está entrando en una de las tendencias más grandes en cripto y IA
¡Yo; Binance Square FanFollow! El mercado cripto siempre está buscando la próxima narrativa importante. En los últimos años, hemos visto que DeFi, NFTs, redes de Capa 2 y Activos del Mundo Real han ganado atención. Hoy, una de las tendencias más fuertes es la combinación de Inteligencia Artificial y tecnología blockchain.
Aquí es donde OpenLedger ($OPEN ) se vuelve interesante.
Muchos sistemas de IA dependen de enormes cantidades de datos, pero las personas que contribuyen con esos datos a menudo reciben poco reconocimiento o recompensa. OpenLedger está trabajando en un enfoque diferente. Su objetivo es crear un ecosistema donde los contribuyentes de datos, desarrolladores y creadores de IA puedan participar en el valor que ayudan a crear.
Aquí es donde OpenLedger ($OPEN ) se vuelve interesante.
Muchos sistemas de IA dependen de enormes cantidades de datos, pero las personas que contribuyen con esos datos a menudo reciben poco reconocimiento o recompensa. OpenLedger está trabajando en un enfoque diferente. Su objetivo es crear un ecosistema donde los contribuyentes de datos, desarrolladores y creadores de IA puedan participar en el valor que ayudan a crear.
101
·
--
#openledger $OPEN las redes de infraestructura física descentralizada están transformando el paisaje de la IA y @Openledger está a la vanguardia de este cambio
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
{spot}(OPENUSDT)
$BNB
{spot}(BNBUSDT)
#openledger $OPEN las redes de infraestructura física descentralizada están transformando el paisaje de la IA y @OpenLedger está a la vanguardia de este cambio
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
$BNB
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
$BNB
60
·
--
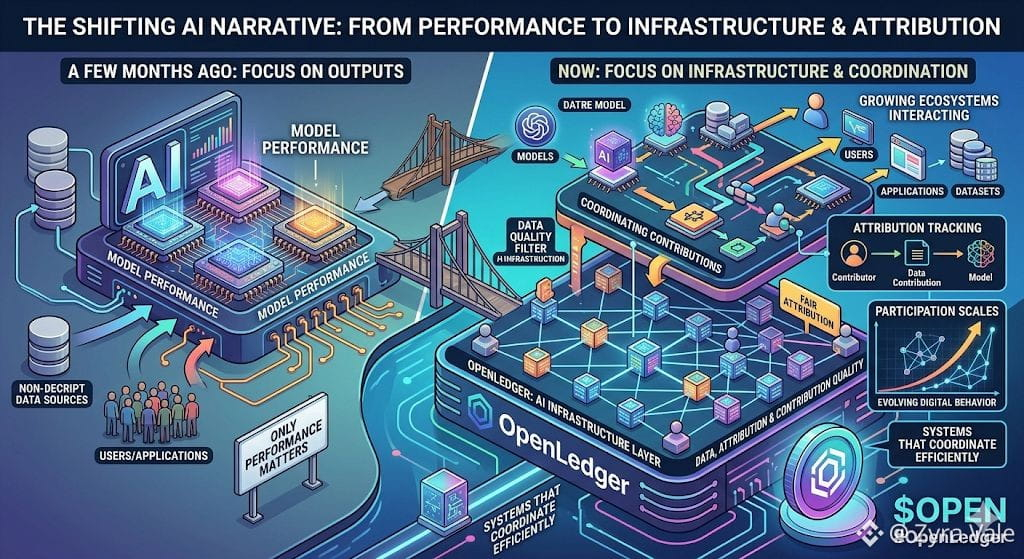
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @Openledger
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
2
185
·
--

Artículo
El Futuro de la Monetización de IA Comienza con OpenLedgerLa Inteligencia Artificial se está convirtiendo rápidamente en una de las tecnologías más valiosas de nuestro tiempo. Cada día, se crean nuevos modelos de IA, conjuntos de datos y agentes autónomos, generando un valor inmenso en diversas industrias. Sin embargo, queda un desafío sin resolver: ¿cómo pueden los contribuyentes monetizar de manera justa los datos, modelos e inteligencia que crean?
Aquí es donde @Openledger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
El Futuro de la Monetización de IA Comienza con OpenLedger
La Inteligencia Artificial se está convirtiendo rápidamente en una de las tecnologías más valiosas de nuestro tiempo. Cada día, se crean nuevos modelos de IA, conjuntos de datos y agentes autónomos, generando un valor inmenso en diversas industrias. Sin embargo, queda un desafío sin resolver: ¿cómo pueden los contribuyentes monetizar de manera justa los datos, modelos e inteligencia que crean?
Aquí es donde @OpenLedger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
Aquí es donde @OpenLedger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
38
·
--
Artículo
Hice un cálculo: ¿cuánto se puede ganar en un mes en OpenLedger?El mes pasado, cuando no tenía nada que hacer, decidí tomar en serio la tarea de contribuir datos a OpenLedger. No se trata de subir cualquier archivo al azar, sino que dediqué dos horas fijas cada día, eligiendo fuentes de datos de alta calidad, haciendo limpieza y etiquetado. Lo hice durante treinta días consecutivos. Quería ver cuánto se puede monetizar esta estrategia de "reparto de ganancias por contribución" en la vida real para una persona común.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN, calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
Hice un cálculo: ¿cuánto se puede ganar en un mes en OpenLedger?
El mes pasado, cuando no tenía nada que hacer, decidí tomar en serio la tarea de contribuir datos a OpenLedger. No se trata de subir cualquier archivo al azar, sino que dediqué dos horas fijas cada día, eligiendo fuentes de datos de alta calidad, haciendo limpieza y etiquetado. Lo hice durante treinta días consecutivos. Quería ver cuánto se puede monetizar esta estrategia de "reparto de ganancias por contribución" en la vida real para una persona común.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN , calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN , calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
473

·
--
Verificado
Artículo
OpenLedger se siente como un juego de contribuidor… Pero $OPEN puede estar evaluando la larga cola de la entrada humanaPara ser honesta, hay una frustración silenciosa que he llevado desde 2022 por contribuir en espacios online.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
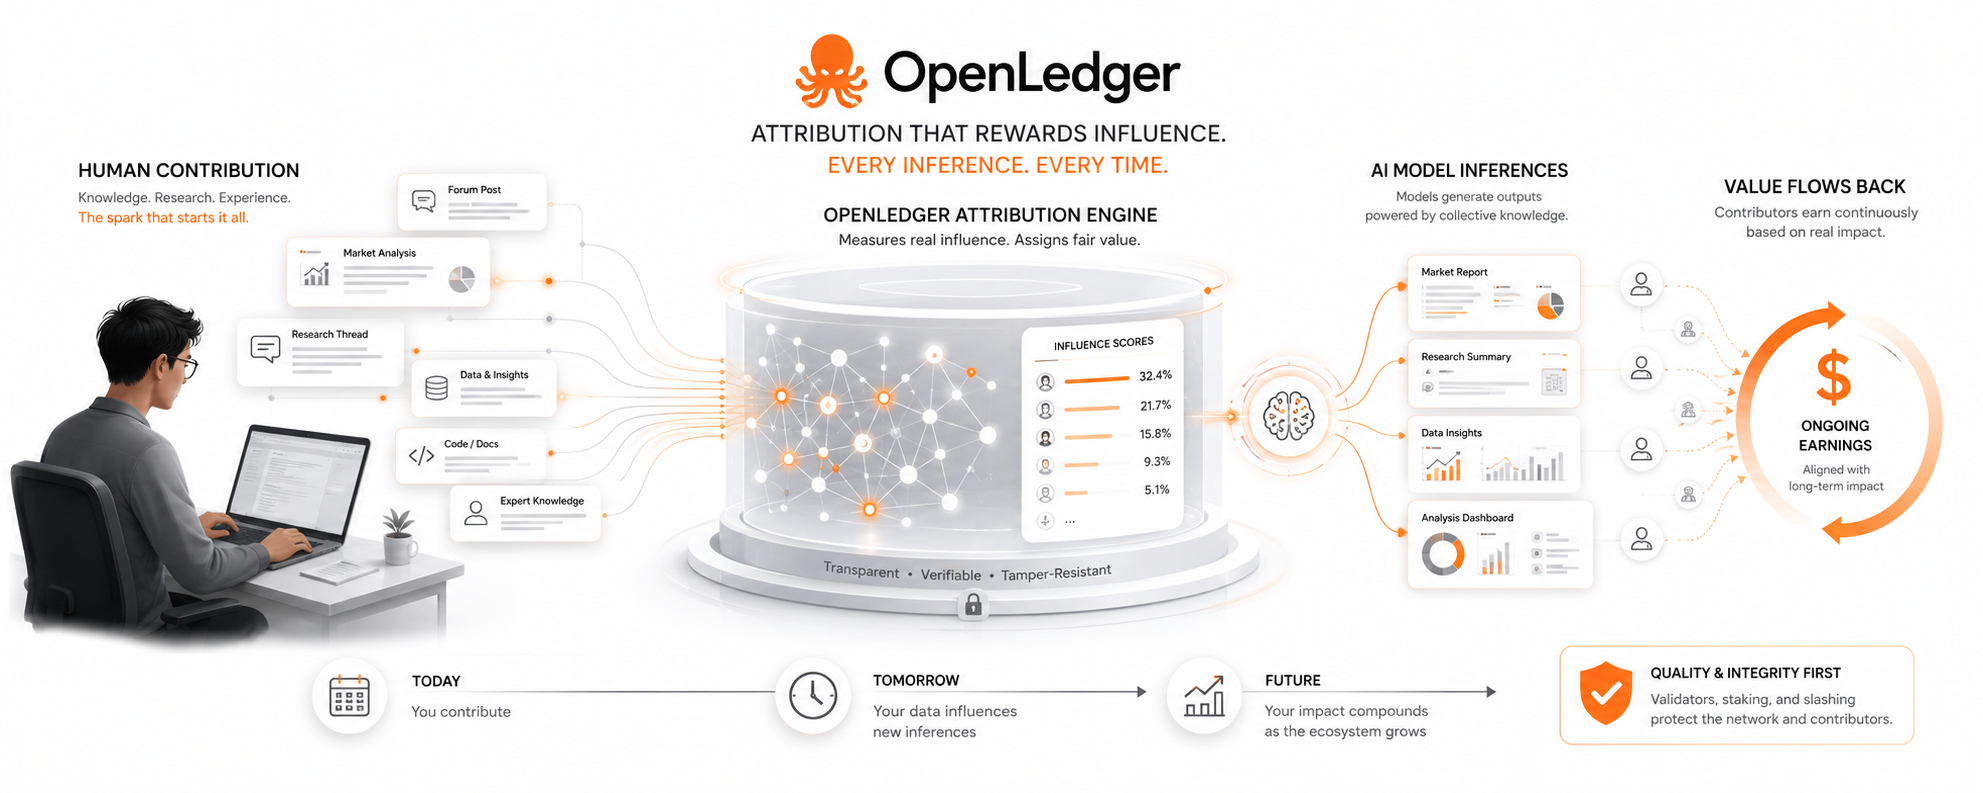
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
OpenLedger se siente como un juego de contribuidor… Pero $OPEN puede estar evaluando la larga cola de la entrada humana
Para ser honesta, hay una frustración silenciosa que he llevado desde 2022 por contribuir en espacios online.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
763
·
--
Artículo
La Economía Oculta Detrás de la InteligenciaUna cosa que he aprendido después de años observando los mercados cripto es que las mayores oportunidades rara vez llegan luciendo importantes.
La mayoría de la gente presta atención a las narrativas más ruidosas. Los tokens que están en los titulares. Las velas que se mueven verticalmente. Las promesas de una nueva revolución cada pocos meses. Pero cuando miro hacia atrás a los proyectos que realmente cambiaron la industria, muchos de ellos comenzaron como infraestructura aburrida. Resolvieron un problema antes de que la mayoría de la gente se diera cuenta de que existía.
Esa es parte de la razón por la que OpenLedger llamó mi atención.
La Economía Oculta Detrás de la Inteligencia
Una cosa que he aprendido después de años observando los mercados cripto es que las mayores oportunidades rara vez llegan luciendo importantes.
La mayoría de la gente presta atención a las narrativas más ruidosas. Los tokens que están en los titulares. Las velas que se mueven verticalmente. Las promesas de una nueva revolución cada pocos meses. Pero cuando miro hacia atrás a los proyectos que realmente cambiaron la industria, muchos de ellos comenzaron como infraestructura aburrida. Resolvieron un problema antes de que la mayoría de la gente se diera cuenta de que existía.
Esa es parte de la razón por la que OpenLedger llamó mi atención.
La mayoría de la gente presta atención a las narrativas más ruidosas. Los tokens que están en los titulares. Las velas que se mueven verticalmente. Las promesas de una nueva revolución cada pocos meses. Pero cuando miro hacia atrás a los proyectos que realmente cambiaron la industria, muchos de ellos comenzaron como infraestructura aburrida. Resolvieron un problema antes de que la mayoría de la gente se diera cuenta de que existía.
Esa es parte de la razón por la que OpenLedger llamó mi atención.
101
·
--
Alcista
Estoy observando OpenLedger con una mente tranquila porque he visto suficientes ciclos cripto para saber que una narrativa sólida puede atraer atención muy rápido, pero la atención sola no hace que un proyecto sea importante.
OpenLedger suena interesante porque está tratando de abordar un problema real dentro de la IA. Los datos, modelos, agentes y la input humana están creando valor en todas partes, pero el valor no siempre se rastrea claramente. Muchas personas contribuyen a los sistemas de IA de diferentes maneras, pero la mayor parte de esa contribución permanece invisible. OpenLedger quiere hacer esas contribuciones más útiles, más rastreables y más monetizables.
Esa idea tiene sentido para mí.
Pero no me estoy apresurando a llamarlo un ganador.
La verdadera pregunta no es si OpenLedger suena bien. La verdadera pregunta es si la gente realmente lo necesita.
¿Están los desarrolladores construyendo sobre ello porque resuelve un problema real?
¿Están los contribuyentes de datos aportando datos valiosos, o solo están persiguiendo recompensas?
¿Están los modelos y agentes creando actividad económica real, o la mayor parte de la actividad sigue siendo impulsada por el hype?
¿Se está utilizando OPEN porque la red lo necesita, o porque los traders están siguiendo la narrativa de IA?
Estas son las preguntas que me importan.
Ya he visto DeFi, GameFi, tokens del metaverso, cadenas modulares, monedas de IA y muchas otras narrativas venir y desaparecer. Cada ciclo trae proyectos que suenan poderosos al principio. Algunos se convierten en infraestructura real. La mayoría se desvanecen cuando los incentivos desaparecen y la atención se mueve a otro lugar.
Por eso miro OpenLedger con cuidado.
El proyecto tiene potencial porque la IA necesitará mejores sistemas para la atribución, la propiedad de datos, la confianza y la coordinación. Si OpenLedger puede ayudar a los contribuyentes de datos, constructores de modelos y agentes de IA a trabajar juntos en una economía real, entonces podría convertirse en más que solo otro token.
Pero el potencial no es prueba.
#OpenLedger @Openledger $OPEN
{future}(OPENUSDT)
Estoy observando OpenLedger con una mente tranquila porque he visto suficientes ciclos cripto para saber que una narrativa sólida puede atraer atención muy rápido, pero la atención sola no hace que un proyecto sea importante.
OpenLedger suena interesante porque está tratando de abordar un problema real dentro de la IA. Los datos, modelos, agentes y la input humana están creando valor en todas partes, pero el valor no siempre se rastrea claramente. Muchas personas contribuyen a los sistemas de IA de diferentes maneras, pero la mayor parte de esa contribución permanece invisible. OpenLedger quiere hacer esas contribuciones más útiles, más rastreables y más monetizables.
Esa idea tiene sentido para mí.
Pero no me estoy apresurando a llamarlo un ganador.
La verdadera pregunta no es si OpenLedger suena bien. La verdadera pregunta es si la gente realmente lo necesita.
¿Están los desarrolladores construyendo sobre ello porque resuelve un problema real?
¿Están los contribuyentes de datos aportando datos valiosos, o solo están persiguiendo recompensas?
¿Están los modelos y agentes creando actividad económica real, o la mayor parte de la actividad sigue siendo impulsada por el hype?
¿Se está utilizando OPEN porque la red lo necesita, o porque los traders están siguiendo la narrativa de IA?
Estas son las preguntas que me importan.
Ya he visto DeFi, GameFi, tokens del metaverso, cadenas modulares, monedas de IA y muchas otras narrativas venir y desaparecer. Cada ciclo trae proyectos que suenan poderosos al principio. Algunos se convierten en infraestructura real. La mayoría se desvanecen cuando los incentivos desaparecen y la atención se mueve a otro lugar.
Por eso miro OpenLedger con cuidado.
El proyecto tiene potencial porque la IA necesitará mejores sistemas para la atribución, la propiedad de datos, la confianza y la coordinación. Si OpenLedger puede ayudar a los contribuyentes de datos, constructores de modelos y agentes de IA a trabajar juntos en una economía real, entonces podría convertirse en más que solo otro token.
Pero el potencial no es prueba.
#OpenLedger @OpenLedger $OPEN
OpenLedger suena interesante porque está tratando de abordar un problema real dentro de la IA. Los datos, modelos, agentes y la input humana están creando valor en todas partes, pero el valor no siempre se rastrea claramente. Muchas personas contribuyen a los sistemas de IA de diferentes maneras, pero la mayor parte de esa contribución permanece invisible. OpenLedger quiere hacer esas contribuciones más útiles, más rastreables y más monetizables.
Esa idea tiene sentido para mí.
Pero no me estoy apresurando a llamarlo un ganador.
La verdadera pregunta no es si OpenLedger suena bien. La verdadera pregunta es si la gente realmente lo necesita.
¿Están los desarrolladores construyendo sobre ello porque resuelve un problema real?
¿Están los contribuyentes de datos aportando datos valiosos, o solo están persiguiendo recompensas?
¿Están los modelos y agentes creando actividad económica real, o la mayor parte de la actividad sigue siendo impulsada por el hype?
¿Se está utilizando OPEN porque la red lo necesita, o porque los traders están siguiendo la narrativa de IA?
Estas son las preguntas que me importan.
Ya he visto DeFi, GameFi, tokens del metaverso, cadenas modulares, monedas de IA y muchas otras narrativas venir y desaparecer. Cada ciclo trae proyectos que suenan poderosos al principio. Algunos se convierten en infraestructura real. La mayoría se desvanecen cuando los incentivos desaparecen y la atención se mueve a otro lugar.
Por eso miro OpenLedger con cuidado.
El proyecto tiene potencial porque la IA necesitará mejores sistemas para la atribución, la propiedad de datos, la confianza y la coordinación. Si OpenLedger puede ayudar a los contribuyentes de datos, constructores de modelos y agentes de IA a trabajar juntos en una economía real, entonces podría convertirse en más que solo otro token.
Pero el potencial no es prueba.
#OpenLedger @OpenLedger $OPEN
1
134
·
--
Últimamente he estado diseñando un proceso automatizado de colaboración entre múltiples agentes, y cada vez más siento que la visión de @Openledger de "miles de agentes llamándose y liquidándose automáticamente entre sí" suena sexy, pero al implementarla hay un peligro de ingeniería mortal oculto: la propagación en cascada de fallos.
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @Openledger
{future}(LABUSDT)
{spot}(OPENUSDT)
Últimamente he estado diseñando un proceso automatizado de colaboración entre múltiples agentes, y cada vez más siento que la visión de @OpenLedger de "miles de agentes llamándose y liquidándose automáticamente entre sí" suena sexy, pero al implementarla hay un peligro de ingeniería mortal oculto: la propagación en cascada de fallos.
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @OpenLedger
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @OpenLedger
自动调用链断了怎么办
50%
Agent 协作扛得住故障吗
50%
2 Voto(s) • Votación cerrada
2
1
455
·
--

Artículo
OPENLEDGER ESTÁ CONSTRUYENDO LA BASE DE UNA IA CONFIABLERecientemente estaba leyendo sobre el envenenamiento de datos y me llevó a una pregunta que parece mucho más grande que el ataque en sí.
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
OPENLEDGER ESTÁ CONSTRUYENDO LA BASE DE UNA IA CONFIABLE
Recientemente estaba leyendo sobre el envenenamiento de datos y me llevó a una pregunta que parece mucho más grande que el ataque en sí.
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
12
7
334
·
--

Artículo
OpenLedger Se Siente Como Una de Esas Ideas Que Crypto Sigue Pretendiendo Que Ya ResolvióHe estado en esta industria el tiempo suficiente para dejar de reaccionar cada vez que alguien dice las palabras “próximo ciclo.” Cada ciclo es, aparentemente, el que finalmente hará que las criptos sean útiles, populares, inteligentes, escalables, descentralizadas, sostenibles, impulsadas por IA, de propiedad de creadores, adoptadas institucionalmente, y cualquier otra frase que se recicla en un lema de conferencia. Y de alguna manera, después de todos estos años, seguimos gastando la mitad de nuestro tiempo viendo a la gente cultivar engagement en Twitter mientras el usuario promedio lucha por explicar por qué siquiera necesita una billetera.
OpenLedger Se Siente Como Una de Esas Ideas Que Crypto Sigue Pretendiendo Que Ya Resolvió
He estado en esta industria el tiempo suficiente para dejar de reaccionar cada vez que alguien dice las palabras “próximo ciclo.” Cada ciclo es, aparentemente, el que finalmente hará que las criptos sean útiles, populares, inteligentes, escalables, descentralizadas, sostenibles, impulsadas por IA, de propiedad de creadores, adoptadas institucionalmente, y cualquier otra frase que se recicla en un lema de conferencia. Y de alguna manera, después de todos estos años, seguimos gastando la mitad de nuestro tiempo viendo a la gente cultivar engagement en Twitter mientras el usuario promedio lucha por explicar por qué siquiera necesita una billetera.
163
·
--
Artículo
El Futuro de las dApps de IA: Conjuntos de Datos Seguros y a Prueba de Manipulación con OpenledgerLa confianza es la moneda más valiosa tanto en sistemas blockchain como en campos de big data.
Cuando los algoritmos de IA ingieren información no verificada, los resultados pueden ser altamente inexactos y profundamente defectuosos.
@Openledger introduce una capa de verificación innovadora que asegura que solo conjuntos de datos verificados y a prueba de manipulaciones se utilicen para propósitos computacionales.
Al crear un historial criptográfico abierto de manejo de datos, están construyendo un marco confiable para futuras dApps de IA.
La economía del protocolo está impulsada directamente por el $OPEN token que asegura el sistema contra actores maliciosos y alimenta los flujos de transacciones.
El Futuro de las dApps de IA: Conjuntos de Datos Seguros y a Prueba de Manipulación con Openledger
La confianza es la moneda más valiosa tanto en sistemas blockchain como en campos de big data.
Cuando los algoritmos de IA ingieren información no verificada, los resultados pueden ser altamente inexactos y profundamente defectuosos.
@OpenLedger introduce una capa de verificación innovadora que asegura que solo conjuntos de datos verificados y a prueba de manipulaciones se utilicen para propósitos computacionales.
Al crear un historial criptográfico abierto de manejo de datos, están construyendo un marco confiable para futuras dApps de IA.
La economía del protocolo está impulsada directamente por el $OPEN token que asegura el sistema contra actores maliciosos y alimenta los flujos de transacciones.
Cuando los algoritmos de IA ingieren información no verificada, los resultados pueden ser altamente inexactos y profundamente defectuosos.
@OpenLedger introduce una capa de verificación innovadora que asegura que solo conjuntos de datos verificados y a prueba de manipulaciones se utilicen para propósitos computacionales.
Al crear un historial criptográfico abierto de manejo de datos, están construyendo un marco confiable para futuras dApps de IA.
La economía del protocolo está impulsada directamente por el $OPEN token que asegura el sistema contra actores maliciosos y alimenta los flujos de transacciones.
90
·
--
OpenLedger y la Economía Emergente de las Blockchains Nativas de IALa convergencia de la inteligencia artificial y la infraestructura blockchain ha creado una nueva frontera competitiva en los mercados de cripto. Mientras que la mayoría de las redes blockchain fueron diseñadas originalmente para transferir valor o ejecutar aplicaciones descentralizadas, una categoría creciente de protocolos ahora se enfoca en coordinar datos, modelos de aprendizaje automático y agentes autónomos de IA. OpenLedger se posiciona dentro de este sector en evolución al intentar resolver una de las mayores ineficiencias en la economía de IA: la incapacidad para monetizar y distribuir de manera eficiente la propiedad de datos y el valor generado por IA a través de redes abiertas.
OpenLedger y la Economía Emergente de las Blockchains Nativas de IA
La convergencia de la inteligencia artificial y la infraestructura blockchain ha creado una nueva frontera competitiva en los mercados de cripto. Mientras que la mayoría de las redes blockchain fueron diseñadas originalmente para transferir valor o ejecutar aplicaciones descentralizadas, una categoría creciente de protocolos ahora se enfoca en coordinar datos, modelos de aprendizaje automático y agentes autónomos de IA. OpenLedger se posiciona dentro de este sector en evolución al intentar resolver una de las mayores ineficiencias en la economía de IA: la incapacidad para monetizar y distribuir de manera eficiente la propiedad de datos y el valor generado por IA a través de redes abiertas.
104
Un libro mayor abierto es un sistema de registro compartido y transparente en el que cada transacción es visible públicamente y puede ser verificada por cualquiera. A diferencia de las bases de datos privadas, elimina la necesidad de una autoridad central, porque la confianza proviene del consenso distribuido. El uso más famoso de un libro mayor abierto se encuentra en la tecnología blockchain: registra las entradas de forma cronológica, haciéndolas a prueba de manipulaciones una vez confirmadas. Esta transparencia reduce el fraude, aumenta la rendición de cuentas y permite auditorías independientes sin necesidad de permiso. Las empresas, los gobiernos y los sistemas financieros utilizan libros mayores abiertos para rastrear activos, contratos y pagos de manera abierta. Aunque aumenta la confianza, la privacidad debe gestionarse con cuidado ya que los datos son públicos. En general, los libros mayores abiertos promueven la equidad al dar a todos los participantes acceso igualitario a la misma información veraz.
#openledger $OPEN @Openledger
Un libro mayor abierto es un sistema de registro compartido y transparente en el que cada transacción es visible públicamente y puede ser verificada por cualquiera. A diferencia de las bases de datos privadas, elimina la necesidad de una autoridad central, porque la confianza proviene del consenso distribuido. El uso más famoso de un libro mayor abierto se encuentra en la tecnología blockchain: registra las entradas de forma cronológica, haciéndolas a prueba de manipulaciones una vez confirmadas. Esta transparencia reduce el fraude, aumenta la rendición de cuentas y permite auditorías independientes sin necesidad de permiso. Las empresas, los gobiernos y los sistemas financieros utilizan libros mayores abiertos para rastrear activos, contratos y pagos de manera abierta. Aunque aumenta la confianza, la privacidad debe gestionarse con cuidado ya que los datos son públicos. En general, los libros mayores abiertos promueven la equidad al dar a todos los participantes acceso igualitario a la misma información veraz.
#openledger $OPEN @OpenLedger
#openledger $OPEN @OpenLedger
124
·
--
Antes, lo que más me preocupaba de los puentes cross-chain no era la lentitud, sino ese momento en que "crees que no hay movimiento, te tiembla la mano y haces clic de nuevo", y entonces la misma acción se convierte en dos. — Cuando esto pasa, ni siquiera te atreves a reconocerlo en tu análisis: ¿fue el sistema que no aclaró el estado, o fuiste tú que te colapsaste mentalmente? Cuanto más intentas integrar el puente en un proceso automatizado, más mortal es este error, porque ejecutar la acción dos veces no es "perder un poco", sino que desordena completamente la lógica.
Ahora, al ver el EVM Bridge de @Openledger , lo evalúo con un estándar bastante rudimentario: ¿puede este paso de puente convertirse en un checkpoint claro, en lugar de ser una "acción sin límites visibles"? Cuando OctoClaw genera una acción, si este paso es cross-chain, espero que pueda vincular "este puente" como una referencia única: si luego vuelves a activar la misma acción, el sistema no debería simplemente volver a ejecutarla en silencio, sino que debería decirte claramente: — esta transacción está en proceso/ya se completó/no se permite repetir. Puedes seguir optimizando la conexión con el trading agent, pero para acciones de alto riesgo como el puente, es crucial eliminar la posibilidad de "ejecuciones duplicadas". De lo contrario, cuanto más automatizado sea, más parecerá que estás sembrando minas.
Hoy solo dejo un punto de verificación: cuando se vuelve a activar la misma acción de puente, ¿puede el sistema devolver directamente la misma referencia de ejecución y dar un estado claro (en proceso/completado), mientras rechaza la creación de un segundo puente? Si se puede lograr esto, consideraré el Bridge como una capacidad de ejecución; si no, preferiría dejar este paso para confirmación manual.
@Openledger $OPEN #OpenLedger
Antes, lo que más me preocupaba de los puentes cross-chain no era la lentitud, sino ese momento en que "crees que no hay movimiento, te tiembla la mano y haces clic de nuevo", y entonces la misma acción se convierte en dos. — Cuando esto pasa, ni siquiera te atreves a reconocerlo en tu análisis: ¿fue el sistema que no aclaró el estado, o fuiste tú que te colapsaste mentalmente? Cuanto más intentas integrar el puente en un proceso automatizado, más mortal es este error, porque ejecutar la acción dos veces no es "perder un poco", sino que desordena completamente la lógica.
Ahora, al ver el EVM Bridge de @OpenLedger , lo evalúo con un estándar bastante rudimentario: ¿puede este paso de puente convertirse en un checkpoint claro, en lugar de ser una "acción sin límites visibles"? Cuando OctoClaw genera una acción, si este paso es cross-chain, espero que pueda vincular "este puente" como una referencia única: si luego vuelves a activar la misma acción, el sistema no debería simplemente volver a ejecutarla en silencio, sino que debería decirte claramente: — esta transacción está en proceso/ya se completó/no se permite repetir. Puedes seguir optimizando la conexión con el trading agent, pero para acciones de alto riesgo como el puente, es crucial eliminar la posibilidad de "ejecuciones duplicadas". De lo contrario, cuanto más automatizado sea, más parecerá que estás sembrando minas.
Hoy solo dejo un punto de verificación: cuando se vuelve a activar la misma acción de puente, ¿puede el sistema devolver directamente la misma referencia de ejecución y dar un estado claro (en proceso/completado), mientras rechaza la creación de un segundo puente? Si se puede lograr esto, consideraré el Bridge como una capacidad de ejecución; si no, preferiría dejar este paso para confirmación manual.
@OpenLedger $OPEN #OpenLedger
Ahora, al ver el EVM Bridge de @OpenLedger , lo evalúo con un estándar bastante rudimentario: ¿puede este paso de puente convertirse en un checkpoint claro, en lugar de ser una "acción sin límites visibles"? Cuando OctoClaw genera una acción, si este paso es cross-chain, espero que pueda vincular "este puente" como una referencia única: si luego vuelves a activar la misma acción, el sistema no debería simplemente volver a ejecutarla en silencio, sino que debería decirte claramente: — esta transacción está en proceso/ya se completó/no se permite repetir. Puedes seguir optimizando la conexión con el trading agent, pero para acciones de alto riesgo como el puente, es crucial eliminar la posibilidad de "ejecuciones duplicadas". De lo contrario, cuanto más automatizado sea, más parecerá que estás sembrando minas.
Hoy solo dejo un punto de verificación: cuando se vuelve a activar la misma acción de puente, ¿puede el sistema devolver directamente la misma referencia de ejecución y dar un estado claro (en proceso/completado), mientras rechaza la creación de un segundo puente? Si se puede lograr esto, consideraré el Bridge como una capacidad de ejecución; si no, preferiría dejar este paso para confirmación manual.
@OpenLedger $OPEN #OpenLedger
188
·
--
Artículo
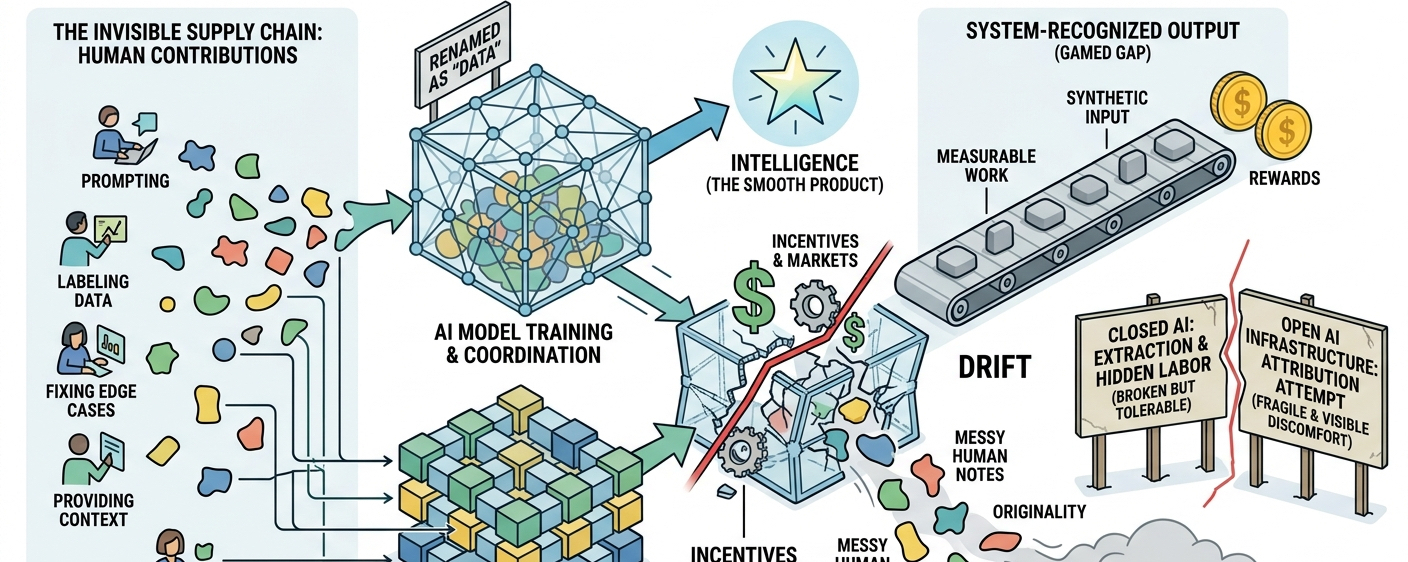
La infraestructura se rompe donde la memoria se vuelve valiosaAl principio no lo tomé en serio.
no porque OpenLedger sonara vacío. más bien porque he visto suficientes ciclos de infraestructura cripto para saber lo rápido que las ideas serias se convierten en narrativas. un mes es coordinación. luego propiedad. luego verificación. luego 'abierto' todo. y por un tiempo, el lenguaje se siente lo suficientemente limpio como para creer.
luego el sistema se encuentra con incentivos.
y los incentivos nunca son limpios.
Quizás eso es demasiado duro. quizás solo estoy cansado de ver cómo los protocolos lentamente dejan de centrarse en su problema original y más en los mercados que se formaron a su alrededor. pero esa fatiga es difícil de desconectar, especialmente con cualquier cosa que se sitúe entre IA, datos, propiedad y recompensas económicas.
La infraestructura se rompe donde la memoria se vuelve valiosa
Al principio no lo tomé en serio.
no porque OpenLedger sonara vacío. más bien porque he visto suficientes ciclos de infraestructura cripto para saber lo rápido que las ideas serias se convierten en narrativas. un mes es coordinación. luego propiedad. luego verificación. luego 'abierto' todo. y por un tiempo, el lenguaje se siente lo suficientemente limpio como para creer.
luego el sistema se encuentra con incentivos.
y los incentivos nunca son limpios.
Quizás eso es demasiado duro. quizás solo estoy cansado de ver cómo los protocolos lentamente dejan de centrarse en su problema original y más en los mercados que se formaron a su alrededor. pero esa fatiga es difícil de desconectar, especialmente con cualquier cosa que se sitúe entre IA, datos, propiedad y recompensas económicas.
no porque OpenLedger sonara vacío. más bien porque he visto suficientes ciclos de infraestructura cripto para saber lo rápido que las ideas serias se convierten en narrativas. un mes es coordinación. luego propiedad. luego verificación. luego 'abierto' todo. y por un tiempo, el lenguaje se siente lo suficientemente limpio como para creer.
luego el sistema se encuentra con incentivos.
y los incentivos nunca son limpios.
Quizás eso es demasiado duro. quizás solo estoy cansado de ver cómo los protocolos lentamente dejan de centrarse en su problema original y más en los mercados que se formaron a su alrededor. pero esa fatiga es difícil de desconectar, especialmente con cualquier cosa que se sitúe entre IA, datos, propiedad y recompensas económicas.
2
1
140
·
--
Artículo
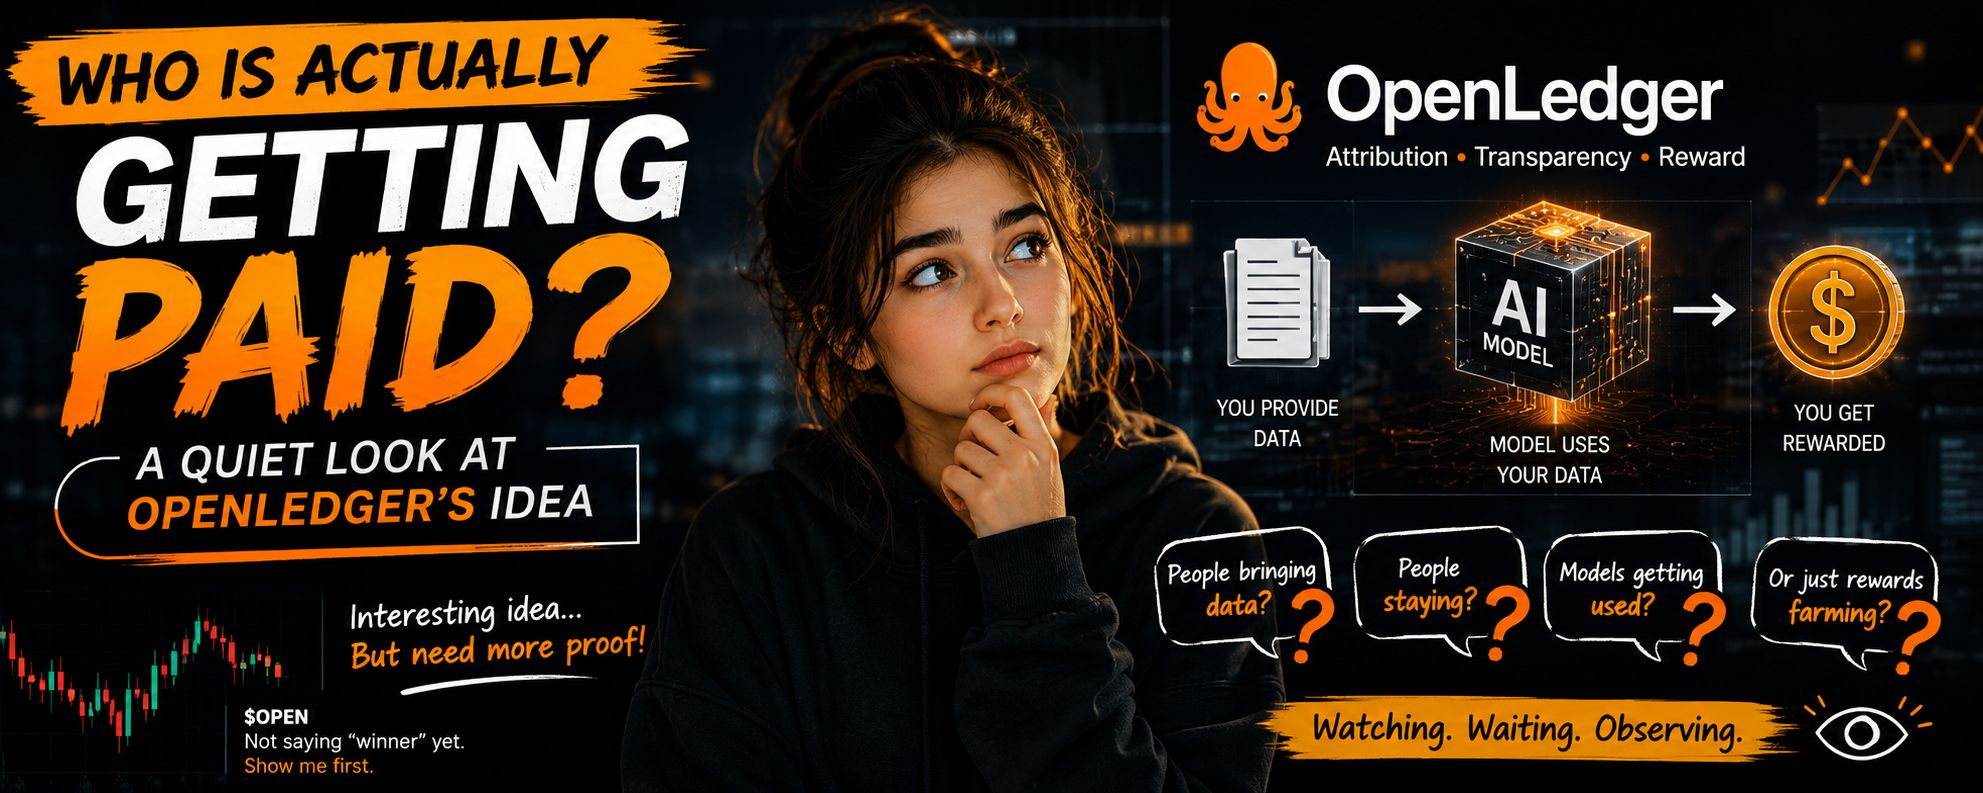
¿Quién Está Realmente Recibiendo Pagos? Una Mirada Silenciosa a la Idea de OpenLedger @Openledger ... Ya he visto esto antes... tal vez hace unos meses. El gráfico estaba haciendo su cosa habitual... sube y baja, sube y baja. Pero mi mente se quedó atrapada en una pregunta extraña.
¿Quién está realmente recibiendo pagos?
No, en serio... todos siguen hablando sobre datos de IA, modelos, la gran visión futura. Está bien, palabras bonitas. Pero si todo esto realmente está funcionando... entonces, ¿quién está ganando el dinero? Estoy observando, pero la respuesta no se siente tan clara.
Entonces vi #OpenLedger y esta idea de "atribución". Suena como una palabra elegante... pero tal vez sea simple en su esencia.
¿Quién Está Realmente Recibiendo Pagos? Una Mirada Silenciosa a la Idea de OpenLedger
@OpenLedger ... Ya he visto esto antes... tal vez hace unos meses. El gráfico estaba haciendo su cosa habitual... sube y baja, sube y baja. Pero mi mente se quedó atrapada en una pregunta extraña.
¿Quién está realmente recibiendo pagos?
No, en serio... todos siguen hablando sobre datos de IA, modelos, la gran visión futura. Está bien, palabras bonitas. Pero si todo esto realmente está funcionando... entonces, ¿quién está ganando el dinero? Estoy observando, pero la respuesta no se siente tan clara.
Entonces vi #OpenLedger y esta idea de "atribución". Suena como una palabra elegante... pero tal vez sea simple en su esencia.
¿Quién está realmente recibiendo pagos?
No, en serio... todos siguen hablando sobre datos de IA, modelos, la gran visión futura. Está bien, palabras bonitas. Pero si todo esto realmente está funcionando... entonces, ¿quién está ganando el dinero? Estoy observando, pero la respuesta no se siente tan clara.
Entonces vi #OpenLedger y esta idea de "atribución". Suena como una palabra elegante... pero tal vez sea simple en su esencia.
14
5
299
Inicia sesión para explorar más contenidos
Únete a usuarios globales de criptomonedas en Binance Square
⚡️ Obtén información útil y actualizada sobre criptos.
💬 Avalado por el mayor exchange de criptomonedas en el mundo.
👍 Descubre perspectivas reales de creadores verificados.
Email/número de teléfono
Temas populares
1
#BinanceReopensWithdrawalsForMoreAssets
1.1M vistas
5,735 están debatiendo
2
#$2TWipedOutHedgeFundsFaceLiquidation
237 vistas
18 están debatiendo
3
#AnthropicIPOValuationDoubts
12,669 vistas
362 están debatiendo
4
#SouthKoreaDelaysCryptoTaxationUntil2029
627 vistas
33 están debatiendo
5
#HongKongPlansTaxIncentivesCoveringDigitalAssets
560 vistas
20 están debatiendo
6
#ECBTargetsDigitalEuroIssuanceIn2029
553 vistas
25 están debatiendo
7
#ChainalysisBreachExposedPasswordHashesAndLiveTokens
146 vistas
4 están debatiendo
8
#UkraineCentralBankOpposesCurrentCryptoAssetBill
1,596 vistas
51 están debatiendo
9
#CoreScientificExpectsToExitBitcoinMiningByYearEnd2026
333 vistas
10 están debatiendo
10
#USStocksSlipandCryptoMarketUnderBroadPressure
127,502 vistas
769 están debatiendo