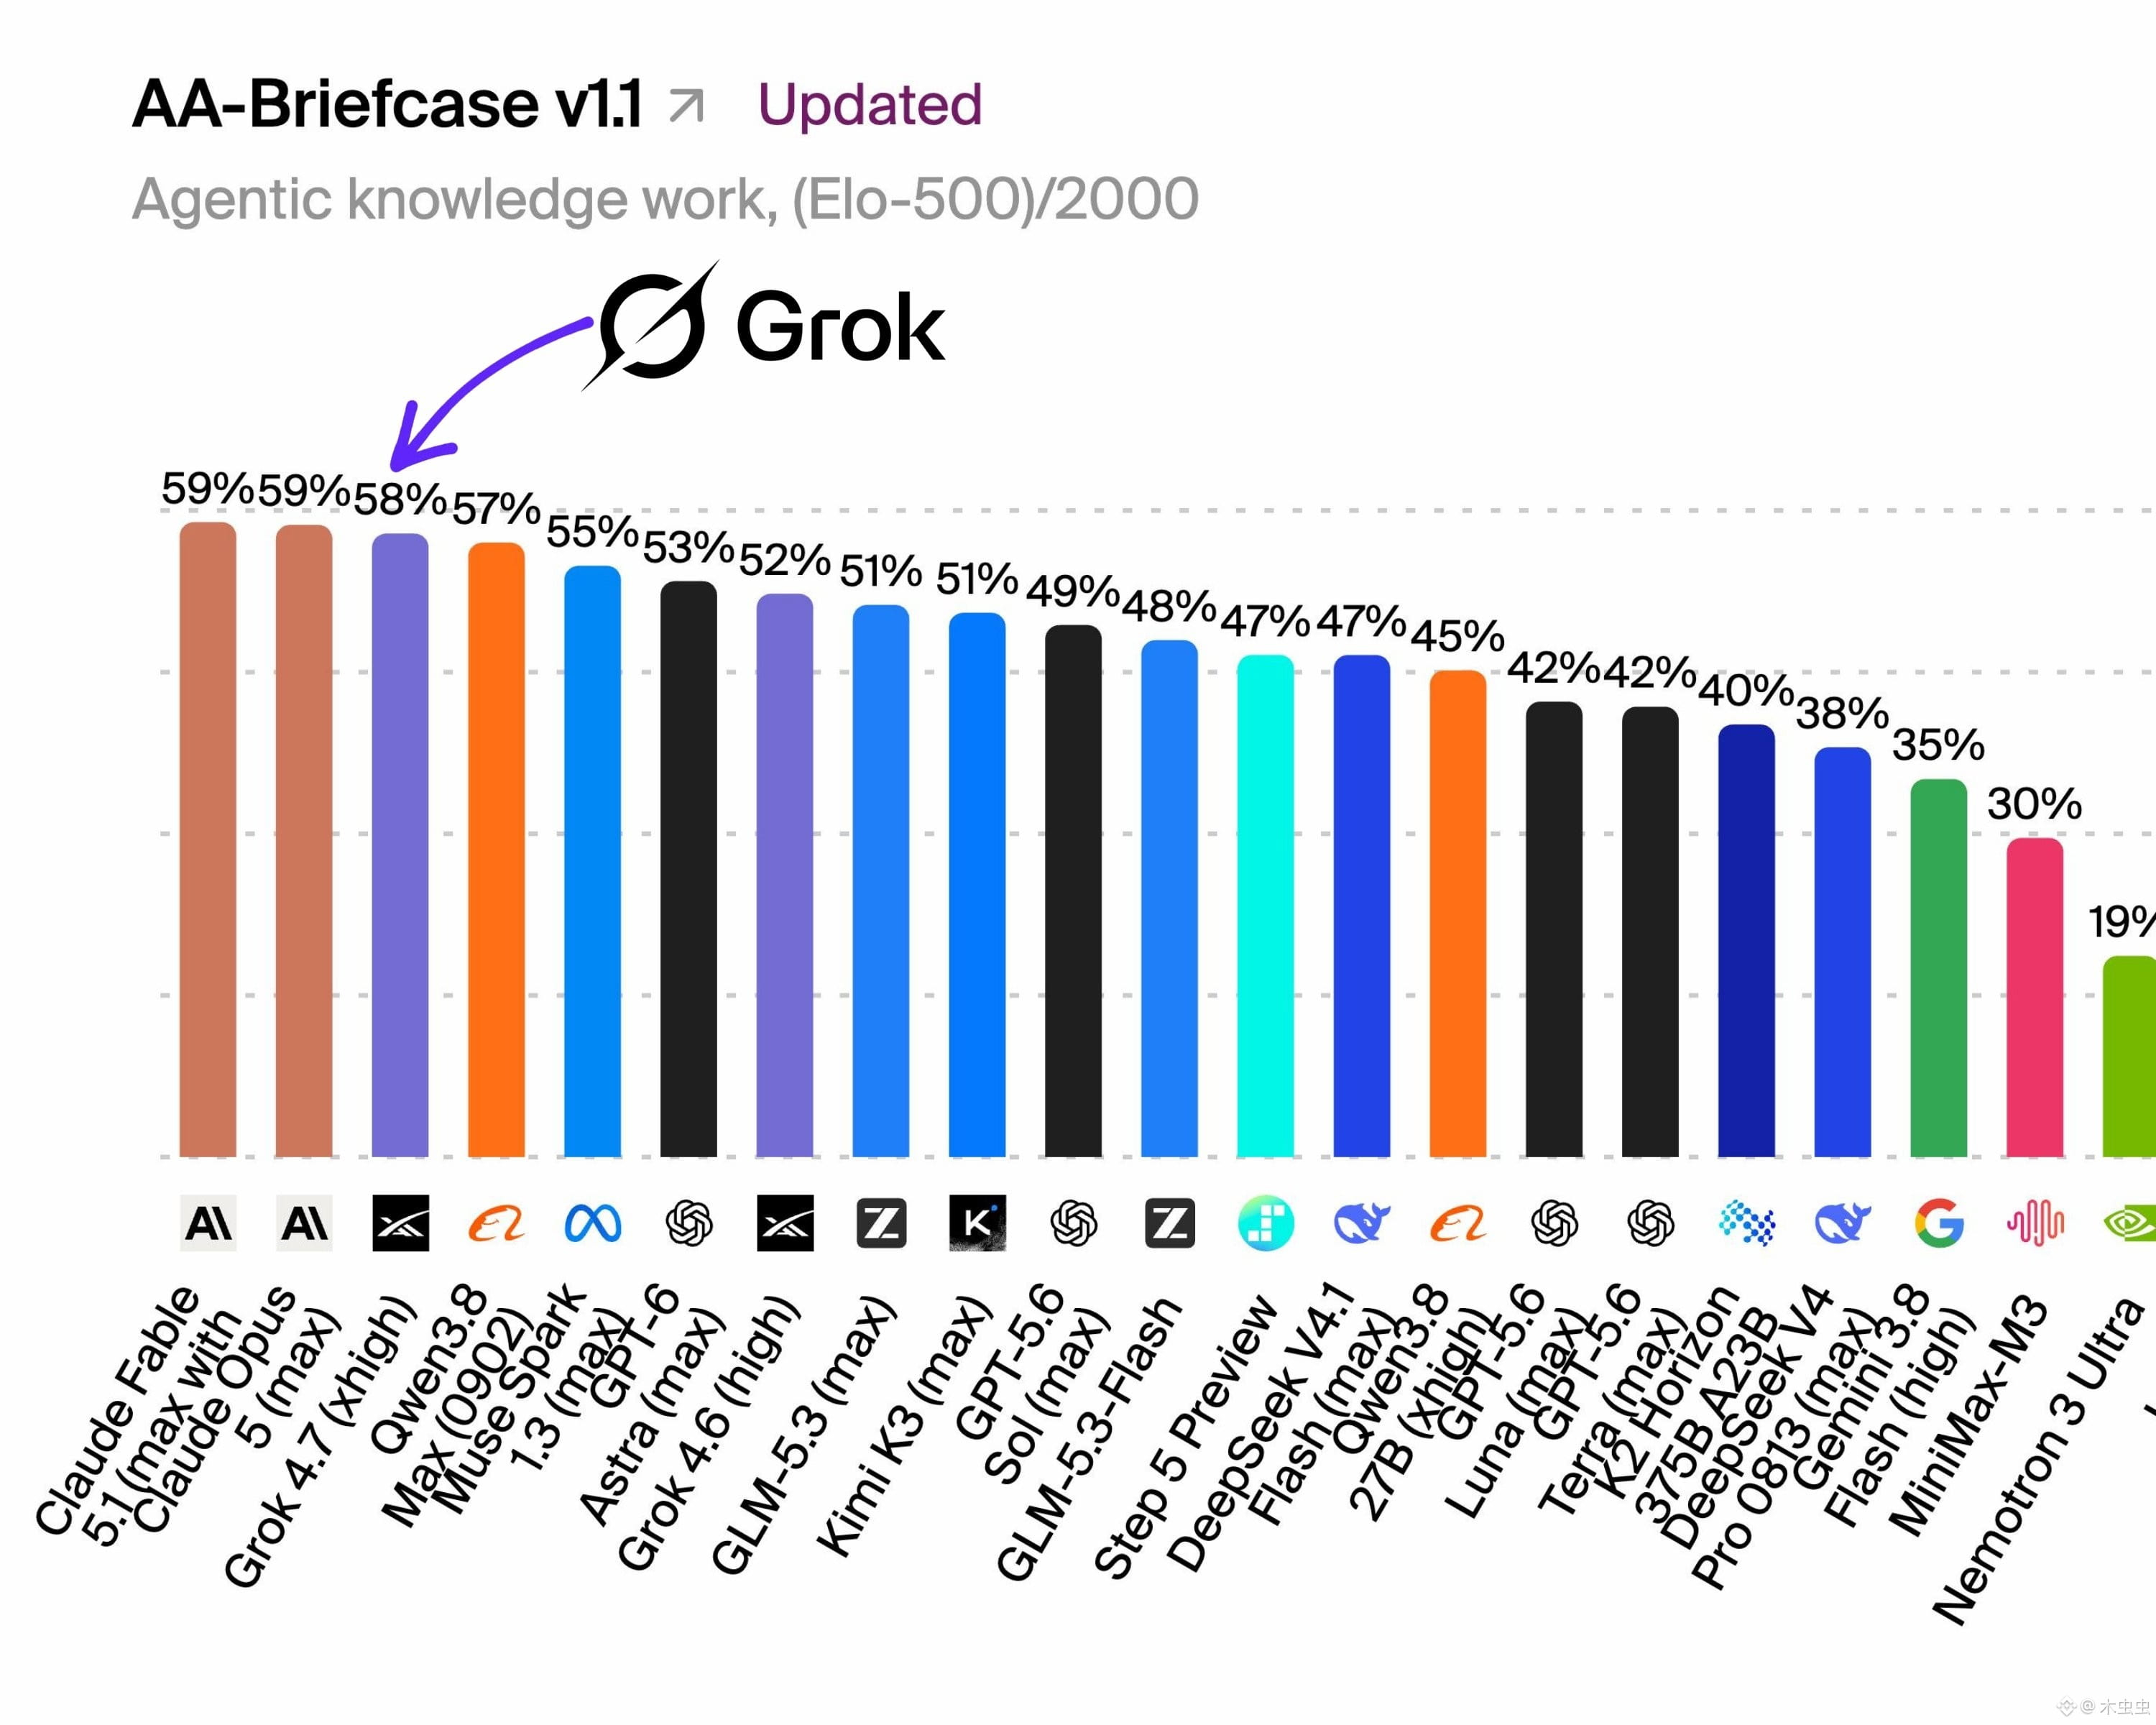
Grok 4.7 xHigh ya está en la cima con solo UN punto de diferencia respecto a Claude Fable 5.1 Max en el benchmark AA-Briefcase de Artificial Analysis
Claude Fable 5.1 Max — 59%
Grok 4.7 xHigh — 58%
Solo una diferencia de 1 punto en la parte más alta
Y Grok está por delante de GPT-6 Astra, GPT-5.6, Gemini, Kimi, GLM y prácticamente de cualquier otro modelo de frontera en el benchmark
Claude Fable 5.1 Max — 59%
Grok 4.7 xHigh — 58%
Solo una diferencia de 1 punto en la parte más alta
Y Grok está por delante de GPT-6 Astra, GPT-5.6, Gemini, Kimi, GLM y prácticamente de cualquier otro modelo de frontera en el benchmark