

Sigo volviendo a una pregunta simple que parece estar debajo de gran parte del cripto: ¿qué es exactamente lo que se posee cuando un sistema dice que es “descentralizado”? En pagos, la propiedad es bastante obvia. En préstamos, es capital. En blockchains diseñadas para computación, la respuesta se vuelve menos clara, porque lo más valioso a menudo no es el libro mayor en sí, sino los datos, modelos y sistemas de coordinación que lo alimentan. OpenLedger está intentando hacer visible esa capa oculta. En su propio sitio, se describe como una blockchain de IA diseñada para desbloquear liquidez alrededor de datos, modelos y agentes, y su libro blanco enmarca el proyecto en torno a un mecanismo llamado Prueba de Atribución. Ese marco ya me dice algo importante: esto es menos una afirmación de que la IA debería estar “onchain” en algún sentido abstracto, y más una propuesta de que las entradas a la IA deberían ser rastreadas, acreditadas y hechas económicamente legibles.
El problema que aborda no apareció de la noche a la mañana. Durante años, los sistemas de IA han mejorado al absorber enormes cantidades de datos de fuentes públicas y privadas, pero las personas que ensamblaron, limpiaron, etiquetaron o especializaron esos datos rara vez tuvieron una ruta fiable hacia el reconocimiento o la compensación. El propio paper de OpenLedger lo dice directamente: los datos de entrenamiento a menudo se tratan como anónimos y estáticos, mientras que los contribuidores permanecen desconectados del valor que sus datos ayudan a crear. Eso no es solo un reclamo ético. También es un problema estructural, porque una vez que los datos se reducen a una entrada invisible, hay poca razón para que los externos sigan contribuyendo con material de alta calidad y específico del dominio. El resultado es un patrón cripto familiar en otra forma: el valor se concentra en el centro mientras que la procedencia pasa a ser un simple detalle.
Los intentos anteriores de resolver este problema generalmente han fallado por una de dos razones. Algunos sistemas intentaron construir mercados para conjuntos de datos, pero se quedaron en listar o licenciar, sin rastrear cómo una contribución específica dio forma a una salida específica. Otros se centraron en la transparencia del modelo en un sentido amplio, lo cual es útil, pero aun así no responde a la pregunta más difícil: la atribución. El whitepaper de OpenLedger es explícito en que quiere un vínculo verificable entre el comportamiento del modelo y los datos de entrenamiento que influyeron en él, con recompensas distribuidas a partir de ese vínculo. Es una afirmación más ambiciosa que la simple apertura. Está intentando convertir la atribución en infraestructura, no solo en documentación. La diferencia importa, porque la documentación puede ignorarse mientras que la infraestructura es más difícil de esquivar.
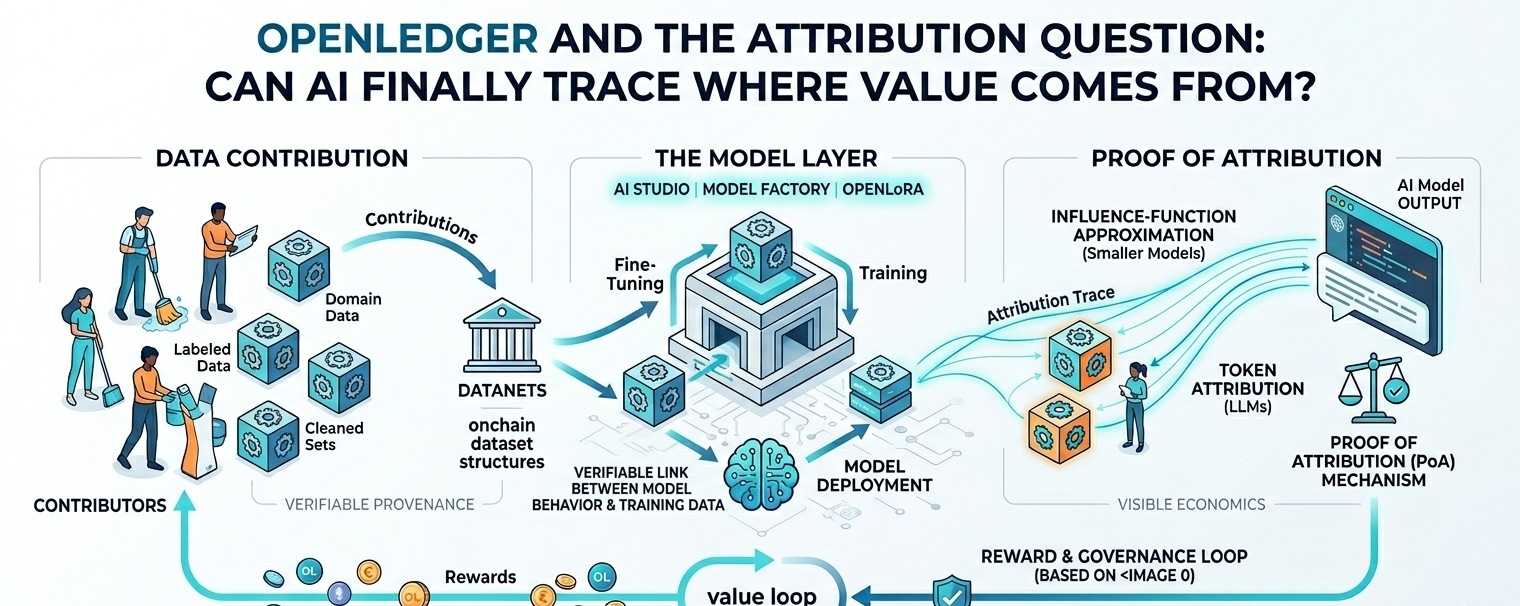
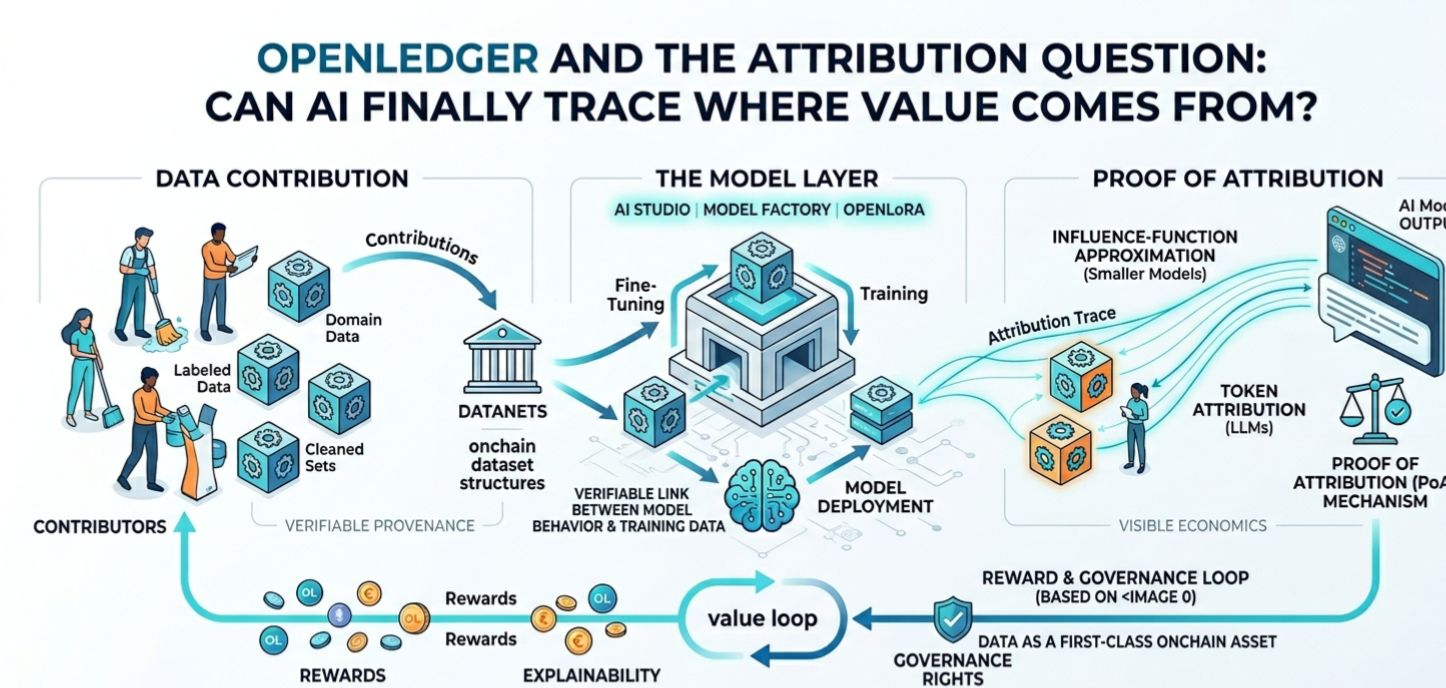
La arquitectura que describe OpenLedger tiene varias piezas en movimiento, y la lógica de diseño es bastante fácil de seguir. En el centro están DataNets, que el documento describe como estructuras de datos onchain construidas mediante contribución comunitaria. En los materiales del propio proyecto, los DataNets son donde las comunidades co-crean, curan y contribuyen conjuntos de datos que luego influyen en el entrenamiento de modelos. Luego viene la capa de modelo: OpenLedger describe un AI Studio, una Model Factory y OpenLoRA. El primero es para construir, el segundo para afinar y el tercero para una implementación más barata. La idea más amplia es que la recolección de datos, el entrenamiento de modelos y el servicio de modelos no son mundos separados; están ligados por la procedencia, la atribución y la recompensa. Ese vínculo es la tesis central del proyecto.
Proof of Attribution es donde esa tesis se vuelve concreta. En el whitepaper, OpenLedger afirma que usa dos métodos diferentes de atribución según el tamaño del modelo: aproximaciones de función de influencia para modelos más pequeños y atribución de tokens basada en matrices de sufijos para modelos más grandes. Eso me dice que el equipo es consciente de que la atribución no es un único problema técnico uniforme. Los modelos pequeños pueden manejarse con aproximaciones basadas en gradientes de cómo cambiaría la pérdida al eliminar un punto de datos, mientras que los modelos lingüísticos grandes necesitan un enfoque distinto que compara tokens de salida con una representación comprimida del corpus de entrenamiento. La lógica es sensata, pero también revela la dificultad: el sistema no está “probando” una contribución en un sentido legal. Lo que hace es estimar la influencia con la mejor maquinaria disponible y, luego, usar esa estimación para dividir el crédito y las recompensas.
Encuentro importante esa distinción porque mantiene el proyecto honesto. Mucho de lo que se dice sobre atribución en IA suena más exacto de lo que realmente es. El diseño de OpenLedger es más cuidadoso que eso. El paper afirma que las salidas del modelo, los metadatos y las marcas de tiempo se comprometen en la cadena, y que la atribución se calcula después de la inferencia para que las recompensas a los contribuidores puedan distribuirse según la influencia relativa. Eso hace que el sistema sea auditable, pero no mágicamente perfecto. Puede mostrar una cadena de procedencia y una ruta de recompensas; no puede borrar la ambigüedad que siempre vive dentro de los sistemas complejos de aprendizaje automático. La atribución en IA rara vez es un registro contable limpio. Usualmente es una aproximación envuelta en una política. Parece que OpenLedger entiende eso, incluso mientras presenta la aproximación como un primitivo del protocolo.
Aquí es también donde el proyecto empieza a parecer menos un eslogan y más un experimento serio. OpenLedger dice que no es una cadena de propósito general. Está enfocada en IA y flujos de trabajo de modelos, e incluso se contrasta con blockchains generales al enfatizar la atribución nativa de datos, la procedencia y la gobernanza en torno a la calidad del modelo, en lugar de cambios al protocolo. En el papel, esa especialización es atractiva. Demasiados sistemas cripto intentan ser todo a la vez, lo que normalmente significa que se vuelven vagos justo en el momento en que necesitan ser precisos. El alcance más estrecho de OpenLedger le da un trabajo más claro: hacer seguimiento de dónde provienen los datos de IA, quién los contribuyó, cómo influyeron en los modelos y cómo se distribuyen las recompensas. Ese es un marco coherente. Si es suficiente, es otra pregunta.
Sin embargo, la promesa técnica no elimina los compromisos. Un sistema como este tiene que asumir el peso del registro, la verificación, el balance contable de inferencias, la distribución de recompensas y la gobernanza, todo mientras intenta seguir siendo útil para desarrolladores que quizá no quieran fricción adicional en su flujo de trabajo. El documento sugiere un grafo público de atribución e incluso insinúa que los derechos de gobernanza podrían reflejar más adelante la influencia de un conjunto de datos a través de modelos. Es intelectualmente interesante, pero también plantea problemas familiares: ¿quién decide las reglas de atribución?, ¿cómo se gestionan las disputas?, ¿qué ocurre cuando un conjunto de datos se reutiliza de maneras que el contribuidor original no esperaba?, y ¿qué tan costoso se vuelve el sistema a medida que escala el uso? Estos no son asuntos secundarios. Son la diferencia entre un marco que puede admirarse y un marco que puede adoptarse.
También hay una preocupación más sutil sobre qué se mide. Si la atribución se convierte en la base para las recompensas, entonces la noción de influencia del protocolo empieza a moldear el comportamiento de los contribuidores. Eso puede ser saludable, porque fomenta datos de mayor calidad y una curación más deliberada. También puede reducir incentivos de maneras no intencionadas, porque los contribuidores podrían optimizar la influencia trazable en lugar de la utilidad amplia. Los materiales de OpenLedger describen flujos de recompensas, explicabilidad y pruebas ligadas a cada respuesta; es exactamente el tipo de mecanismo que puede mejorar la rendición de cuentas. Pero el mismo mecanismo puede generar presión para simplificar contribuciones complejas en aquello que el sistema de atribución pueda reconocer con mayor facilidad. En otras palabras, el protocolo puede recompensar lo que puede medir antes de comprender del todo lo que importa. No es una falla exclusiva de OpenLedger, pero sí es una restricción real de diseño.
La adopción es otro obstáculo silencioso. Un proyecto como este necesita más que una narrativa sólida. Necesita conjuntos de datos que valga la pena contribuir, desarrolladores dispuestos a entrenar o afinar a través de su pila, y usuarios de modelos que se preocupen lo suficiente por la procedencia como para preferir un sistema más responsable antes que uno más simple. Las propias páginas del ecosistema de OpenLedger señalan productos como Explorer, staking, AI Studio y una capa comunitaria de Open Circle, lo que sugiere que intenta construir el área social y técnica necesaria para una participación sostenida. Tiene sentido. Pero la infraestructura solo importa si las personas que usan IA sienten la ausencia de procedencia como un costo real. Muchos no lo hacen, al menos todavía no. Entonces, la primera audiencia de un sistema así probablemente sea la gente que ya está más cerca del problema: contribuidores de datos, desarrolladores de modelos de nicho, auditores y comunidades que intentan crear IA específica de dominio con cierta trazabilidad intacta.
Eso aún deja abierta una incertidumbre mayor, que probablemente es lo más interesante de OpenLedger. Está intentando convertir los datos en un activo onchain de primera clase, y esa idea resulta más convincente de lo que suena al principio, porque la IA realmente depende de una cadena de contribución que normalmente permanece oculta. Sin embargo, cuanto más se apoya el proyecto en la atribución, más debe demostrar que el sistema es lo suficientemente preciso, ligero y justo como para sobrevivir más allá del whitepaper. Puedo ver por qué el problema sigue resurgiendo: la IA sigue consumiendo más valor del que puede devolver de manera transparente. OpenLedger es un intento de responder a ese desequilibrio. La pregunta no resuelta es si el futuro de la IA realmente recompensará a los sistemas que hacen visible la contribución, o si la visibilidad en sí misma seguirá siendo demasiado costosa para que el mercado la adopte plenamente.