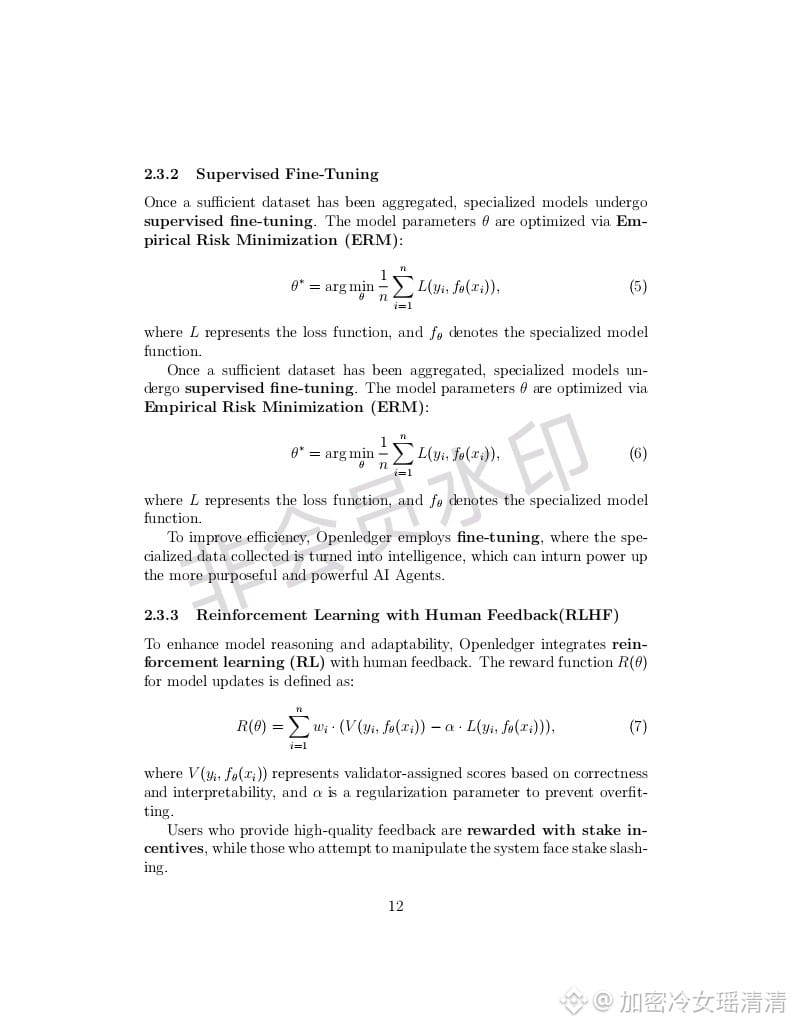
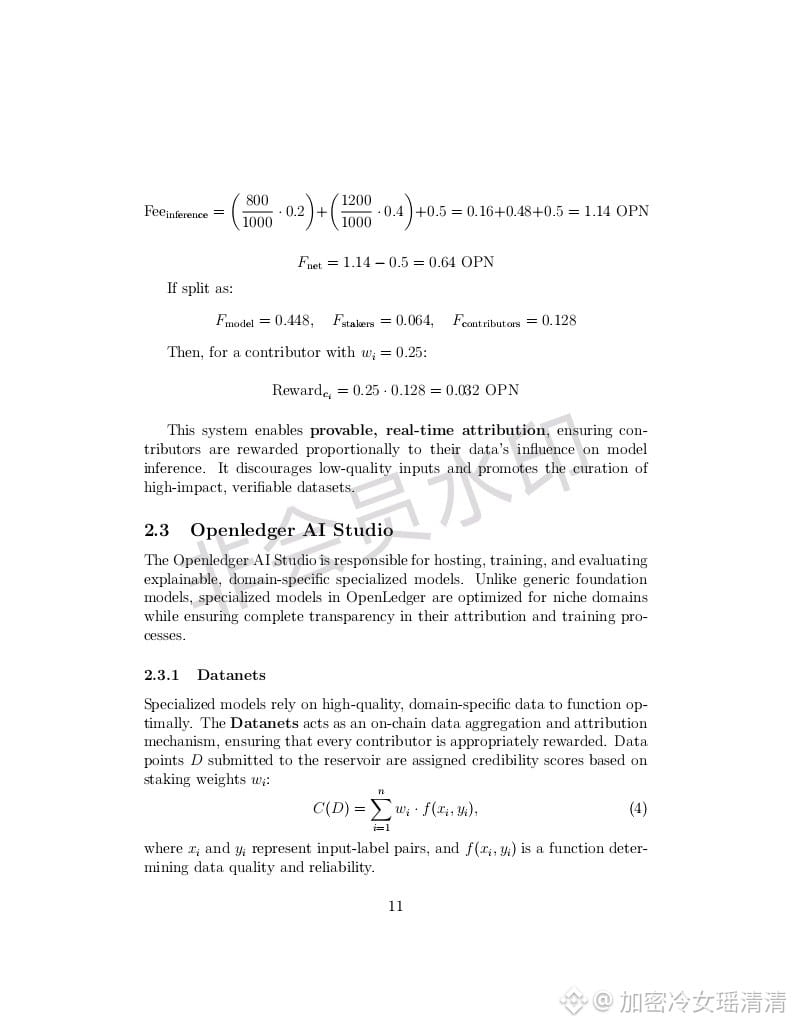
Primero, voy a contar una experiencia real. Tengo un lote de datos etiquetados, alrededor de mil doscientas líneas, que antes solo ocupaban espacio en el disco duro. Hasta que probé con la prueba de atribución de #OpenLedger ; los datos son llamados por el modelo y se registran automáticamente. Subí trescientas líneas para ejecutar una tarea de inferencia y en la cadena realmente me calcularon el valor de contribución. Aunque no fue mucho dinero, la sensación es diferente; tu información se usa y puedes ver el registro. He tenido Bitcoin y Ethereum durante varios años, pero esas dos manejan transferencias de billetera, y con la distribución de ingresos de datos de IA, no tiene nada que ver.
Hoy, Octoclaw, me pasé otras dos horas experimentando. La configuración en la nube fue mucho más fluida que la última vez, y había varias configuraciones predeterminadas. Elegí una plantilla ligera y subí los datos directamente. Hice una transferencia a través del puente cruzado de $OPEN de la red de prueba a la red principal. En menos de tres minutos lo terminé. Antes, al usar otros puentes, a veces se quedaba parado media hora. Esta vez fue realmente estable. Incluso fui a revisar los registros de atribución. En los datos que subí, hubo diez líneas que fueron llamadas; cada llamada llevaba mi etiqueta de cadena y una marca de tiempo. El costo de falsificar esto es demasiado alto.
También tengo que mencionar que el algoritmo de atribución en la documentación está escrito de manera demasiado académica. Lo revisé dos veces antes de entender más o menos cómo se calcula el peso. Los novatos se quedarán confundidos al principio, pero en general, estoy de acuerdo con la dirección @OpenLedger ; estoy dispuesto a mostrar cada atribución en la cadena. Eso es mucho más realista que aquellos que solo gritan consignas. A continuación, planeo subir quinientas líneas más de datos y correr un mes para ver cómo van los ingresos a largo plazo. Si hay algún problema, te avisaré de inmediato. Si hay buenas noticias, también las compartiré.
Hoy, Octoclaw, me pasé otras dos horas experimentando. La configuración en la nube fue mucho más fluida que la última vez, y había varias configuraciones predeterminadas. Elegí una plantilla ligera y subí los datos directamente. Hice una transferencia a través del puente cruzado de $OPEN de la red de prueba a la red principal. En menos de tres minutos lo terminé. Antes, al usar otros puentes, a veces se quedaba parado media hora. Esta vez fue realmente estable. Incluso fui a revisar los registros de atribución. En los datos que subí, hubo diez líneas que fueron llamadas; cada llamada llevaba mi etiqueta de cadena y una marca de tiempo. El costo de falsificar esto es demasiado alto.
También tengo que mencionar que el algoritmo de atribución en la documentación está escrito de manera demasiado académica. Lo revisé dos veces antes de entender más o menos cómo se calcula el peso. Los novatos se quedarán confundidos al principio, pero en general, estoy de acuerdo con la dirección @OpenLedger ; estoy dispuesto a mostrar cada atribución en la cadena. Eso es mucho más realista que aquellos que solo gritan consignas. A continuación, planeo subir quinientas líneas más de datos y correr un mes para ver cómo van los ingresos a largo plazo. Si hay algún problema, te avisaré de inmediato. Si hay buenas noticias, también las compartiré.