


Gracias a Brian Retford, SunYi, Jason Morton, Shumo, Feng Boyuan, Daniel, Aaron Greenblatt, Nick Matthew, Baz, Marcin y Brent por sus valiosos conocimientos, comentarios y reseñas de este artículo.
Autor: Grace&Hill
Para nosotros, los entusiastas de las criptomonedas, la inteligencia artificial ha estado de moda durante un tiempo. Curiosamente, nadie quiere ver a la IA enloquecida. La intención original de la invención de blockchain es evitar que el dólar se salga de control, por lo que podemos intentar evitar que la inteligencia artificial se salga de control. Además, ahora contamos con una nueva tecnología llamada pruebas de conocimiento cero para garantizar que las cosas no salgan mal. Sin embargo, para aprovechar la bestia que es la IA, debemos entender cómo funciona.
Una breve introducción al aprendizaje automático
La inteligencia artificial ha pasado por varios cambios de nombre, de "sistemas expertos" a "redes neuronales", luego a "modelos gráficos" y finalmente a "aprendizaje automático". Todos estos son subconjuntos de “inteligencia artificial” que reciben diferentes nombres y nuestra comprensión de la IA continúa creciendo. Profundicemos un poco más en el aprendizaje automático y desmitificémoslo.
Nota: Hoy en día, la mayoría de los modelos de aprendizaje automático son redes neuronales debido a su rendimiento superior en muchas tareas. Nos referimos principalmente al aprendizaje automático como aprendizaje automático de redes neuronales.
¿Cómo funciona el aprendizaje automático?
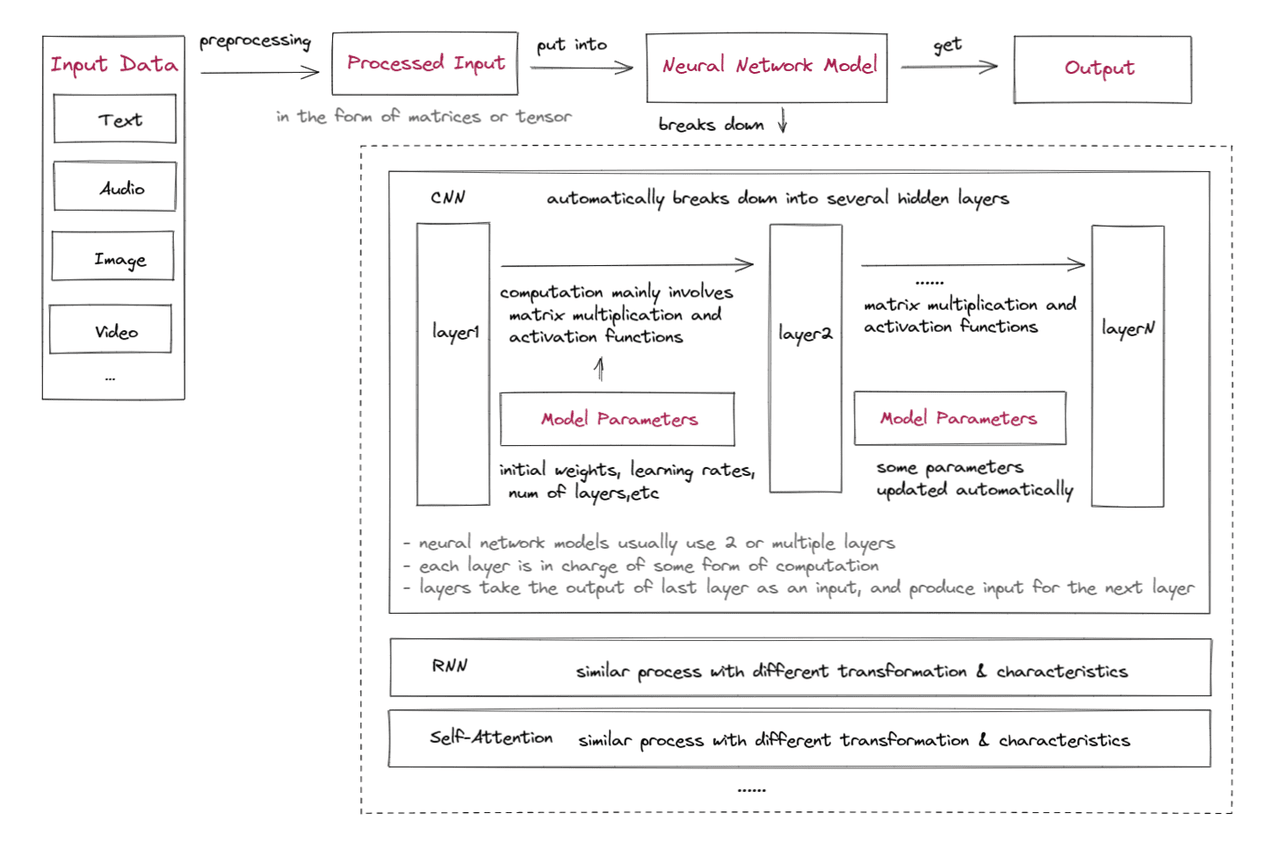 Primero, echemos un vistazo rápido al funcionamiento interno del aprendizaje automático:
Preprocesamiento de datos de entrada: los datos de entrada deben procesarse en un formato que pueda usarse como entrada del modelo. Esto generalmente implica preprocesamiento e ingeniería de características para extraer información útil y convertir los datos en una forma adecuada, como matrices de entrada o tensores (matrices de alta dimensión). Este es el enfoque del sistema experto. Con la llegada del aprendizaje profundo, la capa de procesamiento maneja automáticamente el preprocesamiento.
Establezca los parámetros iniciales del modelo: los parámetros iniciales del modelo incluyen múltiples capas, funciones de activación, pesos iniciales, sesgos, tasas de aprendizaje, etc. Algunos parámetros se pueden ajustar mediante algoritmos de optimización durante el entrenamiento para mejorar la precisión del modelo.
Datos de entrenamiento:
Los datos de entrada se introducen en una red neuronal, generalmente comenzando con una o más capas de modelado de relaciones y extracción de características, como capas convolucionales (CNN), capas recurrentes (RNN) o capas de autoatención. Estas capas aprenden a extraer características relevantes de los datos de entrada y modelan las relaciones entre estas características.
Las salidas de estas capas luego se pasan a una o más capas adicionales, que realizan diferentes cálculos y transformaciones en los datos de entrada. Estas capas generalmente implican principalmente la multiplicación de matrices de peso que se pueden aprender y la aplicación de funciones de activación no lineales, pero también pueden incluir otras operaciones como convolución y agrupación en redes neuronales convolucionales o iteración en redes neuronales recurrentes. La salida de estas capas sirve como entrada para la siguiente capa del modelo o como salida final prevista.
Obtenga el resultado del modelo: el resultado calculado por una red neuronal suele ser un vector o matriz que representa la probabilidad de clasificación de imágenes, puntuación de análisis de sentimiento u otros resultados, según la aplicación de la red. Por lo general, también hay un módulo de evaluación de errores y actualización de parámetros que actualiza automáticamente los parámetros según el propósito del modelo.
El resultado del cálculo de una red neuronal suele ser un vector o una matriz que representa la probabilidad de clasificación de la imagen, una puntuación del análisis de sentimiento u otros resultados, según la aplicación de la red. Por lo general, también hay un módulo de evaluación de errores y actualización de parámetros que actualiza automáticamente los parámetros según el propósito del modelo. Si la explicación anterior parece demasiado oscura, aquí hay un ejemplo del uso de un modelo CNN para identificar imágenes de manzanas.
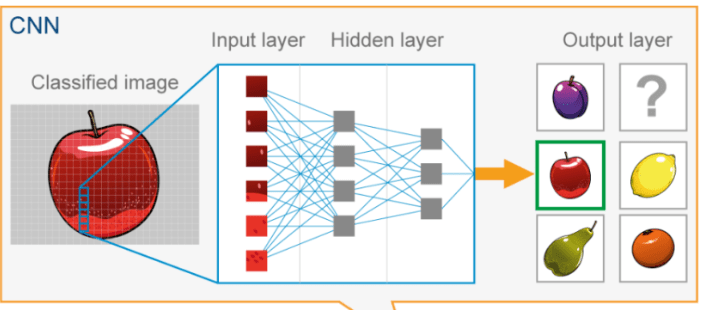
Cargue la imagen en el modelo como una matriz de valores de píxeles. Esta matriz se puede representar como un tensor 3D con dimensiones (alto, ancho, canales).
Establezca los parámetros iniciales del modelo CNN.
La imagen de entrada pasa a través de múltiples capas ocultas en una CNN, y cada capa aplica filtros convolucionales para extraer características cada vez más complejas de la imagen. La salida de cada capa pasa a través de una función de activación no lineal y luego se agrupa para reducir la dimensionalidad del mapa de características. La última capa suele ser una capa completamente conectada que genera predicciones de salida basadas en las características extraídas.
El resultado final de CNN es la categoría con mayor probabilidad. Esta es la etiqueta prevista de la imagen de entrada.
Un marco de confianza para el aprendizaje automático
Podemos resumir lo anterior en un marco de confianza del aprendizaje automático, que incluye cuatro capas básicas de aprendizaje automático. Todo el proceso de aprendizaje automático requiere que estas capas sean confiables para ser confiable:
Entrada: los datos sin procesar deben procesarse previamente y, en ocasiones, mantenerse en secreto.
Integridad: los datos de entrada no han sido manipulados, no han sido contaminados por entradas maliciosas y han sido preprocesados correctamente.
Privacidad: Los datos ingresados no se divulgarán si es necesario.
Resultado: Debe generarse y transmitirse con precisión
Integridad: el resultado se genera correctamente.
Privacidad: los resultados no se filtrarán si es necesario.
Tipo de modelo/algoritmo: el modelo debe calcularse correctamente
Integridad: El modelo funciona correctamente.
Privacidad: El modelo en sí o los cálculos no se filtrarán si es necesario.
Los diferentes modelos de redes neuronales tienen diferentes algoritmos y capas adecuados para diferentes casos de uso y entradas.
Las redes neuronales convolucionales (CNN) se usan comúnmente para tareas que involucran datos similares a cuadrículas, como imágenes, donde se pueden capturar patrones y características locales aplicando operaciones de convolución a pequeñas regiones de entrada.
Las redes neuronales recurrentes (RNN), por otro lado, son muy adecuadas para datos secuenciales como series temporales o lenguaje natural, donde los estados ocultos pueden capturar información de pasos temporales anteriores y modelar dependencias temporales.
Las capas de autoatención son útiles para capturar relaciones entre elementos en una secuencia de entrada, lo que las hace efectivas para tareas como la traducción automática o el resumen donde las dependencias de largo alcance son cruciales.
También existen otros tipos de modelos, incluidos los perceptrones multicapa (MLP) y otros.
Parámetros del modelo: en algunos casos, los parámetros deben ser transparentes o generados democráticamente, pero en todos los casos no deben ser susceptibles de manipulación. Integridad: Los parámetros se generan, mantienen y gestionan de forma correcta. Privacidad: los propietarios de modelos a menudo mantienen en secreto los parámetros del modelo de aprendizaje automático para proteger la propiedad intelectual y la ventaja competitiva de la organización que desarrolló el modelo. Este fenómeno sólo era común hasta que los modelos de transformadores se volvieron increíblemente costosos de entrenar, pero sigue siendo un problema importante para la industria.
El problema de la confianza en el aprendizaje automático
Con el crecimiento explosivo de las aplicaciones de aprendizaje automático (ML) (CAGR de más del 20%) y su creciente integración en la vida diaria, como la reciente popularidad de ChatGPT, la cuestión de la confianza en el ML se está volviendo cada vez más crítica y no se puede ignorar. Por lo tanto, es fundamental identificar y abordar estos problemas de confianza para garantizar el uso responsable de la IA y evitar su posible uso indebido. Sin embargo, ¿cuáles son los problemas? Echemos un vistazo más de cerca.
Transparencia o demostrabilidad insuficientes
Los problemas de confianza han afectado durante mucho tiempo al aprendizaje automático por dos razones principales:
Naturaleza de la privacidad: como se mencionó anteriormente, los parámetros del modelo suelen ser privados y, en algunos casos, las entradas del modelo también deben mantenerse privadas, lo que naturalmente crea algunos problemas de confianza entre los propietarios y usuarios del modelo.
Cajas negras algorítmicas: los modelos de aprendizaje automático a veces se denominan “cajas negras” porque implican muchos pasos automatizados en sus cálculos que son difíciles de entender o explicar. Estos pasos implican algoritmos complejos y grandes cantidades de datos, lo que da como resultado resultados inciertos y, a veces, aleatorios, lo que hace que los algoritmos sean vulnerables a acusaciones de sesgo o incluso discriminación.
Antes de continuar, una de las suposiciones más importantes de este artículo es que el modelo está "listo para usar", lo que significa que está bien entrenado y es apto para su propósito. Es posible que los modelos no funcionen en todas las situaciones y mejoran a un ritmo alarmante. La vida útil normal de un modelo de aprendizaje automático es de entre 2 y 18 meses, según el escenario de aplicación.
Un desglose detallado de los problemas de confianza en el aprendizaje automático
Existen algunos problemas de confianza en el proceso de capacitación del modelo y Gensyn está trabajando actualmente para generar pruebas válidas para facilitar este proceso. Sin embargo, este artículo se centra principalmente en el proceso de inferencia de modelos. Utilicemos ahora cuatro componentes básicos del aprendizaje automático para descubrir posibles problemas de confianza:
ingresar:
Las fuentes de datos son a prueba de manipulaciones
Los operadores de modelos no roban los datos de entrada privados (cuestión de privacidad)
Modelo:
El modelo en sí es tan preciso como se anuncia.
El proceso de cálculo se completa correctamente.
parámetro:
Los parámetros del modelo no han sido cambiados o son los anunciados.
Durante el proceso, los parámetros del modelo que tienen valor para el propietario del modelo no se filtran (problema de privacidad)
Salida: Los resultados de salida son demostrablemente correctos (pueden mejorar a medida que se mejoren todos los elementos anteriores)
Cómo aplicar ZK en un marco de confianza de aprendizaje automático
Algunos de los problemas de confianza anteriores se pueden resolver ingresando en la cadena; cargando entradas y parámetros de aprendizaje automático en la cadena, y calculando modelos en la cadena, se puede garantizar la exactitud de las entradas, los parámetros y los cálculos del modelo. Pero este enfoque puede sacrificar la escalabilidad y la privacidad. Giza está haciendo este trabajo en Starknet, pero debido a problemas de costos solo admite modelos simples de aprendizaje automático como la regresión, no redes neuronales. La tecnología ZK puede resolver los problemas de confianza anteriores de manera más efectiva. Actualmente, ZK de ZKML generalmente se refiere a zkSNARK. Primero, repasemos rápidamente algunos conceptos básicos de zkSNARK:
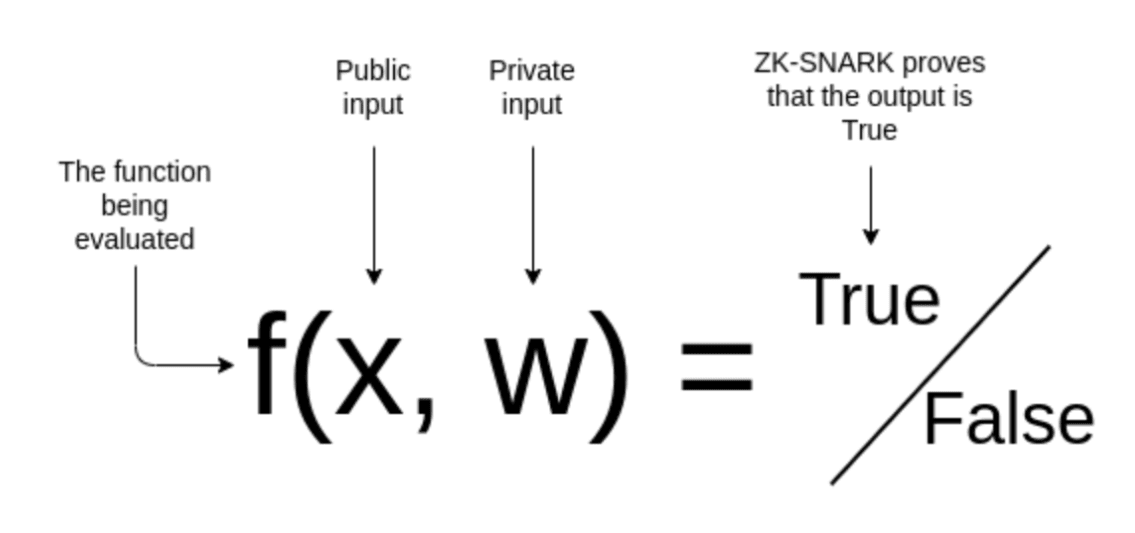
Una prueba de zkSNARK es una prueba de que conozco alguna entrada secreta w tal que es cierto que el resultado de este cálculo f está FUERA, sin decirle cuál es w. El proceso de generación de pruebas se puede resumir en los siguientes pasos:
Formule el enunciado a demostrar: f(x,w)=true
"Clasifiqué correctamente esta imagen x usando un modelo de aprendizaje automático f con parámetros privados w".
Convertir declaraciones en circuitos (aritmetización): los diferentes métodos de construcción de circuitos incluyen R1CS, QAP, Plonkish, etc.
En comparación con otros casos de uso, ZKML requiere un paso adicional llamado cuantificación. La inferencia de redes neuronales normalmente se realiza utilizando aritmética de punto flotante, que es muy costosa de emular en el dominio principal de los circuitos aritméticos. Los diferentes métodos de cuantificación ofrecen un equilibrio entre la precisión y los requisitos del equipo.
Algunos métodos de construcción de circuitos como R1CS no son eficientes para redes neuronales. Esta parte se puede ajustar para mejorar el rendimiento.
Generar una clave de prueba y una clave de verificación
Crear un testigo: cuando w=w*, f(x,w)=true
Cree un compromiso de hash: el testigo w* se compromete a generar un valor hash utilizando una función hash criptográfica. Este hash se puede hacer público.
Esto ayuda a garantizar que las entradas privadas o los parámetros del modelo no hayan sido alterados ni modificados durante los cálculos. Este paso es crucial porque incluso modificaciones menores pueden tener un impacto significativo en el comportamiento y el resultado del modelo.
Generación de pruebas: diferentes sistemas de pruebas utilizan diferentes algoritmos de generación de pruebas.
Es necesario diseñar reglas especiales de conocimiento cero para operaciones de aprendizaje automático, como la multiplicación de matrices y las capas convolucionales, a fin de implementar protocolos sublineales eficientes en el tiempo para estos cálculos.
✓ Es posible que los sistemas zkSNARK genéricos como groth16 no puedan manejar redes neuronales de manera eficiente debido a una carga computacional excesiva.
✓ Desde 2020, han surgido muchos nuevos sistemas de prueba ZK para optimizar la prueba ZK para el proceso de inferencia de modelos, incluidos vCNN, ZEN, ZKCNN y pvCNN. Sin embargo, la mayoría de ellos están optimizados para modelos CNN. Solo se pueden aplicar a algunos conjuntos de datos importantes, como MNIST o CIFAR-10.
✓ En 2022, Daniel Kang Tatsunori Hashimoto, Ion Stoica y Yi Sun (fundadores de Axiom) propusieron un nuevo esquema de prueba basado en Halo 2, logrando por primera vez la generación de pruebas ZK para el conjunto de datos ImageNet. Su optimización se centra en la parte aritmética, con nuevos parámetros de búsqueda de no linealidad y reutilización de subcircuitos entre capas.
✓Modulus Labs está comparando diferentes sistemas de prueba para el razonamiento en cadena y descubrió que, en términos de tiempo de prueba, ZKCNN y plonky2 funcionan mejor en términos de uso máximo de memoria del probador, ZKCNN y halo2 funcionan bien, mientras que plonky funciona bien, pero el consumo de memoria; Se sacrifica y ZKCNN solo funciona en modelos CNN. También está desarrollando un nuevo sistema zkSNARK diseñado específicamente para ZKML, así como una nueva máquina virtual.
Prueba de verificación: El verificador utiliza la clave de verificación para verificar sin el conocimiento del testigo.
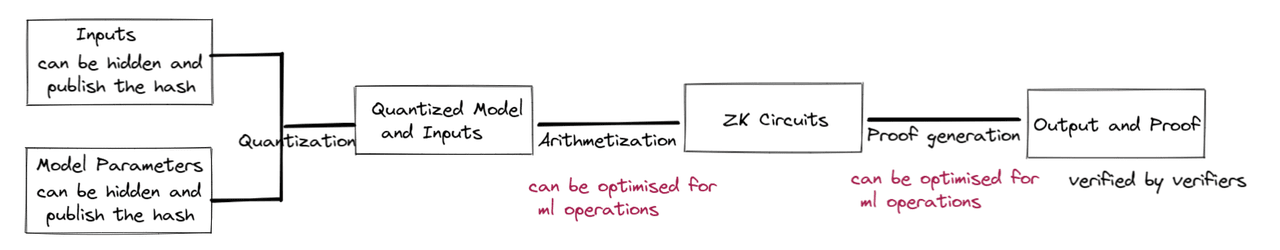
Por tanto, podemos demostrar que la aplicación de técnicas de conocimiento cero a modelos de aprendizaje automático puede resolver muchos problemas de confianza. Técnicas similares que utilizan la verificación interactiva pueden lograr resultados similares, pero requerirán más recursos por parte del verificador y pueden enfrentar más problemas de privacidad. Vale la pena señalar que, según el modelo específico, generar pruebas para ellos puede llevar tiempo y recursos, por lo que habrá compensaciones a la hora de aplicar esta tecnología a casos de uso del mundo real.
Estado actual de las soluciones actuales.
A continuación, ¿cuáles son las soluciones existentes? Tenga en cuenta que un proveedor de modelos puede tener muchas razones para no querer generar pruebas ZKML. Para aquellos lo suficientemente valientes como para probar ZKML y la solución tiene sentido, pueden elegir entre algunas soluciones diferentes según el modelo y dónde están las entradas:
Si los datos de entrada están en cadena, considere usar Axiom como solución:
Axiom está construyendo un coprocesador de conocimiento cero para Ethereum para mejorar el acceso de los usuarios a los datos de blockchain y proporcionar una visión digital más compleja de los datos en cadena. Es posible realizar cálculos confiables de aprendizaje automático sobre datos en cadena:
Primero, Axiom importa datos en cadena almacenando la raíz Merkle del hash del bloque Ethereum en su contrato inteligente AxiomV0, que se verifica sin confianza a través del proceso de verificación ZK-SNARK. El contrato AxiomV0StoragePf permite la verificación por lotes de pruebas de almacenamiento históricas arbitrarias de Ethereum frente a una raíz de confianza proporcionada por hashes de bloques almacenados en caché en AxiomV0.
A continuación, los datos de entrada del aprendizaje automático se pueden extraer de los datos históricos importados.
Luego, Axiom puede aplicar operaciones probadas de aprendizaje automático además de usar halo2 optimizado como backend para validar la efectividad de cada parte computacional.
Finalmente, Axiom adjuntará la prueba zk para cada resultado de la consulta y el contrato inteligente de Axiom verificará la prueba zk. Cualquier interesado que quiera acreditarlo podrá acceder a él desde el contrato inteligente.
Si pone su modelo en cadena, considere usar RISCZero como solución:
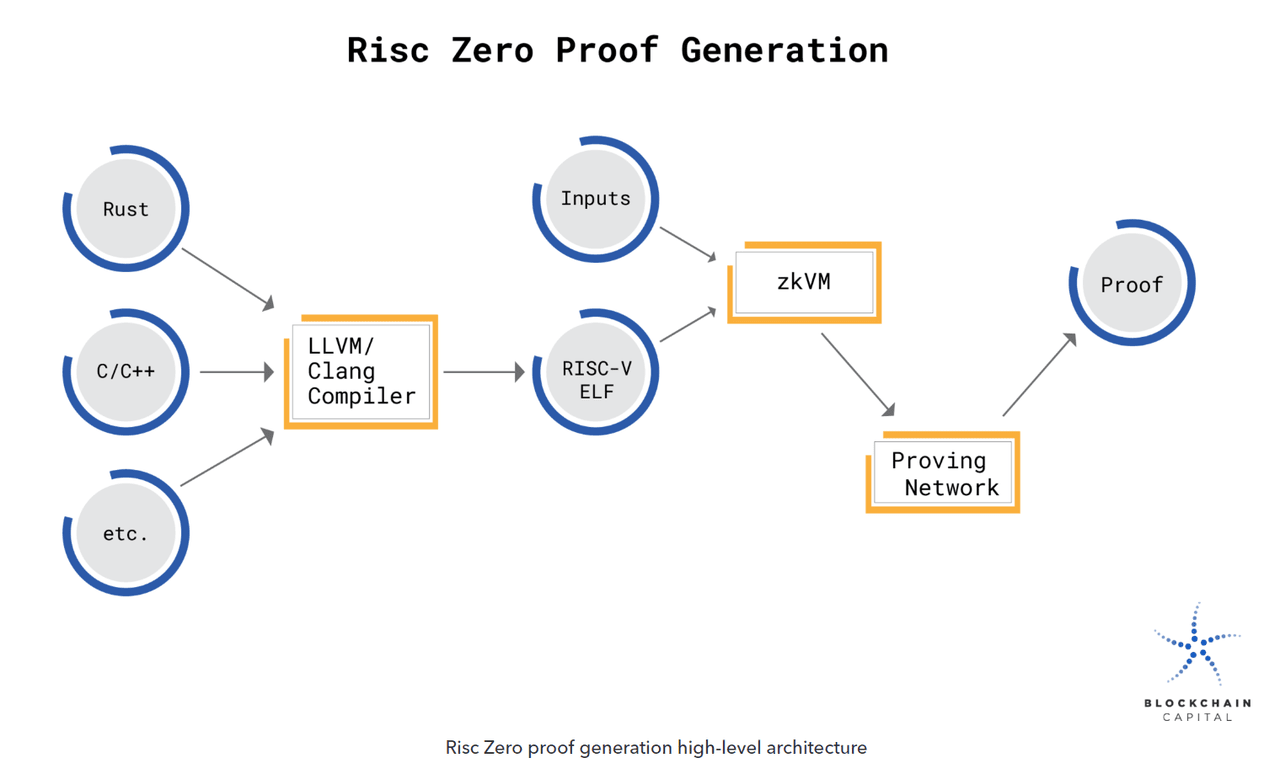
Primero, el código fuente del modelo debe compilarse en un binario RISC-V. Cuando este binario se ejecuta en ZKVM, la salida se empareja con un recibo calculado que contiene un sello criptográfico. Este sello sirve como argumento de conocimiento cero para la integridad computacional, asociando una ID de imagen cifrada (que identifica el binario RISC-V en ejecución) con la salida del código declarado para una verificación rápida por parte de terceros.
Cuando se ejecuta un modelo en ZKVM, los cálculos sobre los cambios de estado se realizan completamente dentro de la VM. No filtra ninguna información sobre el estado interno del modelo al mundo exterior.
Una vez que se ejecuta el modelo, el sello resultante se convierte en una prueba de integridad computacional sin conocimiento cero. RISC ZeroZKVM es una máquina virtual RISC-V que puede generar pruebas de conocimiento cero del código que ejecuta. Usando ZKVM, es posible generar un recibo criptográfico que cualquiera puede verificar que fue generado por el código de cliente de ZKVM. Cuando se emite un recibo, no se revela ninguna otra información sobre la ejecución del código (como la entrada proporcionada).
Al ejecutar un modelo de aprendizaje automático en ZKVM de RISC Zero, puede demostrar que los cálculos exactos involucrados en el modelo se realizaron correctamente. El proceso de cálculo y verificación se puede realizar fuera de línea en el entorno preferido del usuario o en Bonsai Network, un roll-up de uso general.
El proceso específico de generación de pruebas ZK implica un protocolo interactivo con un oráculo aleatorio como verificador. El sello del recibo RISC Zero es esencialmente un registro de este acuerdo de interacción.
Si desea importar modelos directamente desde software popular de aprendizaje automático como Tensorflow o Pytorch, considere usar ezkl como solución:
Primero, exporte el modelo final como un archivo .onnx y algunas entradas de muestra como un archivo .json.
Luego, apunte ezkl a los archivos .onnx y .json para generar circuitos ZK-SNARK que puedan probar declaraciones ZKML.
Ezkl es una biblioteca y una herramienta de línea de comandos para la inferencia de modelos de aprendizaje profundo y otros gráficos computacionales en zkSNARK.
Parece simple, ¿verdad? El objetivo de Ezkl es proporcionar una capa de abstracción que permita llamar y diseñar operaciones de alto nivel en los circuitos de Halo 2. Ezkl abstrae mucha complejidad manteniendo una flexibilidad increíble. Su modelo cuantificado tiene un factor de escala cuantificado automáticamente. Apoyan la flexibilidad para cambiar a otros sistemas de prueba involucrados en nuevas soluciones. También admiten varios tipos de máquinas virtuales, incluidas EVM y WASM.
Con respecto al sistema de prueba, ezkl adapta el circuito halo2 agregando pruebas (convirtiendo pruebas difíciles de verificar en pruebas fáciles de verificar a través de intermediarios) y recursividad (puede resolver problemas de memoria, pero es difícil de adaptar a halo2). Ezkl también optimiza todo el proceso mediante fusión y abstracción que puede reducir los gastos generales mediante pruebas avanzadas.
Vale la pena señalar que, en comparación con otros proyectos zkml generales, Accessor Labs se enfoca en proporcionar herramientas zkml especialmente diseñadas para juegos completamente en cadena, que pueden involucrar NPC de IA, actualizaciones automáticas del juego, interfaces de juego que involucran lenguaje natural, etc.
¿Dónde están los casos de uso?
Resolver el problema de la confianza con el aprendizaje automático a través de la tecnología ZK significa que ahora se puede aplicar a más casos de uso de "alto riesgo" y "alta certeza" que simplemente mantenerse al día con las conversaciones de las personas o hacer coincidir imágenes de gatos con imágenes de perros para diferenciar. Web3 ya está explorando muchos de estos casos de uso. Esto no es una coincidencia, ya que la mayoría de las aplicaciones Web3 se ejecutan o están destinadas a ejecutarse en cadenas de bloques, ya que las cadenas de bloques tienen propiedades específicas para operar de forma segura, son difíciles de manipular y tienen cálculos deterministas. Una IA de buen comportamiento verificable debería ser aquella que pueda operar en un entorno descentralizado y sin confianza, ¿verdad?
Casos de uso donde ZK+ML se puede aplicar en Web3
Muchas aplicaciones Web3 sacrifican la experiencia del usuario por la seguridad y la descentralización porque esa es claramente su prioridad y existen limitaciones de infraestructura. La IA/ML tiene el potencial de enriquecer las experiencias de los usuarios, lo que sin duda es útil, pero que antes parecía imposible sin hacer concesiones. Ahora, gracias a ZK, podemos ver cómodamente AI/ML combinado con aplicaciones Web3 sin sacrificar demasiado en términos de seguridad y descentralización.
Esencialmente, será una aplicación Web3 (que puede existir o no en el momento de escribir este artículo) que implementa ML/AI de manera no confiable. Por sin confianza nos referimos a si se ejecuta en un entorno/plataforma sin confianza o si se puede demostrar que su funcionamiento es verificable. Tenga en cuenta que no todos los casos de uso de ML/AI (incluso en Web3) requieren o prefieren ejecutarse sin confianza. Analizaremos cada parte de las capacidades de ML utilizadas en varios dominios Web3. Luego identificaremos las piezas que requieren ZKML, normalmente piezas de alto valor donde la gente está dispuesta a pagar más por las pruebas. La mayoría de los casos de uso/aplicaciones que se mencionan a continuación aún se encuentran en la etapa de investigación experimental. Por lo tanto, todavía están lejos de ser adoptados en la práctica. Discutiremos por qué más tarde.
Desactivar
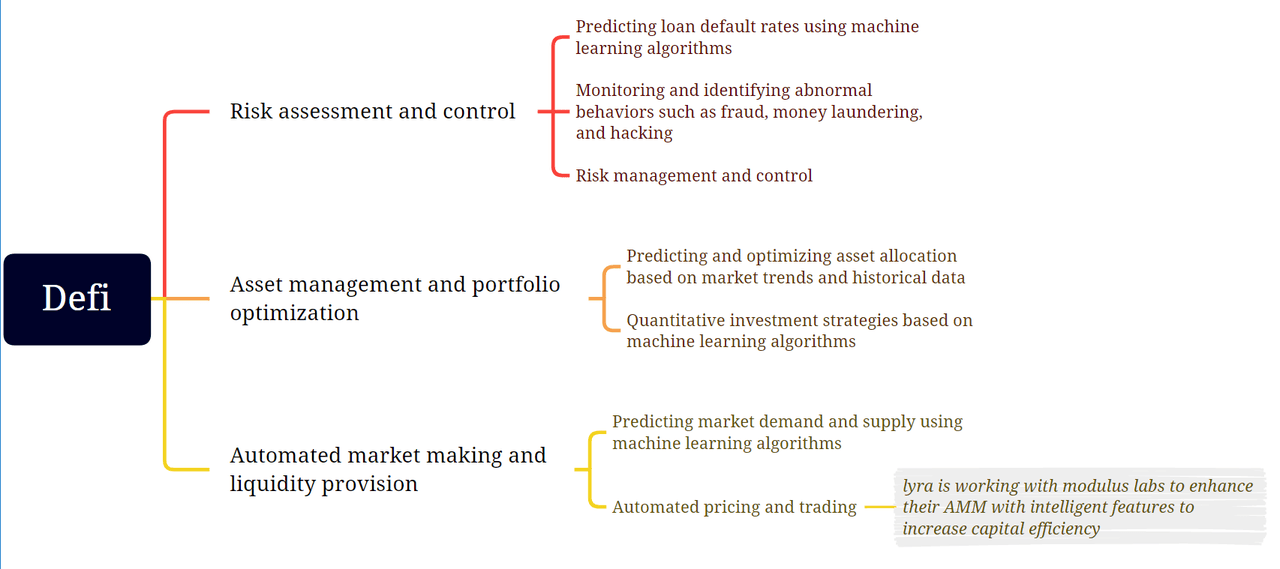
Defi es una de las pocas pruebas de que el producto y el mercado encajan entre los protocolos blockchain y las aplicaciones Web3. La capacidad de crear, almacenar y gestionar riqueza y capital sin permiso no tiene precedentes en la historia de la humanidad. Hemos identificado una serie de casos de uso que requieren que los modelos de IA/ML se ejecuten sin permiso para garantizar la seguridad y la descentralización.
Evaluación de riesgos: las finanzas modernas requieren modelos de IA/ML para una variedad de evaluaciones de riesgos, desde la prevención del fraude y el lavado de dinero hasta la emisión de préstamos sin garantía. Garantizar que dichos modelos de IA/ML funcionen de manera verificable significa que podemos evitar que sean manipulados para permitir una censura que obstaculizaría el uso de la naturaleza sin permiso de los productos Defi.
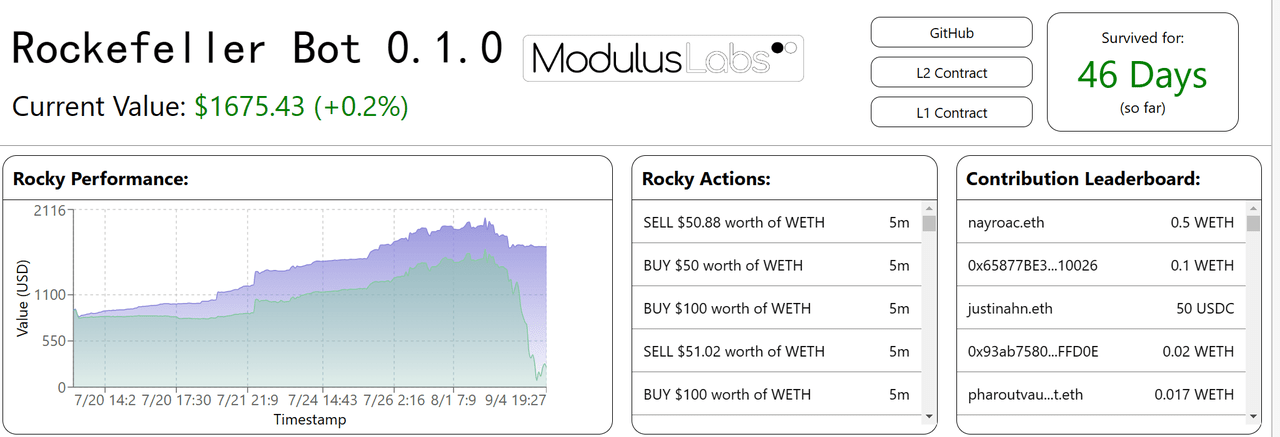
Gestión de activos: las estrategias comerciales automatizadas no son nuevas para las finanzas tradicionales y Defi. Ha habido intentos de aplicar estrategias comerciales generadas por IA/ML, pero solo unas pocas estrategias descentralizadas han tenido éxito. Las aplicaciones típicas en el campo Defi incluyen actualmente el Rocky Bot experimentado por Modulus Labs.
Un contrato que mantiene fondos en L1 e intercambia WEth/USDC en Uniswap.
Un contrato L2 implementa una red neuronal de tres capas simple (pero flexible) para predecir precios futuros de WEth. El contrato utiliza información histórica de precios WETH como entrada.
Una interfaz simple para visualización y código PyTorch para entrenar regresores y clasificadores.
Esto se aplica a la parte de "salida" del marco de confianza de ML. La salida se genera en L2, se transfiere a L1 y se utiliza para la ejecución. No se puede alterar durante este proceso.
Esto se aplica tanto a las secciones "Entrada" como a "Modelo". La información histórica de precios proviene de blockchain. La ejecución del modelo se calcula en CairoVM (un tipo de ZKVM) y su seguimiento de ejecución genera una prueba ZK para su verificación.
Rocky Bot: Modulus Labs creó un robot comercial que utiliza inteligencia artificial para la toma de decisiones en StarkNet.
MM automatizado y provisión de liquidez:
Esencialmente, es una combinación de esfuerzos similares que se llevan a cabo en la evaluación de riesgos y la gestión de activos, solo que con un enfoque diferente en términos de volumen, cronogramas y tipos de activos. Existen muchos artículos de investigación sobre cómo utilizar el aprendizaje automático para la creación de mercado en el mercado de valores. Puede que solo sea cuestión de tiempo antes de que algunos de los resultados de la investigación se adapten a los productos Defi.
LyraFinance, por ejemplo, está trabajando con Modulus Labs para mejorar su AMM con funciones inteligentes que harán que su utilización de capital sea más eficiente.
Menciones honoríficas:
El equipo de Warp.cc ha desarrollado un proyecto tutorial sobre cómo implementar un contrato inteligente que ejecuta una red neuronal entrenada para predecir el precio de Bitcoin. Esto se alinea con las partes de "entrada" y "modelo" de nuestro marco, ya que la entrada utiliza datos proporcionados por RedStoneOracles y el modelo se ejecuta en Arweave como un contrato inteligente Warp.
Esta es la primera iteración e involucra a ZK, por lo que es una mención de honor de nuestra parte, pero en el futuro, el equipo de Warp está considerando implementar una pieza ZK.
juego
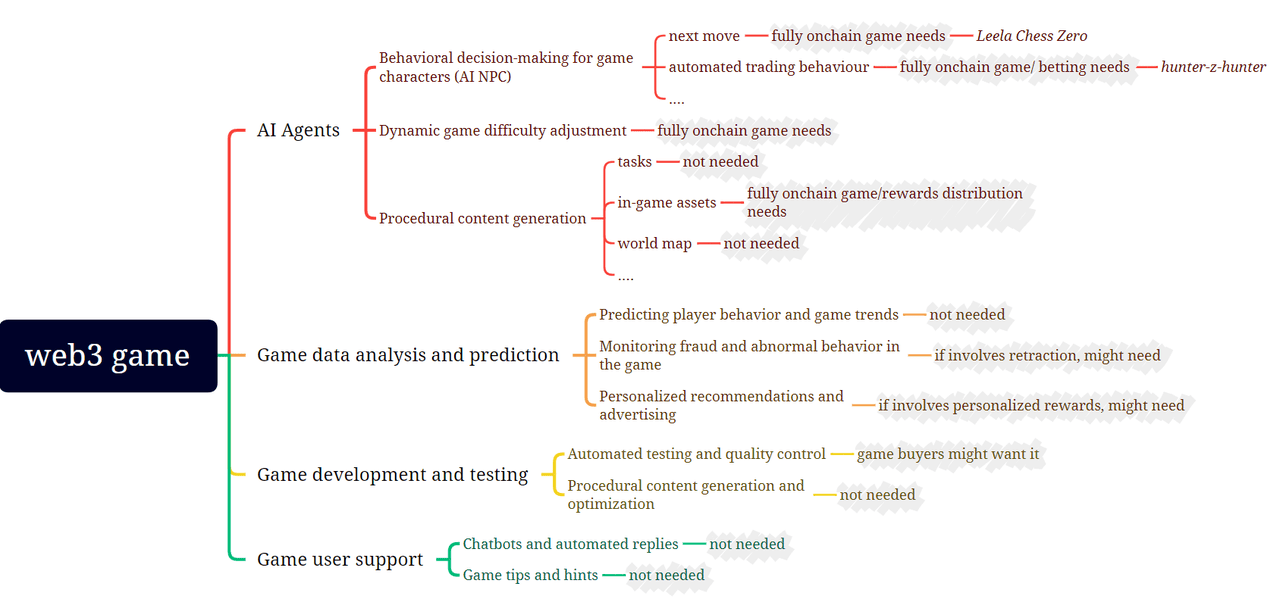
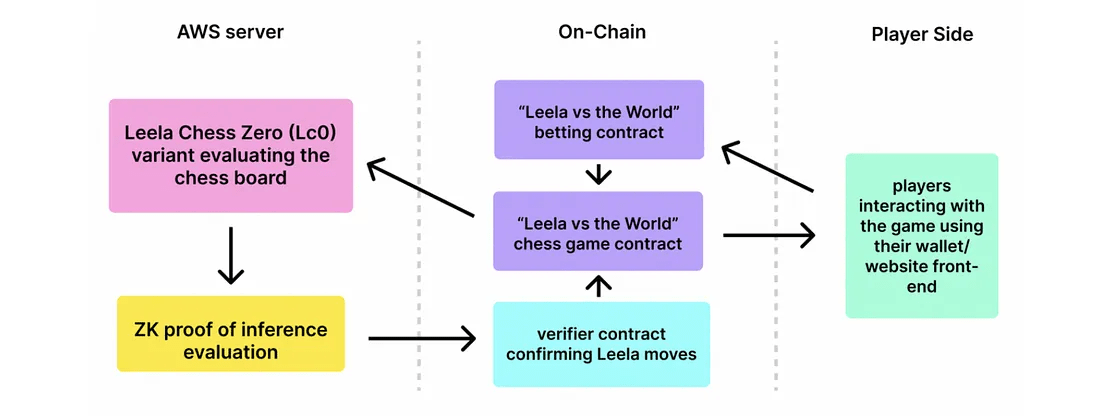
Los juegos tienen muchas intersecciones con el aprendizaje automático: el área gris en el diagrama representa nuestra evaluación inicial de si las capacidades de aprendizaje automático en la parte del juego deben combinarse con las pruebas ZKML correspondientes. Leela Chess Zero es un ejemplo muy interesante de cómo aplicar ZKML a un juego:
agente de IA
LC0 y el colectivo humano se turnan para jugar (como debería ser el caso en el ajedrez).
El movimiento de LC0 se calcula a partir de un modelo de LC0 simplificado y equipado con un circuito.
Leela Chess Zero (LC0): un jugador de ajedrez con IA completamente en cadena creado por Modulus Labs que juega contra un grupo de jugadores humanos de la comunidad.
El movimiento de LC0 tiene una prueba de sarcasmo Halo2 para garantizar que no haya interferencias por parte del cerebro humano. Sólo el modelo LC0 simplificado está ahí para tomar decisiones.
Esto encaja con la sección "Modelo". La ejecución del modelo cuenta con una prueba ZK para verificar que los cálculos no han sido alterados.
Análisis y predicción de datos: este ha sido un uso común de AI/ML en el mundo de los juegos Web2. Sin embargo, encontramos muy pocas razones para implementar ZK en este proceso de ML. Probablemente no valga la pena el esfuerzo por no involucrar demasiado valor directamente en el proceso. Sin embargo, si se utilizan ciertos análisis y predicciones para determinar las recompensas para los usuarios, entonces se puede implementar ZK para garantizar que los resultados sean correctos.
Menciones honoríficas:
AI Arena es un juego nativo de Ethereum donde jugadores de todo el mundo pueden diseñar, entrenar y luchar contra personajes NFT impulsados por redes neuronales artificiales. Investigadores talentosos de todo el mundo compiten para crear los mejores modelos de aprendizaje automático (ML) para participar en batallas de juegos. AI Arena se centra en redes neuronales de avance. En general, tienen una sobrecarga computacional más baja que las redes neuronales convolucionales (CNN) o las redes neuronales recurrentes (RNN). Aún así, actualmente los modelos solo se cargan en la plataforma una vez completada la capacitación, por lo que vale la pena mencionarlo.
GiroGiro.AI está creando un conjunto de herramientas de inteligencia artificial que permite a las masas crear inteligencia artificial para uso personal o comercial. Los usuarios pueden crear varios tipos de sistemas de IA basados en la plataforma de flujo de trabajo de IA intuitiva y automatizada. Al ingresar solo una pequeña cantidad de datos y seleccionar un algoritmo (o modelo para mejorar), los usuarios pueden generar y aprovechar el modelo de IA que tienen en mente. Aunque el proyecto se encuentra en sus primeras etapas, estamos muy emocionados de ver lo que GiroGiro puede aportar a las finanzas de juegos y a los productos centrados en el metaverso, por lo que lo incluimos como una mención de honor.
TID y social
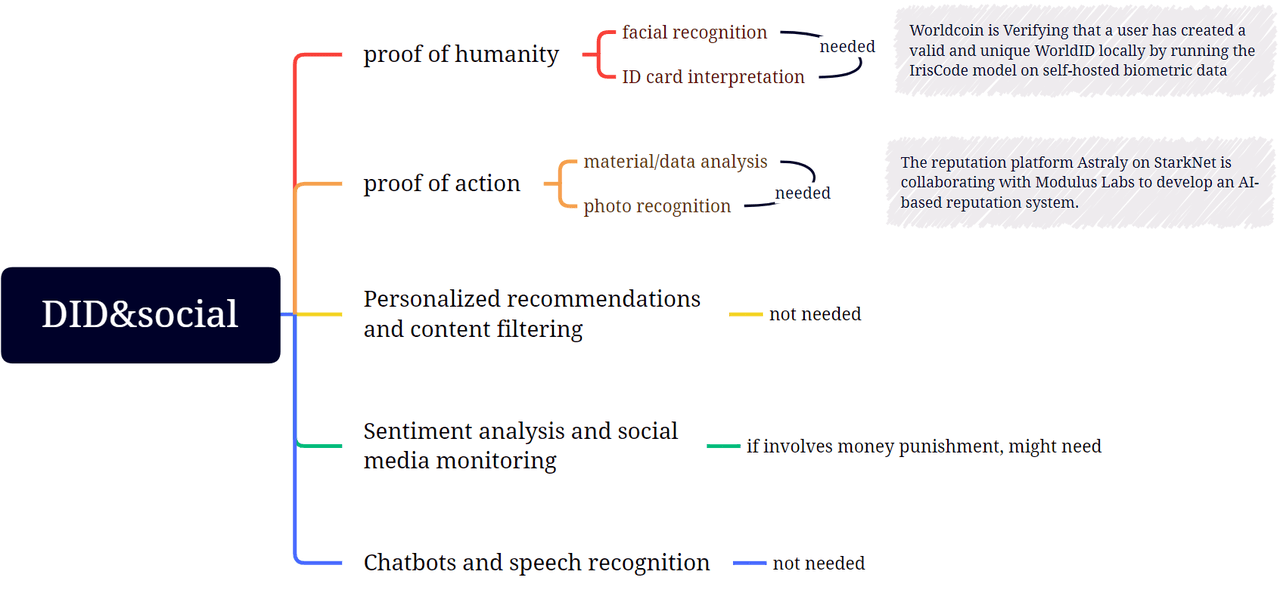
En el espacio social y DID, la intersección de Web3 y ML se encuentra actualmente principalmente en las áreas de prueba humana y prueba de credenciales, es posible que se desarrollen otras partes, pero llevará más tiempo;
prueba humana
La aplicación del usuario genera una dirección de billetera localmente.
La aplicación utiliza un Semáforo para demostrar que posee la clave privada de una clave pública previamente registrada. Como se trata de una prueba de conocimiento cero, no revela qué clave pública es.
La prueba se envía nuevamente al secuenciador, que la verifica e inicia el proceso de depósito de los tokens en la dirección de billetera proporcionada. Las llamadas partes se envían con comprobante, lo que garantiza que los usuarios no puedan reclamar sus recompensas dos veces.
El usuario genera un par de claves de Semaphore en el teléfono móvil y proporciona la clave pública hash a Orb a través del código QR.
Orb escanea el iris del usuario y calcula el IrisHash del usuario localmente. Luego envía un mensaje firmado que contiene la clave pública hash e IrisHash al nodo de orden de registro.
El nodo secuencial verifica la firma del Orb y luego verifica el IrisHash para ver si coincide con uno que ya está en la base de datos. Si se supera la verificación de unicidad, se guardarán IrisHash y la clave pública.
Worldcoin utiliza un dispositivo llamado Orb para determinar si alguien es una persona real, en lugar de intentar verificarlo de manera fraudulenta. Para ello, analiza las características faciales y del iris a través de varios sensores de cámara y modelos de aprendizaje automático. Una vez que se toma esta determinación, Orb toma fotografías de los iris de un grupo de personas y utiliza múltiples modelos de aprendizaje automático y otras técnicas de visión por computadora para crear un código de iris, una representación digital de las características más importantes del patrón del iris de un individuo. Los pasos de registro específicos son los siguientes:
Worldcoin utiliza el sistema de prueba de conocimiento cero Semaphore de código abierto para convertir la singularidad de IrisHash en la singularidad de una cuenta de usuario sin vincularlas. Esto garantiza que un usuario recién registrado pueda reclamar sus WorldCoins con éxito. Los pasos son los siguientes:
WorldCoin utiliza la tecnología ZK para garantizar que el resultado de sus modelos ML no revele los datos personales de los usuarios porque no existe correlación entre ellos. En este caso, se incluye en la parte de "salida" de nuestro marco de confianza, ya que garantiza que la salida se transmita y utilice de la manera deseada, en este caso de forma privada.
Revisando el marco de confianza de ML desde una perspectiva de casos de uso
Se puede ver que los casos de uso potenciales de ZKML en Web3 aún están en su infancia, pero no se pueden ignorar en el futuro. A medida que el uso de ZKML continúa expandiéndose, puede haber una necesidad de proveedores de ZKML para formar un grupo cerrado; bucle en la siguiente figura:
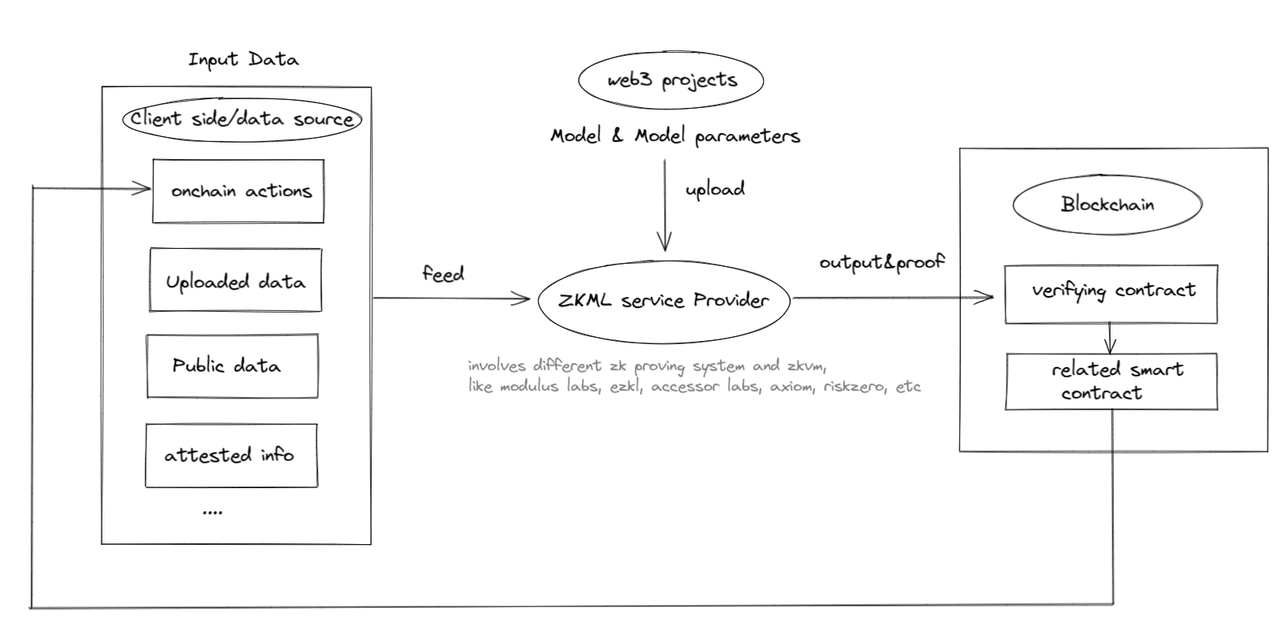
Los proveedores de servicios ZKML se centran principalmente en las partes de "modelo" y "parámetros" del marco de confianza de ML. Aunque la mayor parte de lo que vemos ahora que está relacionado con "parámetros" está más relacionado con el "modelo". Es importante señalar que las partes de “entrada” y “salida” son más abordadas por soluciones basadas en blockchain, ya sea como fuente de datos o como destino de datos. Es posible que ZK o blockchain por sí solos no logren una confiabilidad total, pero combinados sí podrían hacerlo.
¿Qué tan lejos está de una aplicación a gran escala?
Finalmente, podemos observar el estado actual de viabilidad de ZKML y qué tan cerca estamos de una adopción a gran escala de ZKML.
El artículo de Modulus Labs nos brinda algunos datos e ideas sobre la viabilidad de las aplicaciones ZKML al probar Worldcoin (con requisitos estrictos de precisión y memoria) y AI Arena (con requisitos de rentabilidad y tiempo):
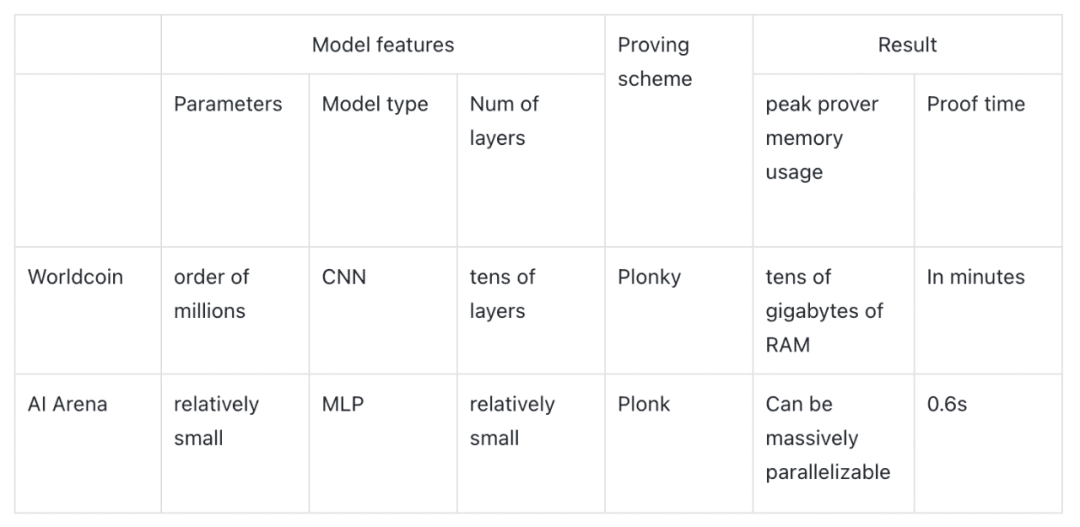
Si Worldcon usara ZKML, el consumo de memoria del probador excedería las capacidades de cualquier hardware móvil básico. Si la competencia AI Arena usa ZKML, el uso de ZKCNN aumentará el tiempo y el costo en un factor de 100 (0,6 s frente a 0,008 s). Desafortunadamente, ambos no son adecuados para aplicar directamente técnicas ZKML para el tiempo de prueba y el uso de la memoria del probador.
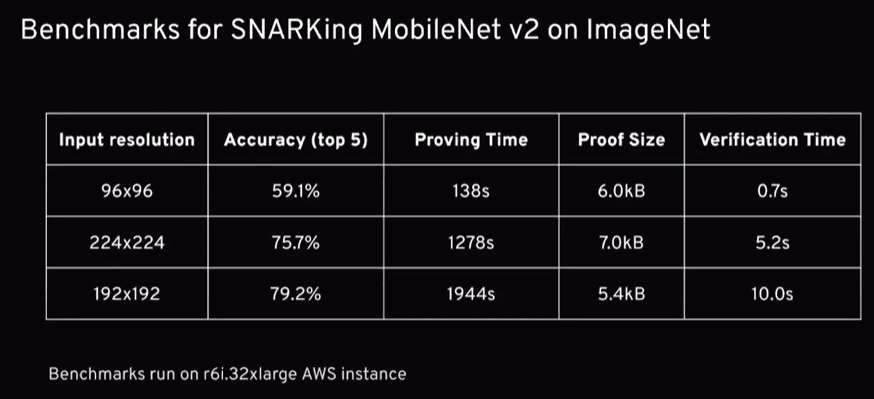
¿Qué pasa con el tamaño de la prueba y el tiempo de verificación? Podemos referirnos a los artículos de Daniel Kang, Tatsunori Hashimoto, Ion Stoica y Yi Sun. Como se muestra a continuación, su solución de inferencia DNN logra una precisión del 79 % en ImageNet (tipo de modelo: DCNN, 16 capas, 3,4 millones de parámetros) y tarda solo 10 segundos en verificar y un tamaño de prueba de 5952 bytes. Además, los zkSNARK se pueden reducir hasta un 59 % de precisión con un tiempo de verificación de solo 0,7 segundos. Estos resultados muestran que zkSNARKing en modelos a escala ImageNet es factible en términos de tamaño de prueba y tiempo de verificación. Los principales obstáculos técnicos en la actualidad son el tiempo de prueba y el consumo de memoria. La aplicación de ZKML en el caso web3 aún no es técnicamente viable. ¿Tiene ZKML potencial para ponerse al día con el desarrollo de la IA? Podemos comparar varios datos empíricos:
Qué tan rápido están evolucionando los modelos de aprendizaje automático: el modelo GPT-1 lanzado en 2019 tenía 150 millones de parámetros, mientras que el último modelo GPT-3 lanzado en 2020 tenía 175 mil millones de parámetros, un aumento de 1166 veces en la cantidad de parámetros en solo dos años. .
Velocidad de optimización de los sistemas de conocimiento cero: el crecimiento del rendimiento de los sistemas de conocimiento cero sigue básicamente un ritmo de "Ley de Moore". Casi todos los años surgen nuevos sistemas de conocimiento cero y esperamos que el rápido crecimiento en el rendimiento de los probadores continúe durante algún tiempo.
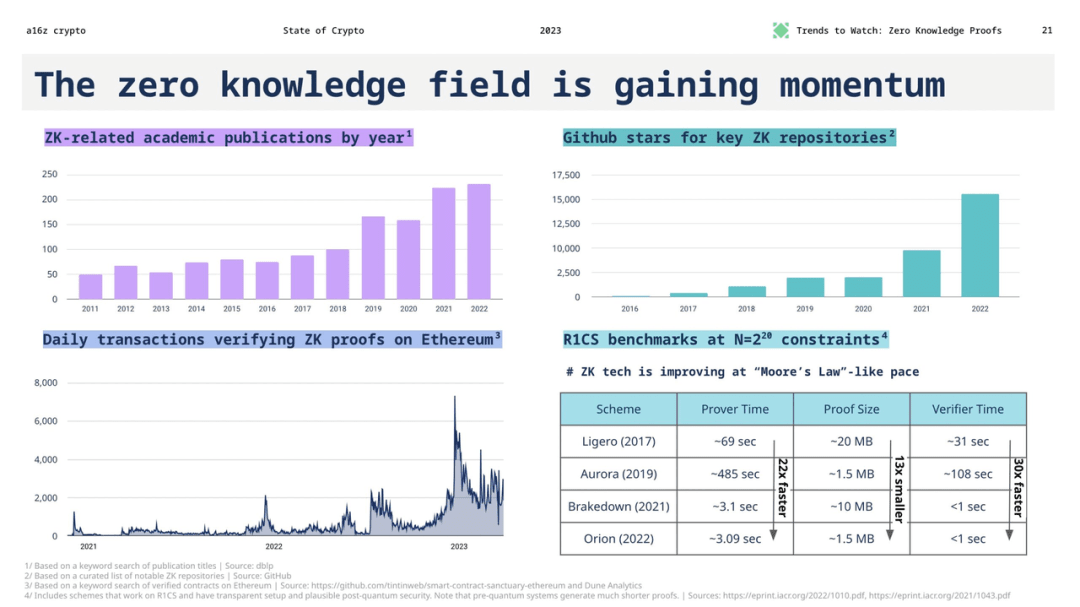
A juzgar por estos datos, aunque los modelos de aprendizaje automático se están desarrollando muy rápidamente, la velocidad de optimización de los sistemas de prueba de conocimiento cero también está aumentando constantemente. En el futuro, es posible que ZKML todavía tenga la oportunidad de ponerse al día gradualmente con el desarrollo de la IA, pero necesita innovación tecnológica y optimización continuas para reducir la brecha. Esto significa que, aunque ZKML actualmente tiene cuellos de botella técnicos en las aplicaciones web3, con el desarrollo continuo de tecnología a prueba de conocimiento cero, todavía tenemos motivos para esperar que ZKML desempeñe un papel más importante en los escenarios web3 en el futuro. Comparando las tasas de mejora de ML y ZK de vanguardia, las perspectivas no son muy optimistas. Sin embargo, con la mejora continua del rendimiento de convolución, el hardware ZK y el sistema de prueba ZK personalizado en base a operaciones de redes neuronales altamente estructuradas, se espera que el desarrollo de ZKML pueda satisfacer las necesidades de web3, comenzando por proporcionar algunas máquinas antiguas. Se inicia la función de aprendizaje. Si bien puede resultarnos difícil usar blockchain + ZK para verificar que la información que ChatGPT me envía es confiable, es posible que podamos incluir algunos modelos ML más pequeños y antiguos en el circuito ZK.
en conclusión
"El poder tiende a corromper y el poder absoluto corrompe absolutamente". Con el increíble poder de la IA y el ML, actualmente no existe una manera infalible de controlarlos. Los hechos han demostrado una y otra vez que los gobiernos intervienen tardíamente o promueven prohibiciones absolutas. Blockchain + ZK ofrece una de las pocas soluciones que pueden domar a la bestia de forma demostrable y verificable.
Esperamos ver más innovación de productos en el campo de ZKML. ZK y blockchain proporcionan un entorno seguro y confiable para el funcionamiento de AI/ML. También esperamos que estas innovaciones de productos generen modelos de negocio completamente nuevos, porque en el mundo de las criptomonedas sin permiso, no estamos limitados por el modelo de comercialización de SaaS. Esperamos apoyar a más constructores a medida que desarrollan sus interesantes ideas en esta fascinante superposición de Wild West Anarchy y Ivory Tower Elite. Todavía estamos en las primeras etapas, pero es posible que ya estemos en camino de salvar el mundo.