
加入 OpenSea 旗舰系列……
Elman Mansimov 开发的 alignDRAW 是首个文本生成图像的 AI 模型(诞生于 2015 年),它生成的 32 x 32 像素模糊图像,是有史以来第一批由文本语句生成的图像。
详情如下👇
Elman Mansimov 于 1996 年出生于阿塞拜疆,15 岁时便在多伦多大学攻读计算机科学学位,师从 Ruslan Salakhutdinov,到 2015 年初,神经网络已经能够识别照片并为其撰写说明文字。
19 岁那年,Elman 提出了一个显而易见却反向的问题:神经网络能否读取一个句子并将其画出来?由此诞生了 alignDRAW 模型,描述该模型的论文《Generating Images from Captions with Attention》(基于注意力机制从说明文字生成图像)于 2015 年 11 月提交,合著者包括 Emilio Parisotto、Jimmy Lei Ba 和 Ruslan Salakhutdinov,该论文随后被 ICLR 2016 会议接收为口头报告。
该模型根据 36 条文本提示生成了 2,709 张图像,每张图像的分辨率为 32 x 32 像素,且难以辨认,其中 21 条提示出现在了已发表的论文中,其余的提示(即“过程提示”)被发布在多伦多大学的一个网页上,至今仍可通过 http://archive.org 查看(存档日期为 2015 年 11 月)。
本文展示的作品便是其中之一:“一架巨大的商用飞机停在水面的冲浪板上” - 这是模型针对该句子生成的 121 张图像中的第 92 张,提示词即作品标题,而那模糊的影像便是艺术本身。
此后近六年间,相关领域几乎沉寂无声,Elman 在纽约大学(NYU)师从 Kyunghyun Cho 获得了博士学位,目前在亚马逊纽约分部担任高级应用科学家。
alignDRAW 仅存在于学术引用之中,直到 DALL-E、Midjourney 和 Stable Diffusion 让“文本提示生成图像”变得家喻户晓,人们才开始追溯这一创意的源头。
2023 年 4 月,艺术家 Alejandro Cartagena 联系了 Elman,探讨将原始图像上链的事宜,Fellowship(@fellowshiptrust)将这些图像发布为 NFT,每枚 NFT 都以原始字节格式(native byte format)保存了 2015 年生成的原始图像,并于 2024 年 5 月实现了完全链上存储。
此后,艺术界迅速跟进,alignDRAW 先后亮相于 2023 年 11 月的巴黎摄影博览会(Paris Photo fair)、伦敦 Cork Street 9 号的 HERE 空间,以及同年 12 月佳士得(Christie's)举办的在线拍卖会。
2024年,伍斯特艺术博物馆(Worcester Art Museum)购藏了三件基于文本提示生成的 “alignDRAW” 系列版画,并将其纳入名为《新领域:21 世纪风景摄影》(New Terrain: 21st-Century Landscape Photography)的展览中。
同年 6 月,该作品在巴塞尔艺术展(Art Basel)期间亮相于“与人工自我协作”(Collaborations with the Artificial Self)展览,悬挂在哈罗德·科恩(Harold Cohen)的 “AARON” 系统与霍莉·赫恩登(Holly Herndon)及马特·德赖赫斯特(Mat Dryhurst)的 “Infinite Images” 作品之间。
佳士得(Christie's)摄影部国际主管达里乌斯·海姆斯(Darius Himes)评价道:“这就是人工智能领域的尼塞福尔·涅普斯(Nicéphore Niépce)。”
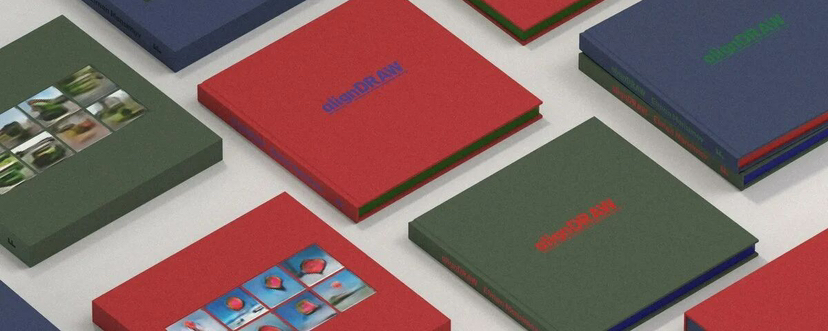
列夫·马诺维奇(Lev Manovich)也持相同观点:“alignDRAW 生成的图像,堪比涅普斯在 1826 至 1827 年间拍摄的首批永久影像。”为纪念该项目问世十周年,埃尔曼(Elman)于 2025 年利用现代硬件重建了原始模型,同时,Fellowship 机构出版了一部专著,收录了 2709 幅图像以及探讨该实验起源的文章。
将 alignDRAW 2438 纳入我们的旗舰收藏系列,旨在致敬这一将书面语句转化为图像的开创性尝试:这是一幅由一位 19 岁年轻人在 2015 年创作的作品 - 一个由 32 x 32 像素构成的“冲浪板上的飞机”的图像 - 即便在十年后的今天,它依然被不断重印、重新运行并引发热议。
欢迎回家,2438 🌊