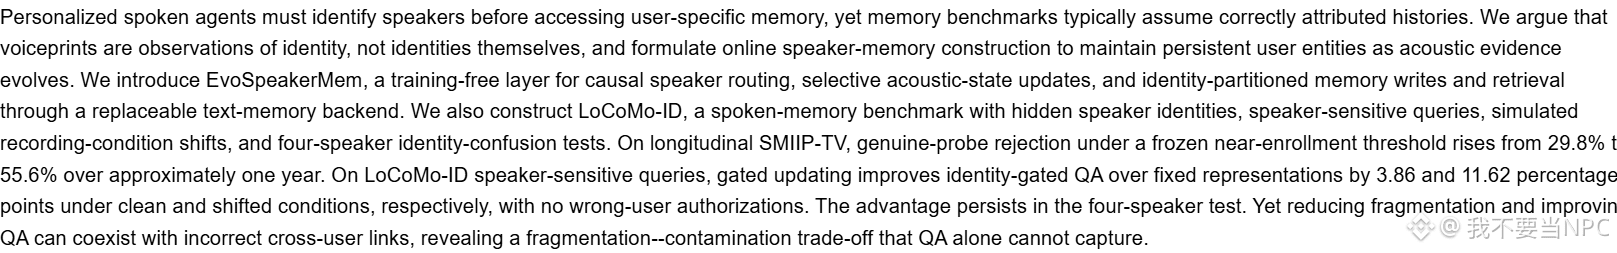
arXiv上出了一篇预印本,作者提出叫EvoSpeakerMem的方案:声纹只当作身份观察,不是身份本身。它做三件事——按因果把说话人路由到对应用户实体、挑选性更新声学状态、把记忆按身份分开读写,后面记忆存储可以换。配套还做了LoCoMo-ID基准,带隐藏说话人身份、跨录音条件偏移和四人混淆测试。
结果是:在纵向SMIIP-TV上,冻结近注册阈值下真声拒绝率从29.8%升到55.6%,跨约一年;LoCoMo-ID的说话人敏感问答上,门控更新比固定表示分别高3.86和11.62个百分点,且没有错误用户授权。但作者也点明:减少碎片化和问答变好,可以和错误跨用户链接共存,碎片-污染这个取舍靠QA看不出来。
$BTC
结果是:在纵向SMIIP-TV上,冻结近注册阈值下真声拒绝率从29.8%升到55.6%,跨约一年;LoCoMo-ID的说话人敏感问答上,门控更新比固定表示分别高3.86和11.62个百分点,且没有错误用户授权。但作者也点明:减少碎片化和问答变好,可以和错误跨用户链接共存,碎片-污染这个取舍靠QA看不出来。
$BTC