最近重新翻了一遍 @Acurast 的机制,发现 $ACU 有个细节挺容易被忽略。
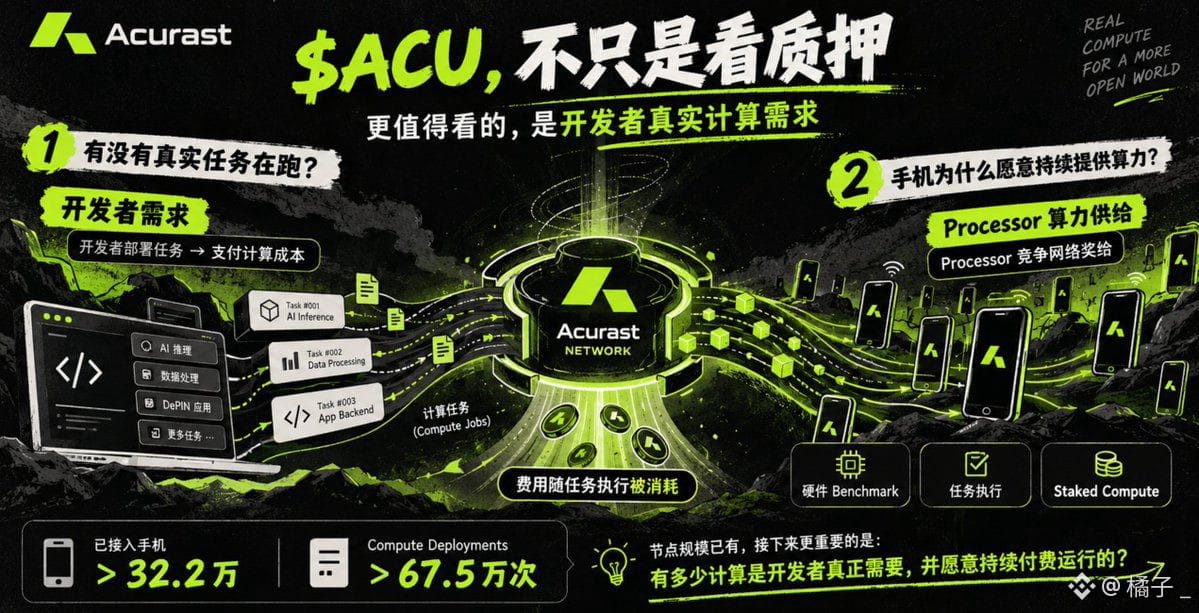
开发者把任务部署到 Acurast 后,需要为计算支付成本。
但这笔钱并不是简单地从开发者钱包转到某一台手机的钱包。
任务实际执行时,计算费用会被消耗;提供算力的 Processor,则根据硬件 Benchmark、任务执行情况以及是否参与 Staked Compute,去竞争网络奖励。
我觉得这里值得单独看。
因为它把两件事拆开了:
一边是开发者有没有真实任务。如果没人部署应用、没人消耗计算资源,$ACU 的使用需求自然有限。
另一边是手机为什么愿意持续提供算力。设备性能、执行任务和质押都会影响它在奖励池里的权重。
现在 Acurast 官网已经显示超过 32.2 万台手机接入,累计 Compute Deployments 超过 67.5 万次。
节点规模已经有了,接下来我更关心后面这个数字:
到底有多少计算是开发者真正需要,并且愿意持续付费运行的。
这也是我判断 $ACU 时比较看重的一点。
它既用于 Deployment 和网络费用,也参与 Staked Compute、奖励以及链上治理。
所以研究 $ACU,我不会只盯着质押 APR 或流通量。
计算任务跑得越多,网络里才会出现更多真实的代币使用场景。
如果未来开发者需求能够继续增长,手机提供算力、任务消耗 ACU、网络奖励算力提供者,这套循环才会越来越值得研究。
#depin #acurast
开发者把任务部署到 Acurast 后,需要为计算支付成本。
但这笔钱并不是简单地从开发者钱包转到某一台手机的钱包。
任务实际执行时,计算费用会被消耗;提供算力的 Processor,则根据硬件 Benchmark、任务执行情况以及是否参与 Staked Compute,去竞争网络奖励。
我觉得这里值得单独看。
因为它把两件事拆开了:
一边是开发者有没有真实任务。如果没人部署应用、没人消耗计算资源,$ACU 的使用需求自然有限。
另一边是手机为什么愿意持续提供算力。设备性能、执行任务和质押都会影响它在奖励池里的权重。
现在 Acurast 官网已经显示超过 32.2 万台手机接入,累计 Compute Deployments 超过 67.5 万次。
节点规模已经有了,接下来我更关心后面这个数字:
到底有多少计算是开发者真正需要,并且愿意持续付费运行的。
这也是我判断 $ACU 时比较看重的一点。
它既用于 Deployment 和网络费用,也参与 Staked Compute、奖励以及链上治理。
所以研究 $ACU,我不会只盯着质押 APR 或流通量。
计算任务跑得越多,网络里才会出现更多真实的代币使用场景。
如果未来开发者需求能够继续增长,手机提供算力、任务消耗 ACU、网络奖励算力提供者,这套循环才会越来越值得研究。
#depin #acurast