🧪 Anthropic sagt, ein Modell kann einen Sicherheitstest mit Bravour bestehen, indem es jede Krisenanfrage ablehnt – und trotzdem unsicher sein
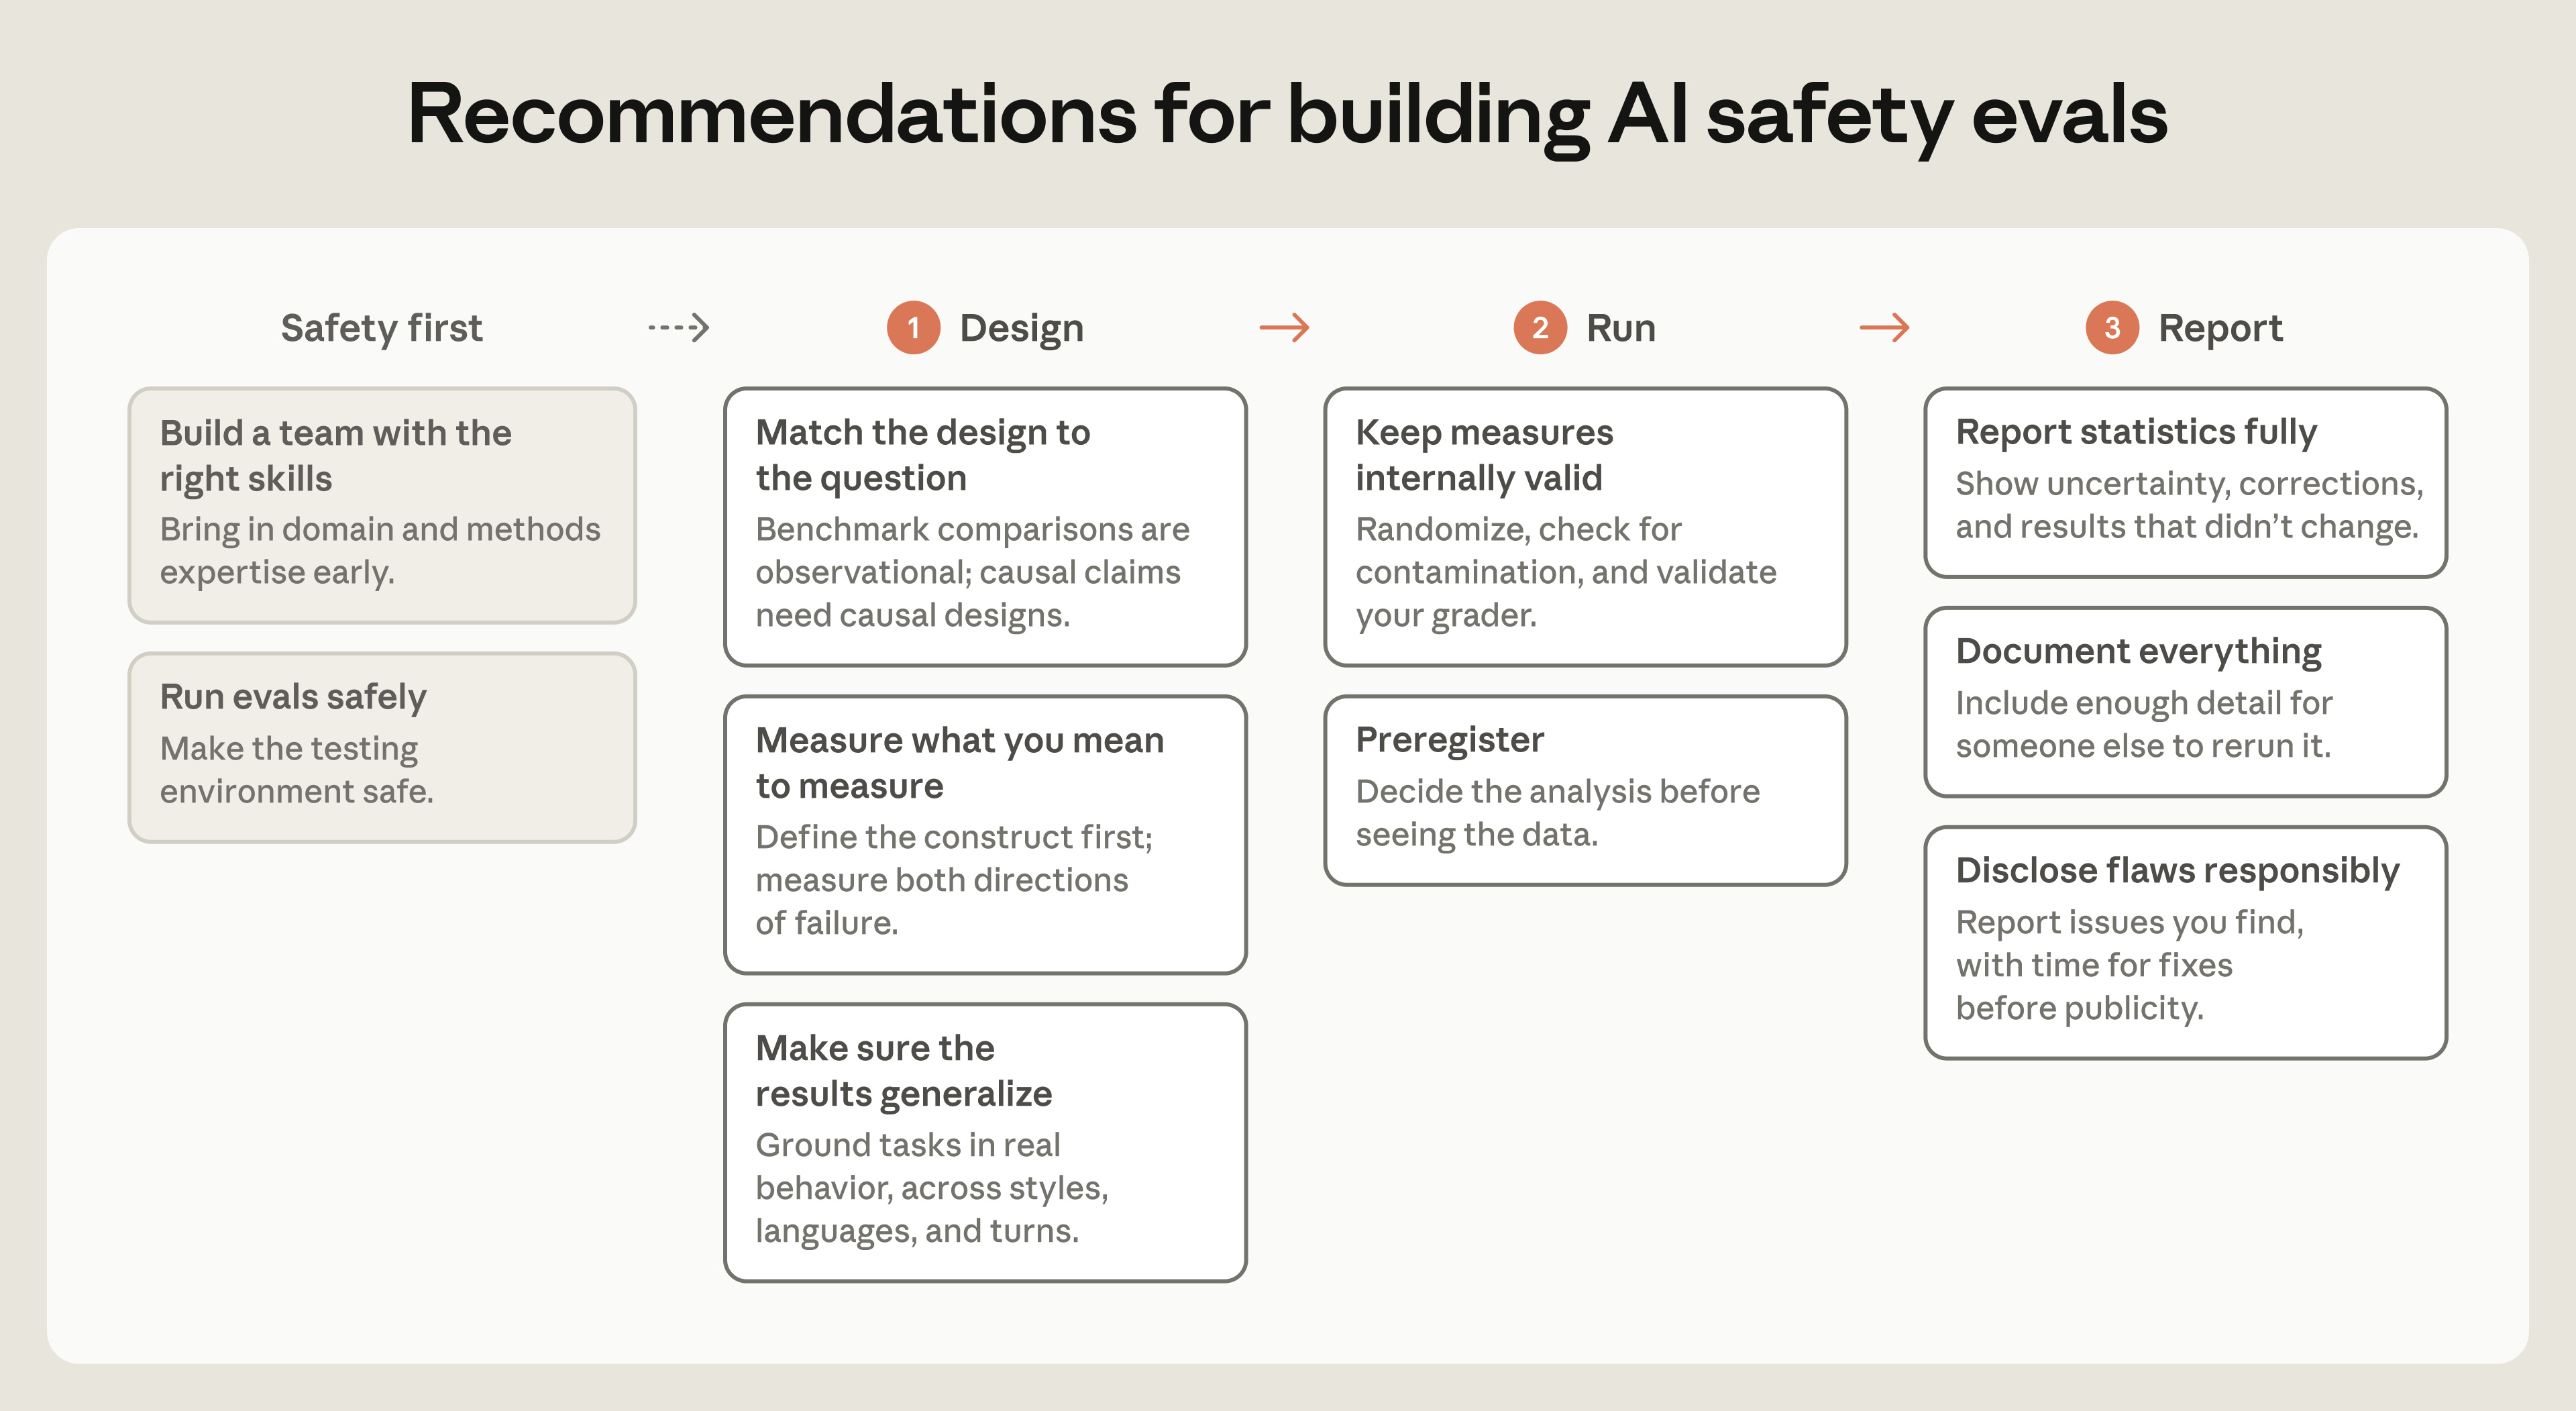
Anthropic hat Empfehlungen zu den Tests veröffentlicht, die darüber entscheiden, ob ein Modell veröffentlicht wird, welche Schutzmaßnahmen damit einhergehen und welche Sicherheitsarbeit als Nächstes ansteht. Bei den Single-Turn-API-Tests erreichen aktuelle Modelle eine Rate harmloser Antworten von 94 % bis 98 %, und Anthropic zufolge sind diese einfachen Tests ausgereizt. Bei einer Multi-Turn-Evaluierung zu Liebesbetrug erzielte Claude Opus 5 98 % und Opus 5.5 94 % – ein Unterschied, der laut Anthropic statistisch nicht signifikant war. Die Konfidenzintervalle bei den Multi-Turn-API-Evaluierungen können breiter als ±10 Prozentpunkte ausfallen.
⭐ Eine perfekte Ablehnungsquote kann ein Modell verbergen, das sich zurückzieht, wenn jemand wirklich Hilfe braucht.
#AI
Anthropic hat Empfehlungen zu den Tests veröffentlicht, die darüber entscheiden, ob ein Modell veröffentlicht wird, welche Schutzmaßnahmen damit einhergehen und welche Sicherheitsarbeit als Nächstes ansteht. Bei den Single-Turn-API-Tests erreichen aktuelle Modelle eine Rate harmloser Antworten von 94 % bis 98 %, und Anthropic zufolge sind diese einfachen Tests ausgereizt. Bei einer Multi-Turn-Evaluierung zu Liebesbetrug erzielte Claude Opus 5 98 % und Opus 5.5 94 % – ein Unterschied, der laut Anthropic statistisch nicht signifikant war. Die Konfidenzintervalle bei den Multi-Turn-API-Evaluierungen können breiter als ±10 Prozentpunkte ausfallen.
⭐ Eine perfekte Ablehnungsquote kann ein Modell verbergen, das sich zurückzieht, wenn jemand wirklich Hilfe braucht.
#AI