

Claude Code liest deine Dateien jetzt mit Opus.
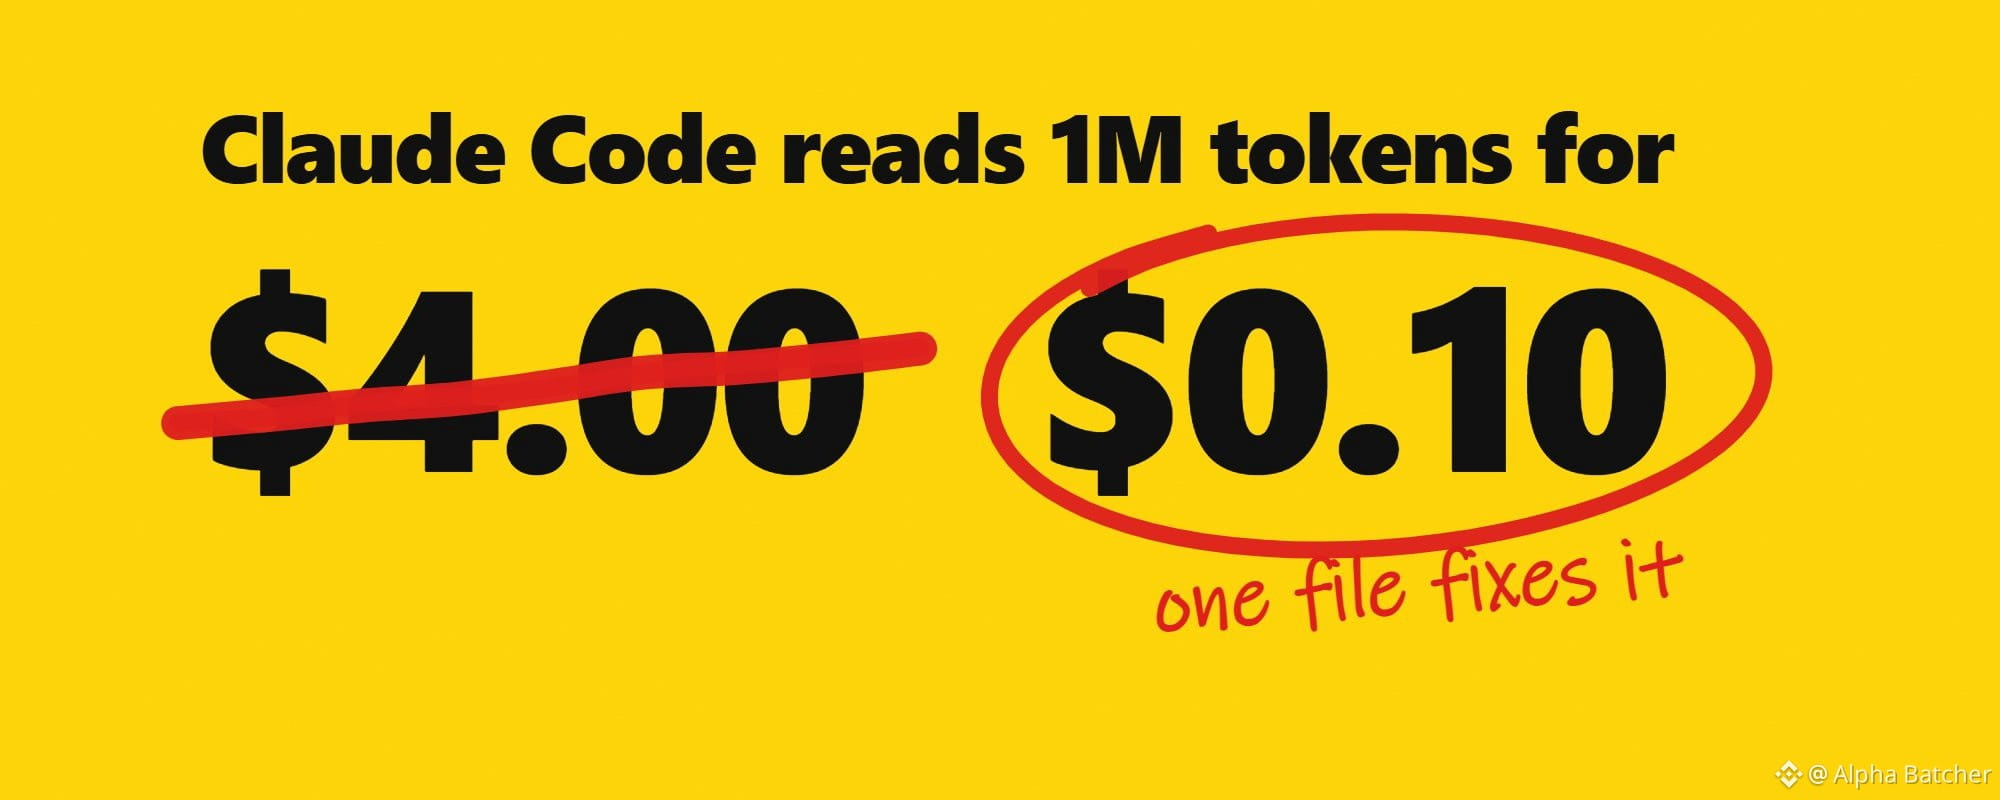
Der integrierte Explore-Subagent, den Claude zum Durchsuchen deiner Codebasis einsetzt, lief früher mit Haiku. In aktuellen Versionen läuft er mit dem Modell deiner Sitzung. Bei der Standardeinstellung ist das Opus 5.5: 4 $ pro Million Eingabetokens gegenüber 0,10 $ bei Haiku 5.5.
Das ist eine Einstellung. Anthropic hat die Zahlen zu den übrigen Einstellungen in seinem Leitfaden vom 9. November zur Auswahl eines Claude-Modells veröffentlicht und in einem Beitrag vom September dazu, was eine Aufgabe mit Opus 5.5 kostet:
• Bei niedrigem Aufwand für alle Aufgaben und einem erneuten Durchlauf mit hohem Aufwand nur bei den fehlgeschlagenen Aufgaben wurden etwa 97 % der Aufgaben für jeweils 0,17 $ abgeschlossen. Bei hohem Aufwand für alle Aufgaben waren es 95,3 % für jeweils 0,29 $.
• Ein Opus-Lead mit bis zu 25 Sonnet-Workern kostete etwa ein Drittel weniger als Opus allein und erzielte ungefähr dieselbe Punktzahl.
• Bei einem API-Schlüssel macht eine sechsminütige Kaffeepause bei 120.000 Kontext-Tokens aus dem nächsten Cache-Lesezugriff für 0,02 $ einen Schreibzugriff für 0,60 $.
• Bei einem Benchmark mit 20 Aufgaben entfielen 43 % der Ausgaben auf nur 2 Aufgaben.
Dieser Kurs macht aus diesen Zahlen konkrete Einstellungen. Jedes Kapitel endet mit etwas, das du in Claude Code einfügst, und nach jedem Kapitel gibst du weniger aus:
• Wohin das Geld fließt: Gesprächsrunden, Cache, Ausgabe und Modell
• Setze Explore und die anderen Leser auf Haiku.
• Lege den Aufwand fest, bevor du das Modell wechselst.
• Halte den Cache warm.
• Sende bei jedem Zug weniger.
• Wähle das Modell passend zur Aufgabe.
• Ein Lead und günstige Worker.
• Miss es anhand deiner eigenen Arbeit.
Wenn du nur 30 Sekunden hast, fassen diese fünf Zeilen den ganzen Kurs zusammen:
Erstelle einen Subagenten namens Explore mit model: haiku und setze alle Subagenten, die nur lesen, auf Haiku.
Beginne mit mittlerem Aufwand. Führe Aufgabenstapel mit niedrigem Aufwand aus und nur die Fehlschläge mit hohem Aufwand erneut.
Bei einem API-Schlüssel vor einer Pause komprimieren, niemals danach.
Halte CLAUDE.md unter 200 Zeilen und schalte MCP-Server ab, die du nicht verwendest.
Lass Opus Entscheidungen und Codeänderungen übernehmen und prüfe nach jeder echten Aufgabe /usage.
Wohin das Geld fließt
Eine Claude-Code-Aufgabe ist eine Schleife: das Gespräch lesen, ein Tool aufrufen, das Ergebnis lesen, wieder von vorn. Jede Runde der Schleife ist eine Anfrage, und vier Dinge bestimmen ihren Preis.
• Gesprächsrunden. Bei jedem Zug wird das gesamte Gespräch erneut gesendet. In Anthropics Beispiel sendet eine Aufgabe, deren Kontext im Laufe von 40 Zügen von 20.000 auf 120.000 Tokens anwächst, etwa 2,8 Millionen Eingabe-Tokens. Dieselbe Aufgabe über 25 Züge sendet etwa 1,75 Millionen.
• Cache-Lesezugriffe. Das meiste, was bei einem Zug erneut gesendet wird, wurde bereits im vorherigen Zug gesendet und daher als Cache-Lesezugriff abgerechnet: bei Opus 5.5 0,20 $ pro Million, ein Zwanzigstel des Eingabepreises von 4 $. Diese 2,8 Millionen Tokens kosten ohne Cache 11,20 $, bei einer Trefferquote von 90 % 1,62 $ und bei 96 % etwa 0,99 $.
• Ausgabe. Bei Opus 5.5 kostet sie 20 $ pro Million – das Hundertfache eines Cache-Lesezugriffs. Nachdenken wird als Ausgabe abgerechnet, auch wenn Claude Code dir nur eine Zusammenfassung zeigt. 60.000 Ausgabe-Tokens kosten 1,20 $, so viel wie 6 Millionen aus dem Cache gelesene Tokens.
• Modell. Es bestimmt den Preis jedes Tokens. Jeder Subagent, der das Modell übernimmt, übernimmt auch dessen Preis.
Führe am Ende deiner nächsten echten Aufgabe /usage aus und lies drei Zeilen:
Cache-Anteil: hoch bei einer langen Sitzung. Niedrig bedeutet eine lange Pause, einen Modellwechsel oder dass ein MCP-Server erst im Laufe der Sitzung verbunden wurde.
Ausgabe im Verhältnis zur Eingabe: Viel Ausgabe bei einer kleinen Änderung bedeutet, dass der Aufwand zu hoch ist oder das Modell es erneut versucht.
Gesamteingabe im Verhältnis zur Gesprächsgröße: Ein Vielfaches bedeutet viele Gesprächsrunden. Lies die Sitzung und finde die Schleife.
Du bekommst die eine Zeile deiner Rechnung, bei der du zuerst ansetzen solltest.
Weniger Gesprächsrunden und ein warmer Cache sparen mehr als jeder Rabatt.
Setze Explore und die anderen Leser auf Haiku.
Ein Subagent ist ein Helfer, den Claude für eine Nebenaufgabe startet. Er arbeitet in seinem eigenen Kontextfenster und gibt eine Zusammenfassung zurück. Seine Tokens werden zum Preis seines eigenen Modells berechnet.
Die integrierten Subagenten von Claude Code laut Dokumentation:
• Explore durchsucht deine Codebasis im Nur-Lese-Modus. Es verwendet das Modell deiner Sitzung. Wenn deine Sitzung mit Fable läuft, wechselt Explore bei einem Claude-Abonnement, einem Anthropic-Console-Konto oder einem Gateway zu Opus; auf Bedrock, Google Cloud, Foundry, Claude Platform auf AWS und einem Claude-Apps-Gateway bleibt es bei Fable.
• Plan recherchiert im Planmodus. Es übernimmt das Modell deiner Sitzung.
• general-purpose erkundet und bearbeitet. Auch dieser Subagent übernimmt das Modell.
Eine Datei namens Explore in deinem Agents-Ordner ersetzt den integrierten Agenten und behält ihr eigenes Modell. Anthropic empfiehlt in seiner Anleitung genau das.
Speichere die Datei für jedes Projekt unter ~/.claude/agents/Explore.md oder für ein einzelnes Projekt unter .claude/agents/Explore.md:
---
name: Explore
description: Schneller, schreibgeschützter Agent zum Durchsuchen und Verstehen einer Codebasis. Verwende ihn, um Dateien zu finden, Code zu durchsuchen und Fragen wie „Wo ist das?“ zu beantworten.
tools: Read, Grep, Glob
model: haiku
omitClaudeMd: true
---
Nur suchen und lesen. Niemals Dateien erstellen oder bearbeiten. Antworte mit Dateipfaden, Zeilennummern und einer kurzen Zusammenfassung deiner Ergebnisse.
omitClaudeMd startet den Agenten ohne deine CLAUDE.md, so wie auch der integrierte Explore gestartet wird. Starte Claude Code neu, wenn der Agents-Ordner vorher noch nicht existierte, und führe claude update aus: Bei der Anthropic API verweist der Alias haiku ab v2.1.293 auf Haiku 5.5. Auf Bedrock, Google Cloud, Foundry und Claude Platform auf AWS bedeutet er weiterhin Haiku 4.5.
Mach dasselbe für alle Helfer, die ausschließlich Logs, Testergebnisse oder Suchergebnisse lesen. Dieses Beispiel stammt von Anthropic selbst:
---
name: log-reader
description: Liest Testergebnisse und Logs und meldet jeden fehlgeschlagenen Testfall. Nach einem Testlauf verwenden.
tools: Read, Grep, Glob, Bash
model: haiku
---
Lies die Logs, die du erhältst. Melde für jeden Fehler die Datei, den Testnamen und die erste Fehlerzeile. Bearbeite keine Dateien.
Um alle Subagenten auf dasselbe Modell zu setzen, lege die Umgebungsvariable CLAUDE_CODE_SUBAGENT_MODEL fest. Ein in der Datei eines Subagenten angegebenes Modell hat Vorrang vor der Variable.
Lass Codeänderungen und Ermessensentscheidungen von deinem Hauptmodell erledigen. Wenn ein kleines Modell ein Suchergebnis falsch versteht, schickt es das Hauptmodell zur falschen Datei – und das Hauptmodell bezahlt für den Umweg.
Suchergebnisse, Logs und Testergebnisse kosten dich dann 0,10 $ pro Million Eingabe-Tokens statt 4 $. Führe beim nächsten Delegieren durch Claude /tasks aus, um zu sehen, welches Modell jeder Subagent verwendet.
Eine Datei pro Leser, und das Lesen kostet keine Opus-Preise mehr.
Lege den Aufwand fest, bevor du das Modell wechselst.
Der Aufwand bestimmt, wie viel das Modell in jeder Gesprächsrunde nachdenkt, schreibt und Tools aufruft. Opus 5.5 bietet niedrig, mittel, hoch und xhoch sowie max für eine einzelne Sitzung. In Claude Code ist mittel die Standardeinstellung.
Anthropic hat das mit Opus 5.5 anhand einer Teilmenge von SWE-bench Pro gemessen:
• Mittel: etwa 2,5 Punkte unter hoch, bei ungefähr 70 % der Kosten.
• Niedrig: etwa 8 Punkte unter hoch, bei ungefähr einem Drittel der Kosten.
• Xhoch: etwa 1,4 Punkte über hoch, bei 2,5-fachen Kosten.
Dann der Lauf, der alle anderen übertraf: alles auf niedrig, und nur die Fehlschläge wurden mit hohem Aufwand erneut ausgeführt. Etwa 97 % der Aufgaben wurden für je 0,17 $ erledigt, gegenüber 95,3 % für je 0,29 $, wenn alle Aufgaben mit hohem Aufwand bearbeitet wurden.
Das funktioniert nur, wenn Claude seine Arbeit selbst überprüfen kann: mit einem Test, einem Build oder einem Skript, das den Endpunkt aufruft. Eine Überprüfung kostet eine Gesprächsrunde und deren Ausgabe. Mehr Aufwand bedeutet mehr Nachdenken in jeder Runde.
Wenn ein Modell nicht gut genug ist, empfiehlt Anthropic in seiner Anleitung diese Reihenfolge:
1. Gib ihm eine Möglichkeit, seine Arbeit zu überprüfen.
2. Erhöhe den Aufwand um eine Stufe.
3. Wechsle zum nächsthöheren Modell und verwende dabei weniger Aufwand als beim kleineren Modell.
Führe für einen Aufgabenstapel /effort low aus und füge Folgendes ein:
Erledige alle Aufgaben in todo.md nacheinander. Führe nach jeder Aufgabe den zugehörigen Test aus. Schreibe die Aufgaben, deren Tests fehlschlagen, jeweils mit ihrer ersten Fehlerzeile in failed.md. Ändere nichts außerhalb dieses Repositorys und pushe nichts.
Führe dann /effort high aus und füge Folgendes ein:
Bearbeite nur die Aufgaben in failed.md erneut und führe ihre Tests noch einmal aus. Sag mir, welche weiterhin fehlschlagen. Pushe nichts.
Du bekommst einen günstigen ersten Durchlauf für alles und hohen Aufwand nur dort, wo der erste Durchlauf fehlgeschlagen ist.
Mit einem API-Schlüssel oder einem Abonnement bleibt dein Cache erhalten, wenn du den Aufwand änderst. Auf Bedrock, der Agent Platform von Google Cloud oder einem Gateway wird der Cache geleert – ändere den Aufwand dort also während einer Pause.
Erst niedrig, dann hoher Aufwand bei den Fehlschlägen – so bezahlst du fürs Nachdenken nur dort, wo es das Ergebnis verändert.
Halte den Cache warm.
Der Cache speichert den Teil des Gesprächs, den Claude Code nicht zum vollen Preis erneut senden muss. Bei Opus 5.5 kostet ein Cache-Lesezugriff 5 % eines frischen Eingabe-Tokens. Ein Cache-Schreibzugriff kostet bei einem fünfminütigen Cache das 1,25-Fache des Eingabepreises und bei einem einstündigen Cache das Doppelte.
Wie lange der Cache erhalten bleibt, hängt von deiner Zahlungsart ab: eine Stunde bei einem Claude-Abonnement, fünf Minuten bei einem API-Schlüssel oder Cloud-Anbieter und fünf Minuten, sobald ein Abonnement auf Nutzungsguthaben zurückgreift.
Das ist die Kaffeepause. Bei 120.000 Kontext-Tokens kostet ein Lesezugriff etwa 0,02 $ und ein neuer fünfminütiger Schreibzugriff etwa 0,60 $. Legst du mit einem API-Schlüssel sechs Minuten Pause ein, kostet dich der nächste Zug den Schreibzugriff.
Auch in diesen Fällen kostet der nächste Zug einen Schreibzugriff:
• Modellwechsel: Das neue Modell startet mit einem leeren Cache.
• Einen MCP-Server mitten in der Sitzung verbinden oder trennen.
• Den Schnellmodus zum ersten Mal in einem Gespräch aktivieren.
• Komprimieren, wodurch der Verlauf neu geschrieben wird, auf den der Cache abgestimmt war.
• Den Aufwand auf Bedrock, der Agent Platform von Google Cloud oder einem Gateway ändern.
Richte diese Dinge zu Beginn der Sitzung ein und lass sie unverändert, während du arbeitest.
Komprimiere an einer natürlichen Unterbrechung, solange der Cache noch warm ist. Bei 150.000 Tokens kostet /compact etwa 0,25 $ und spart bei jedem späteren Zug etwa 0,025 $ – es macht sich also nach ungefähr 10 Gesprächsrunden bezahlt. Nach einer Pause, die länger als die Cache-Lebensdauer dauert, liest dasselbe /compact das gesamte Gespräch erneut: bei 150.000 Tokens etwa 0,75 $.
/clear kostet nichts – verwende es also zwischen nicht zusammenhängenden Aufgaben. /rewind springt zu einem früheren, noch im Cache gespeicherten Zug zurück, wenn du einen Pfad verwerfen möchtest.
Füge Folgendes ein, bevor du dich entfernst:
/compact behalte die Namen der fehlgeschlagenen Tests, die von uns geänderten Dateien und den nächsten Schritt
Du bekommst ein kurzes Gespräch, das bei deiner Rückkehr noch im Cache liegt.
Vor der Kaffeepause komprimieren, niemals danach.
Sende bei jedem Zug weniger.
Bei jedem Zug wird alles Vorherige erneut gesendet. Bei 20.000 Kontext-Tokens kostet der Cache-Lesezugriff eines Zugs mit Opus 5.5 etwa 0,004 $. Bei 150.000 sind es etwa 0,03 $. Bei 30 Gesprächsrunden fallen allein für Lesezugriffe 0,90 $ an, gegenüber etwa 0,12 $ bei 20.000 Tokens.
Drei Dinge werden geladen, bevor du etwas eingibst:
• CLAUDE.md wird in jede Sitzung geladen und bei jedem Zug erneut gesendet. Laut der Kostendokumentation von Anthropic sollte sie weniger als 200 Zeilen umfassen.
• MCP-Server. Zu Beginn werden nur die Toolnamen und Serveranweisungen geladen; eine vollständige Definition wird geladen, wenn das Tool verwendet wird. Führe /mcp aus und schalte Server ab, die du nicht verwendest.
• Alte Anweisungen. Prompts, die für ein älteres Modell geschrieben wurden, können Opus 5.5 dazu bringen, mehr zu schreiben und Tool-Aufrufe zu wiederholen. Beim 44-Ticket-Supportbenchmark von Anthropic senkte der Wechsel von Opus 4.8 zu Opus 5.5 mit niedrigem Aufwand die Kosten um etwa 18 %. Der Befehl /claude-api prompt-audit von Claude Code senkte sie um weitere 9 %.
Führe zuerst /claude-api prompt-audit aus und füge dann Folgendes ein:
Lies meine CLAUDE.md und alle Dateien, die sie importiert. Schlage eine Version mit weniger als 200 Zeilen vor: Behalte die Befehle zum Erstellen und Testen, die Regeln, die Claude nicht aus dem Code ableiten kann, und alles, was früher schon Probleme verursacht hat. Verschiebe den Rest nach docs/ und verlinke ihn in CLAUDE.md. Zeig mir den Diff und ändere nichts, bis ich zustimme.
Du erhältst eine kürzere CLAUDE.md, entfernte alte Ritualanweisungen und eine Liste der Server, die du abschalten kannst.
Ein kürzerer Kontext macht jeden deiner Züge günstiger.
Wähle das Modell passend zur Aufgabe.
Preise pro Million Tokens:
• Haiku 5.5: 0,10 $ für Eingaben und 0,50 $ für Ausgaben bei Prompts bis zu 100.000 Tokens; darüber 0,50 $ und 2,50 $.
• Sonnet 5.5: 2 $ für Eingaben und 10 $ für Ausgaben.
• Opus 5.5: 4 $ für Eingaben und 20 $ für Ausgaben.
• Fable 5.2: 8 $ für Eingaben und 40 $ für Ausgaben.
Anthropics Empfehlungen für den Einstieg:
• Haiku 5.5: Klassifizierung, Routing, Extraktion und Subagenten, die Dateien durchsuchen, Logs lesen oder Zusammenfassungen erstellen.
• Sonnet 5.5: klar umrissene Programmieraufgaben wie Fehlerbehebungen und Funktionen nach Spezifikation, Chat, alltägliche Dokumente und Agentenaufgaben, die du immer wieder ausführst.
• Opus 5.5 mit mittlerem Aufwand: alltägliche Entwicklungsarbeit und Fehlersuche sowie alles, bei dem du unsicher bist. Es ist der Standard in Claude Code.
• Fable 5.2: umfangreiche Refactorings und Migrationen, Architektur, tiefgehende Recherche und die Leitung vieler Subagenten. Wechsle dazu, wenn Opus 5.5 mit hohem Aufwand noch nicht ausreicht.
Ein höherer Preis pro Token bedeutet nicht immer höhere Kosten pro Aufgabe. Auf FrontierCode 2.0 erzielte Fable 5.2 mit hohem Aufwand ein ähnliches Ergebnis wie Opus 5.5 mit maximalem Aufwand: 45,3 % gegenüber 45,5 %, bei ungefähr halben Kosten pro Aufgabe. Bevor du Opus bei einer schwierigen Aufgabe über hohen Aufwand hinaus hochstufst, probiere Fable mit geringerem Aufwand aus.
Wechsle an einer natürlichen Unterbrechung. Der Cache gehört dem Modell, das ihn erstellt hat. Deshalb kostet der erste Zug mit einem neuen Modell einen Schreibzugriff für das gesamte Gespräch. Führe vorher /compact aus oder beginne neu mit einem kurzen schriftlichen Plan.
Der Alias opusplan plant mit Opus und lässt Sonnet die Änderungen vornehmen. Damit liegen deine Codeänderungen beim günstigeren Modell – das Gegenteil der oben beschriebenen Leser-Konfiguration. Miss die Leistung bei deinen eigenen Aufgaben, bevor du es als Standard festlegst.
Füge Folgendes ein:
Lies todo.md. Gib für jede Aufgabe das Modell und den Aufwand an, mit denen sie beginnen sollte: Haiku für Nachschlagen und Log-Lesen, Sonnet für klar umrissene Korrekturen nach Spezifikation, Opus mit mittlerem Aufwand für alltägliche Arbeit und alles Unklare, Fable für Migrationen, große Refactorings und Arbeiten, bei denen viele Subagenten zum Einsatz kommen. Speichere routing.md mit einer Zeile pro Aufgabe und der Begründung. Ändere keine Einstellungen.
Du erhältst routing.md: ein Modell und einen Aufwand für jede Aufgabe, bevor du beginnst.
Standardmäßig Opus, Haiku zum Lesen, Fable, wenn Opus mit hohem Aufwand nicht ausreicht.
Ein Lead und günstige Worker.
Wenn eine Aufgabe nicht in ein einziges Kontextfenster passt, lass das stärkste Modell die Leitung übernehmen und die günstigeren Modelle die einzelnen Teile bearbeiten.
Bei einem internen Benchmark, der etwa 22 Millionen Tokens Quellcode nach Fehlern durchsuchte, kostete ein Opus-5.5-Lead mit Sonnet-5.5-Workern – bis zu 25 gleichzeitig – etwa ein Drittel weniger als Opus 5.5 allein mit seinem Standardaufwand und erzielte ungefähr dasselbe Ergebnis.
Überspringe das, wenn die Arbeit aus einer Kette voneinander abhängiger Schritte besteht oder in ein Kontextfenster passt. Dann kosten Planung und Zusammenführen mehr, als sie einsparen.
Halte Teams klein. Agententeams sind eine experimentelle Funktion, bei der jeder Teamkollege als eigene Claude-Code-Instanz läuft. Laut der Kostendokumentation von Anthropic verbraucht ein Team etwa siebenmal so viele Tokens wie eine Standardsitzung, wenn die Teammitglieder im Planmodus arbeiten. Beende jeden Teamkollegen, sobald sein Teil erledigt ist.
Das Advisor-Tool kombiniert einen günstigen Executor mit einem leistungsfähigeren Advisor, den er um Hilfe bitten kann. In Anthropics eigener Tabelle übertraf keine der vier Kombinationen ihren Executor eindeutig allein. Miss also, wie oft dein Executor um Rat fragt, bevor du für einen Advisor zahlst.
Füge Folgendes ein:
Teile [die Aufgabe] in unabhängige Teile auf, die jeweils in ein Kontextfenster passen. Du bist der Lead: Schreibe den Plan in plan.md und übergib dann jeden Teil einem Sonnet-Subagenten samt Liste der Dateien, die er bearbeiten darf. Führe die Ergebnisse zusammen. Kein Teil darf dieselbe Datei bearbeiten wie ein anderer. Führe nach jedem Zusammenführen die Tests aus. Zeig mir plan.md, bevor du einen Subagenten startest.
Du erhältst plan.md, parallel mit Sonnet erledigte Teilaufgaben und Opus, das für den Plan und das Zusammenführen eingesetzt wurde.
Der Lead entscheidet, die Worker lesen und schreiben.
Miss es anhand deiner eigenen Arbeit.
Alle Zahlen oben stammen aus Tests von Anthropic. Deine Ergebnisse hängen von deiner Codebasis und deinen Gewohnheiten ab.
• /usage zeigt am Ende einer Aufgabe Tokens, Cache-Anteil und geschätzte Kosten zum Listenpreis. /cost macht dasselbe. Bei einem Pro-, Max-, Team- oder Enterprise-Tarif ist der Dollarbetrag ein Richtwert für den Umfang deiner Arbeit; auf demselben Bildschirm werden auch deine Nutzungsbalken angezeigt.
• /effort status zeigt deine Aufwandsstufe und /tasks, welches Modell jeder Subagent verwendet.
• Für ein Team liefert die Claude Code Analytics API die geschätzten Kosten pro Nutzer. Die Usage and Cost API schlüsselt die Ausgaben nach Modell sowie nach gecachten und nicht gecachten Tokens auf.
• Ein Richtwert aus der Kostendokumentation von Anthropic: etwa 13 $ pro Entwickler und aktivem Tag bei Enterprise-Installationen und weniger als 30 $ pro Tag für 90 % der Nutzer.
Wähle eine echte Aufgabe aus deinem Backlog und führe sie mit zwei Konfigurationen aus. Füge Folgendes einmal pro Konfiguration ein:
Ich vergleiche zwei Konfigurationen für dieselbe Aufgabe. Die Aufgabe: [Aufgabe]. Erledige sie, führe den Test aus und sag mir nach Abschluss, wie viele Züge du gebraucht hast und wodurch sich die Anzahl verringert hätte. Pushe nichts.
Prüfe nach jedem Durchlauf /usage, führe dann /clear aus, wechsle mit /model oder /effort und füge den Text erneut ein.
Du erhältst deine eigenen Kosten pro Aufgabe für jede Konfiguration.
Dein eigener Wert von /usage ist der maßgebliche.
Ein einziger Text richtet die Haiku-Leser, die kürzere CLAUDE.md und das Modell-Routing ein. Öffne Claude Code in deinem Repository und füge Folgendes ein:
Hilf mir, bei Claude Code Schritt für Schritt weniger auszugeben. Zeig mir nach jedem Schritt die Änderung und warte auf mein „go“.
1. Erstelle ~/.claude/agents/Explore.md: name Explore, eine Beschreibung, die ihn als schnellen, schreibgeschützten Suchagenten bezeichnet, tools Read, Grep, Glob, model: haiku, omitClaudeMd: true sowie einen Inhalt, der besagt: nur suchen und lesen, niemals Dateien erstellen oder bearbeiten.
2. Erstelle .claude/agents/log-reader.md mit model: haiku. Der Agent liest Testergebnisse und Logs und meldet jeden Fehler mit Datei, Testnamen und erster Fehlerzeile. Er bearbeitet niemals Dateien.
3. Lies CLAUDE.md und alle Dateien, die sie importiert, und schlage eine Version mit weniger als 200 Zeilen vor. Verschiebe den Rest nach docs/.
4. Liste die MCP-Server in meiner Konfiguration auf und markiere die, die dieses Repository nie verwendet.
5. Lies todo.md und erstelle routing.md mit einem Einstiegsmodell und einem Aufwand für jede Aufgabe.
Ändere keine anderen Einstellungen, pushe nichts und lösche nichts, ohne vorher zu fragen.
Nach dem Einfügen hast du:
• Explore und ein Log-Leser auf Haiku.
• Eine CLAUDE.md mit weniger als 200 Zeilen; der Rest liegt in docs/.
• Eine Liste der MCP-Server, die du abschalten kannst.
• routing.md: ein Modell und ein Aufwand für jede Aufgabe.
Die Konfiguration auf einer Seite.
EXPLORE ~/.claude/agents/Explore.md, model: haiku, omitClaudeMd: true.
LESER Log- und Such-Subagenten auf haiku. Codeänderungen bleiben beim Hauptmodell.
AUFWAND Standardmäßig mittel. Aufgabenstapel mit niedrigem Aufwand, Fehlschläge mit hohem Aufwand erneut ausführen.
ÜBERPRÜFEN Ein Test oder Build, den Claude ausführen kann, bevor du den Aufwand erhöhst.
CACHE Abonnement: 1 Stunde, API-Schlüssel: 5 Minuten. Vor einer Pause /compact ausführen.
KONTEXT CLAUDE.md mit weniger als 200 Zeilen. Ungenutzte MCP-Server ausschalten.
MODELL Haiku zum Lesen, Sonnet für klar umrissene Aufgaben, Opus für den Alltag, Fable für die schwierigsten Aufgaben.
TEAMS Opus-Lead und Sonnet-Worker nur dann, wenn die Arbeit nicht in ein Kontextfenster passt.
PRÜFEN Nach echten Aufgaben /usage, für Subagent-Modelle /tasks ausführen.
Mach einen Screenshot davon.
Speichere heute Abend die Explore-Datei, starte Claude Code neu und führe /tasks aus, wenn Claude das nächste Mal deinen Code durchsucht.