


Am 29. Oktober stellte Mistral die Gewichte von Large 4 zum Download bereit. Das bedeutet, dass Unternehmen und Regierungen das KI-Modell für Cybersicherheit intern einsetzen können, statt von amerikanischen oder chinesischen Unternehmen abhängig zu sein. Diese Freiheit hat jedoch ihren Preis. Da Mistral nur wenig Kontrolle über das Modell hat, kann das Unternehmen nicht bestimmen, wer es nutzen darf und zu welchen Zwecken.
Von der API-Vorschau zu herunterladbaren Gewichten
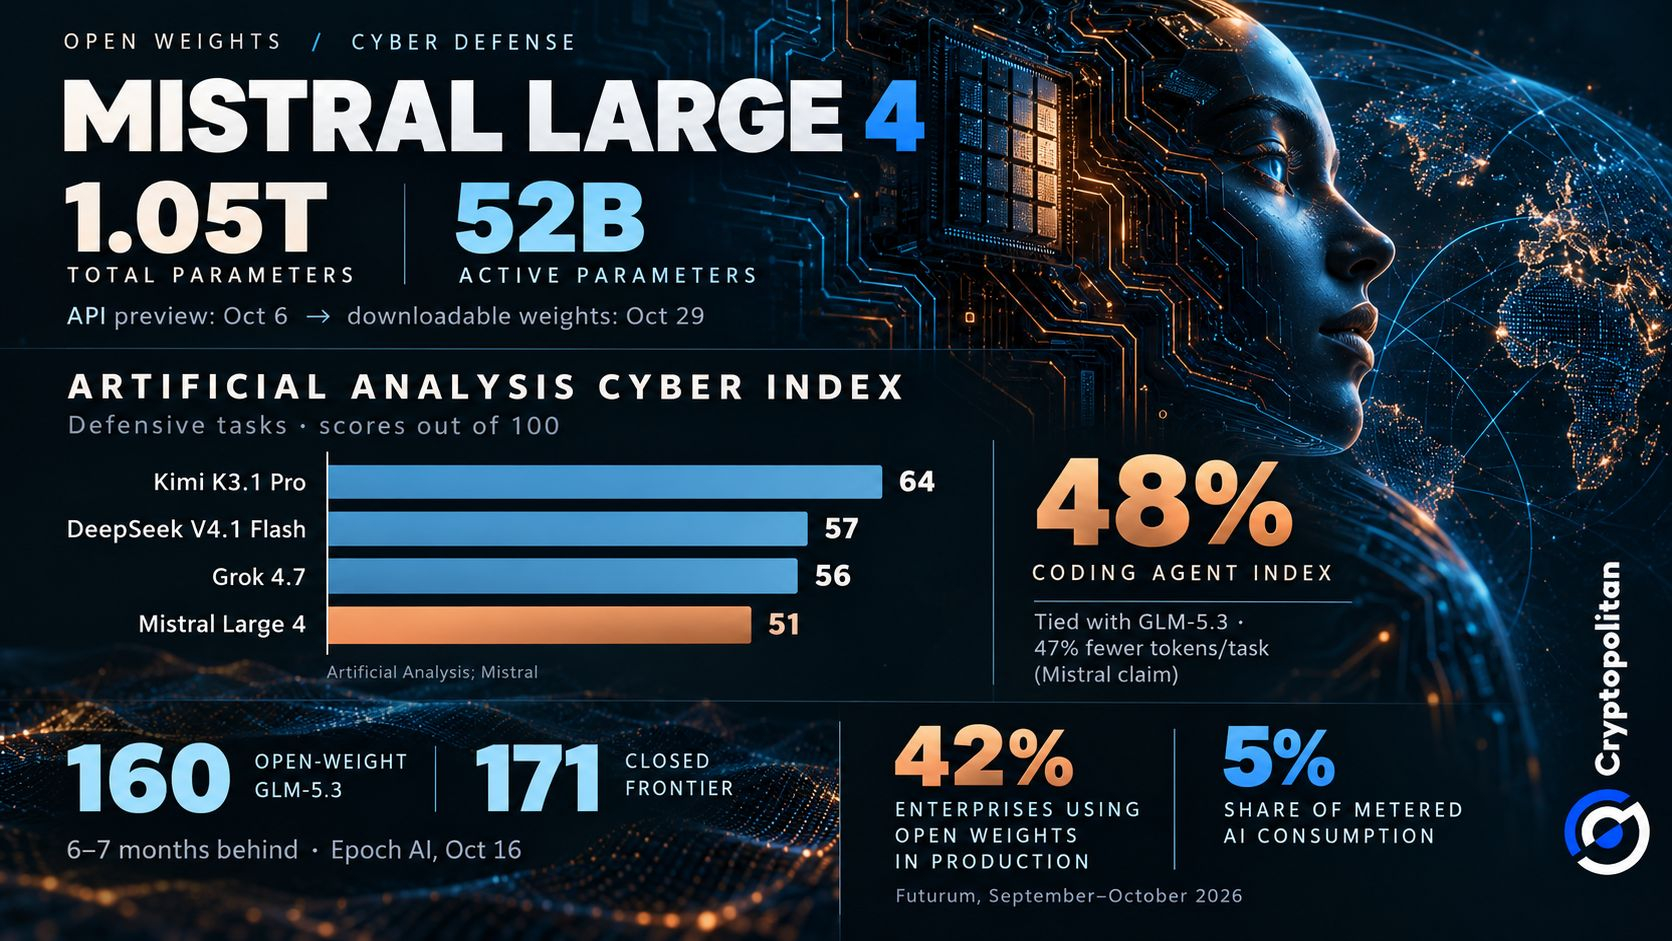
Large 4 von Mistral wurde erstmals am 6. Oktober über eine API bereitgestellt; am 29. Oktober wurden die Gewichte zum Download freigegeben. Der API-Zugriff ist weiterhin als Bereitstellungsoption möglich. Den offiziellen Spezifikationen von Large 4 zufolge hat das Modell 1,05 Billionen Parameter, darunter 52 Milliarden aktive Parameter – geringfügig mehr als die 49 Milliarden, über die Cryptopolitan zuvor berichtet hatte.
Unternehmen können das Modell anpassen und selbst hosten. Wer es jedoch als gehosteten Dienst weiterverkaufen möchte, benötigt eine separate kommerzielle Lizenz. Diese Unabhängigkeit ist ein zentraler Bestandteil von Mistrals Angebot. Wie Unternehmenschef Pierre Stock gegenüber TechCrunch erklärte, könne der Zugang „nicht gesperrt werden“.
Was die Benchmarks zeigen – und was nicht
Mistral zufolge erzielte Large 4 im Coding Agent Index 48 % und lag damit fast gleichauf mit GLM-5.3. Allerdings benötigte Large 4 pro Aufgabe 47 % weniger Tokens. Das Unternehmen meldete außerdem Ergebnisse von 19,7 % im FrontierCode 2.0 und 41 % im Terminal-Bench 4.0.
Bei der Cybersicherheit ergibt sich ein etwas anderes Bild. Large 4 erzielte im Artificial Analysis Cyber Index 51 Punkte und lag damit hinter Kimi K3.1 Pro (64), DeepSeek V4.1 Flash (57) und Grok 4.7 (56). Diese Werte müssen jedoch eingeordnet werden. Der Index misst, wie gut KI-Modelle Sicherheitslücken finden und beheben. Er bewertet nicht ihre Fähigkeit, Cyberangriffe auszuführen.
 Mistral Large 4: Cyber-KI-Benchmarks im Vergleich zu Konkurrenten und die Verbreitung offener Gewichte
Wie weit zurück liegt das Modell hinter den geschlossenen Spitzenmodellen?
Trotz der von Mistral gemeldeten Verbesserungen von Large 4 beim Programmieren und bei der defensiven Cybersicherheit liegen führende Modelle mit offenen Gewichten weiterhin hinter den stärksten geschlossenen Systemen zurück. Eine Analyse von Epoch AI vom 16. Oktober gab GLM-5.3, dem führenden Modell mit offenen Gewichten, einen Cyber-ECI-Wert von 160. Die stärksten geschlossenen Modelle erzielten 171 Punkte. Anhand der historischen Leistung schätzte Epoch, dass Modelle mit offenen Gewichten sechs bis sieben Monate hinter der geschlossenen Spitze zurückliegen. Die Bewertung erfolgte jedoch, bevor Large 4 endgültig veröffentlicht wurde.
Das britische AI Security Institute kam zu einem ähnlichen Schluss. Es schätzte den Rückstand von Modellen mit offenen Gewichten auf ihre Konkurrenten mit geschlossenen Gewichten auf vier bis sieben Monate, wobei sich die Tests von denen von Epoch AI unterschieden.
Das Problem beschränkt sich nicht auf defensive Fähigkeiten. Im Rahmen kontrollierter Tests berichtete Anthropic, dass GLM-5.3 in 50 von 410 Versuchen bestehende Sicherheitslücken erfolgreich ausnutzte. Forschern gelang es in 64 bis 100 % ihrer verschiedenen Simulationen, die Sicherheitsvorkehrungen des Modells zu umgehen.
Das Versprechen digitaler Souveränität trifft auf die Realität der Nutzung
Unternehmen zeigen zunehmendes Interesse daran, ihre KI-Systeme selbst zu kontrollieren, doch die Ausgaben erzählen eine andere Geschichte. Berichten zufolge nutzten im September 42 % der befragten Unternehmen Modelle mit offenen Gewichten in der Produktion, gegenüber 31 % im Juli.
Dennoch entfielen im Oktober nur 5 % des gemessenen KI-Verbrauchs auf Modelle mit offenen Gewichten. Auf Claude entfielen 29 %, während Microsoft 365 Copilot 36 % ausmachte.
Futurum stellte außerdem fest, dass die Herkunft des Modells die Entscheidungen von 47 % der Nutzer in der Produktion beeinflusste. Die Umfrage konzentrierte sich jedoch größtenteils auf Nordamerika, was die Aussagekraft allgemeiner Schlussfolgerungen einschränkt.
Für Unternehmen bedeutet größere Unabhängigkeit auch mehr Verantwortung. PwC warnte, dass Unternehmen, die sich für Modelle mit offenen Gewichten entscheiden, ihre Sicherheit und Wartung selbst gewährleisten müssen.
Sicherheitsvorkehrungen, die sich nicht zurücknehmen lassen
Diese Verantwortung gewinnt besonders an Bedeutung, wenn KI-Modelle sensible Aufgaben im Bereich Cybersicherheit übernehmen können. Mistral zufolge weist Large 4 96,6 % schädlicher Cyber-Anfragen zurück. Nach dem Herunterladen des Modells lassen sich diese Sicherheitsvorkehrungen jedoch entfernen. Das AISI warnt außerdem, dass Entwickler privat gehostete Kopien weder überwachen noch zurückziehen können.
Moonshot hat einen anderen Ansatz gewählt. Das Unternehmen entfernte Schulungsmaterial zur Cybersicherheit aus Kimi K3.1 Pro, bevor die Gewichte wie geplant am 4. November veröffentlicht werden sollten. Anschließend sank der Wert des internen offensiven Benchmarks von 90,5 % auf 81,0 %. Diese Ergebnisse wurden jedoch nicht unabhängig überprüft.
Bis zum 30. Oktober war kein öffentlich dokumentierter Cyberangriff mit den neu veröffentlichten Gewichten von Large 4 in Verbindung gebracht worden.
Lies nicht einfach nur Krypto-News. Versteh sie. Abonniere unseren Newsletter. Er ist kostenlos.