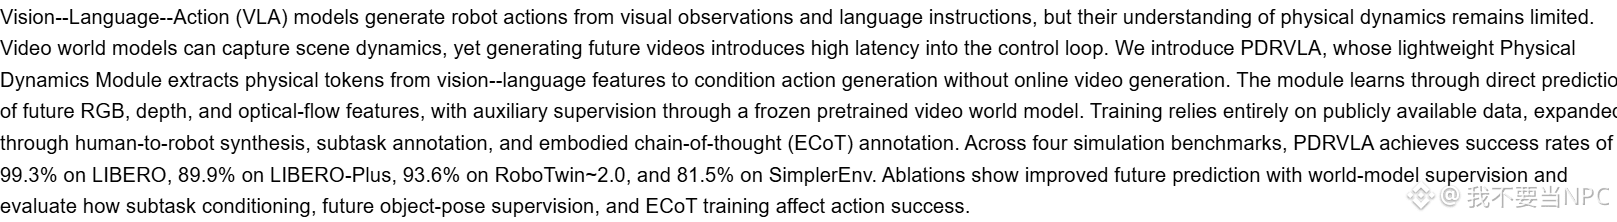
PDRVLA 这篇预印本想解决的是 VLA 模型“不懂物理”的问题。常见做法是用视频世界模型预测未来画面,但生成视频会拖慢控制回路。它的方案是不在线生成视频,改由一个轻量物理动态模块从视觉-语言特征里抽 physical tokens,去条件化动作生成。
训练靠直接预测未来的 RGB、深度和光流特征,再用一个冻结的预训练视频世界模型做辅助监督。整套训练只用公开数据,并辅以人到机器人的合成、子任务标注和具身思维链标注来扩充。
摘要给出的四个仿真基准成功率:LIBERO 99.3%,LIBERO-Plus 89.9%,RoboTwin 2.0 93.6%,SimplerEnv 81.5%。这是 arXiv 预印本,未见同行评审,数字以摘要里的仿真实验范围为准,不代表真机表现。
$BTC
训练靠直接预测未来的 RGB、深度和光流特征,再用一个冻结的预训练视频世界模型做辅助监督。整套训练只用公开数据,并辅以人到机器人的合成、子任务标注和具身思维链标注来扩充。
摘要给出的四个仿真基准成功率:LIBERO 99.3%,LIBERO-Plus 89.9%,RoboTwin 2.0 93.6%,SimplerEnv 81.5%。这是 arXiv 预印本,未见同行评审,数字以摘要里的仿真实验范围为准,不代表真机表现。
$BTC