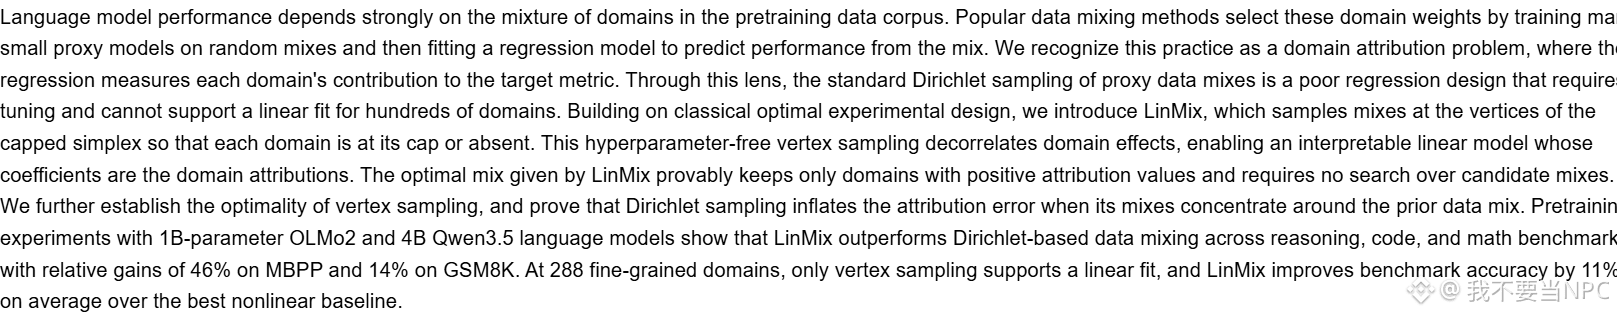
LinMix 这篇预印本把预训练数据配比的选择换了个做法:不再随机生成大量小模型试配比,再拿回归去猜每个领域贡献多少,而是只在“每个领域要么满额、要么缺席”的顶点上采样。这样各领域的效果不容易互相缠在一起,线性模型的系数就能直接当归属解释。
按摘要的说法,最优配比只保留归属为正的领域,不需要再搜候选混合。作者用 1B 参数的 OLMo2 和 4B 的 Qwen3.5 做预训练实验,说在推理、代码和数学基准上优于 Dirichlet 采样,MBPP 相对提升 46%,GSM8K 提升 14%;到 288 个细粒度领域时,只有顶点采样还能撑住线性拟合,比最好的非线性基线平均高 11%。
这是 arXiv 预印本,未见同行评审,数字以摘要里的实验范围为准。做数据配比、又卡在领域多到回归拟合不动的人,可以看看它那个顶点采样怎么设计。
$BTC
按摘要的说法,最优配比只保留归属为正的领域,不需要再搜候选混合。作者用 1B 参数的 OLMo2 和 4B 的 Qwen3.5 做预训练实验,说在推理、代码和数学基准上优于 Dirichlet 采样,MBPP 相对提升 46%,GSM8K 提升 14%;到 288 个细粒度领域时,只有顶点采样还能撑住线性拟合,比最好的非线性基线平均高 11%。
这是 arXiv 预印本,未见同行评审,数字以摘要里的实验范围为准。做数据配比、又卡在领域多到回归拟合不动的人,可以看看它那个顶点采样怎么设计。
$BTC