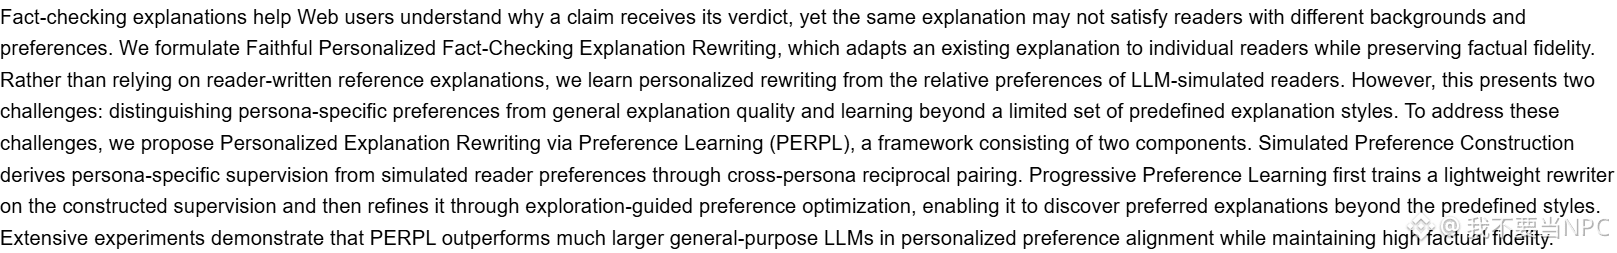
事实核查解释通常只写一遍就推给所有读者,可背景不同的人对同一句解释的接受度不一样。这篇预印本把问题定成“忠实个性化改写”:改写已有解释去贴合单个读者,同时不能动事实结论。
它没让读者自己写参考解释,而是用 LLM 模拟不同读者,从相对偏好里学。难点有两个:把个人偏好和解释的通用质量分开;以及跳出预设的那几种解释风格。方法叫 PERPL,先用跨人格互为对照构造监督信号,训一个轻量改写器,再做探索引导的偏好优化。作者报告的实验中,它在个性化偏好对齐上超过体量更大的通用 LLM,同时保持较高事实忠实度。
arXiv 预印本,未见同行评审,结论以摘要里的实验范围为限。
$BTC
它没让读者自己写参考解释,而是用 LLM 模拟不同读者,从相对偏好里学。难点有两个:把个人偏好和解释的通用质量分开;以及跳出预设的那几种解释风格。方法叫 PERPL,先用跨人格互为对照构造监督信号,训一个轻量改写器,再做探索引导的偏好优化。作者报告的实验中,它在个性化偏好对齐上超过体量更大的通用 LLM,同时保持较高事实忠实度。
arXiv 预印本,未见同行评审,结论以摘要里的实验范围为限。
$BTC