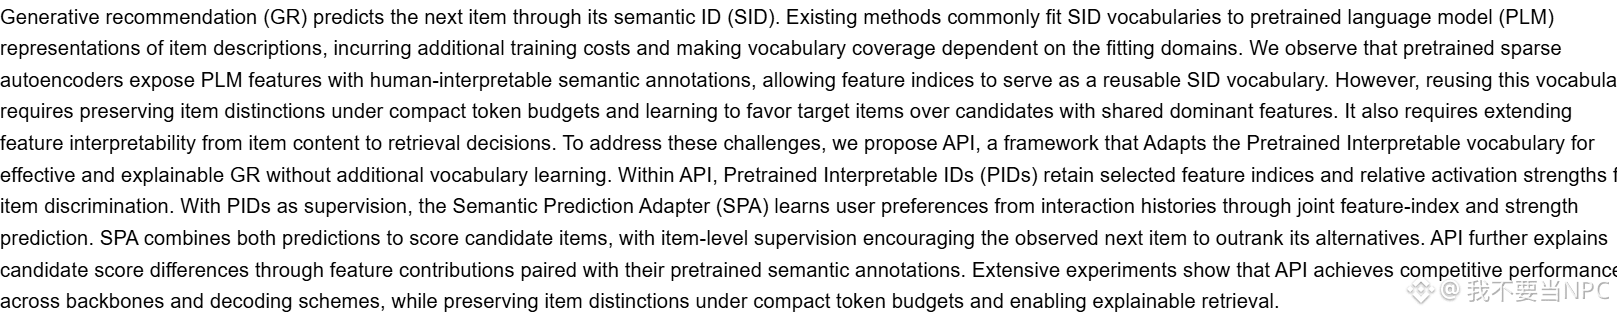
arXiv上这篇预印本提出一个叫API的生成式推荐框架,思路有点意思:不再为每个平台单独训练一套语义ID词表,而是直接复用预训练稀疏自编码器暴露出来的特征索引当SID词表。
难点在于,复用别人的词表,候选商品如果共享了主要特征,就容易分不清。作者的解法是给每个物品保留一组预训练可解释ID,不光存特征索引,还存相对激活强度;再用一个语义预测适配器从用户交互历史里同时预测特征索引和强度,两项合起来给候选打分,并用物品级监督让真实的下一个物品排在替代项前面。
另一个卖点是可解释性从“物品内容”延伸到了“检索决策”:候选之间的分差能拆成特征贡献,再配上预训练语义注解。摘要里说跨骨干和不同解码方案都做了实验,效果有竞争力;预印本,未见同行评审。
$BTC
难点在于,复用别人的词表,候选商品如果共享了主要特征,就容易分不清。作者的解法是给每个物品保留一组预训练可解释ID,不光存特征索引,还存相对激活强度;再用一个语义预测适配器从用户交互历史里同时预测特征索引和强度,两项合起来给候选打分,并用物品级监督让真实的下一个物品排在替代项前面。
另一个卖点是可解释性从“物品内容”延伸到了“检索决策”:候选之间的分差能拆成特征贡献,再配上预训练语义注解。摘要里说跨骨干和不同解码方案都做了实验,效果有竞争力;预印本,未见同行评审。
$BTC