

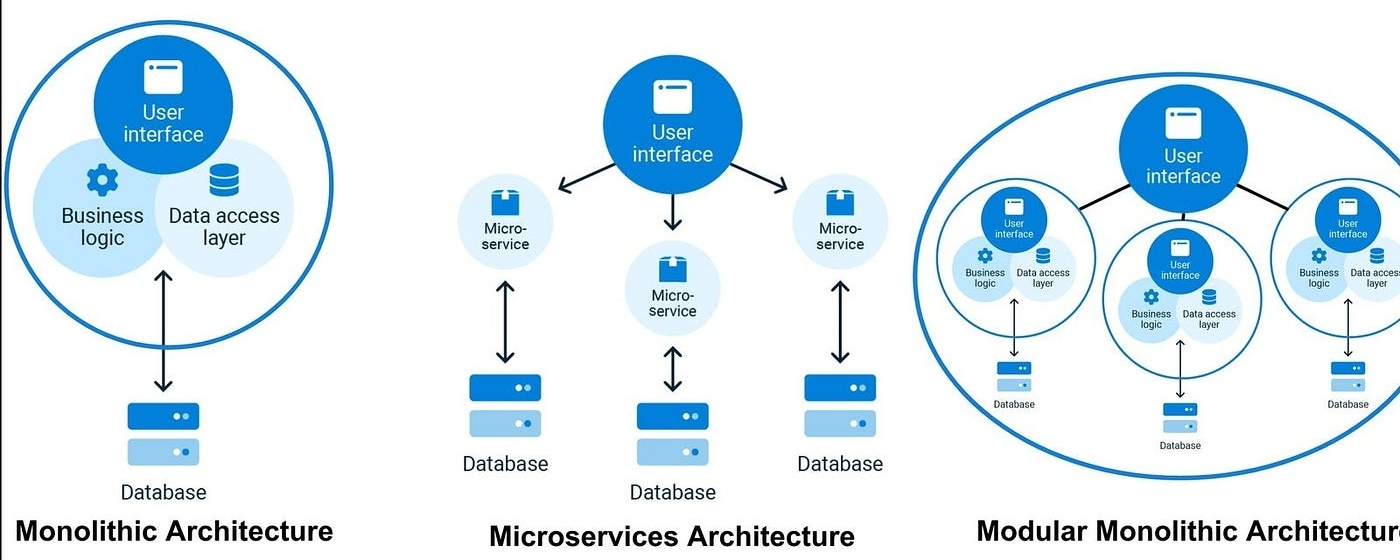
Nillions „Blind Computer“ ist kein einzelner zentralisierter Server, sondern vielmehr ein verteiltes Netzwerk aus Knoten, die jeweils bestimmte „blinde Module“ implementieren. Laut der offiziellen Dokumentation von Nillion ist jeder Knoten für die Funktionalität eines blinden Moduls verantwortlich. Entwickler können mehrere Knoten entsprechend ihrem tatsächlichen Bedarf zu einem „Cluster“ zusammenfassen. Der Kerngedanke dieser Architektur ist, dass der Schutz der Privatsphäre nicht auf dem Vertrauen in einen einzelnen Betreiber beruhen sollte, sondern durch die verteilte Zusammenarbeit der Knoten und kryptografische Mechanismen gewährleistet wird.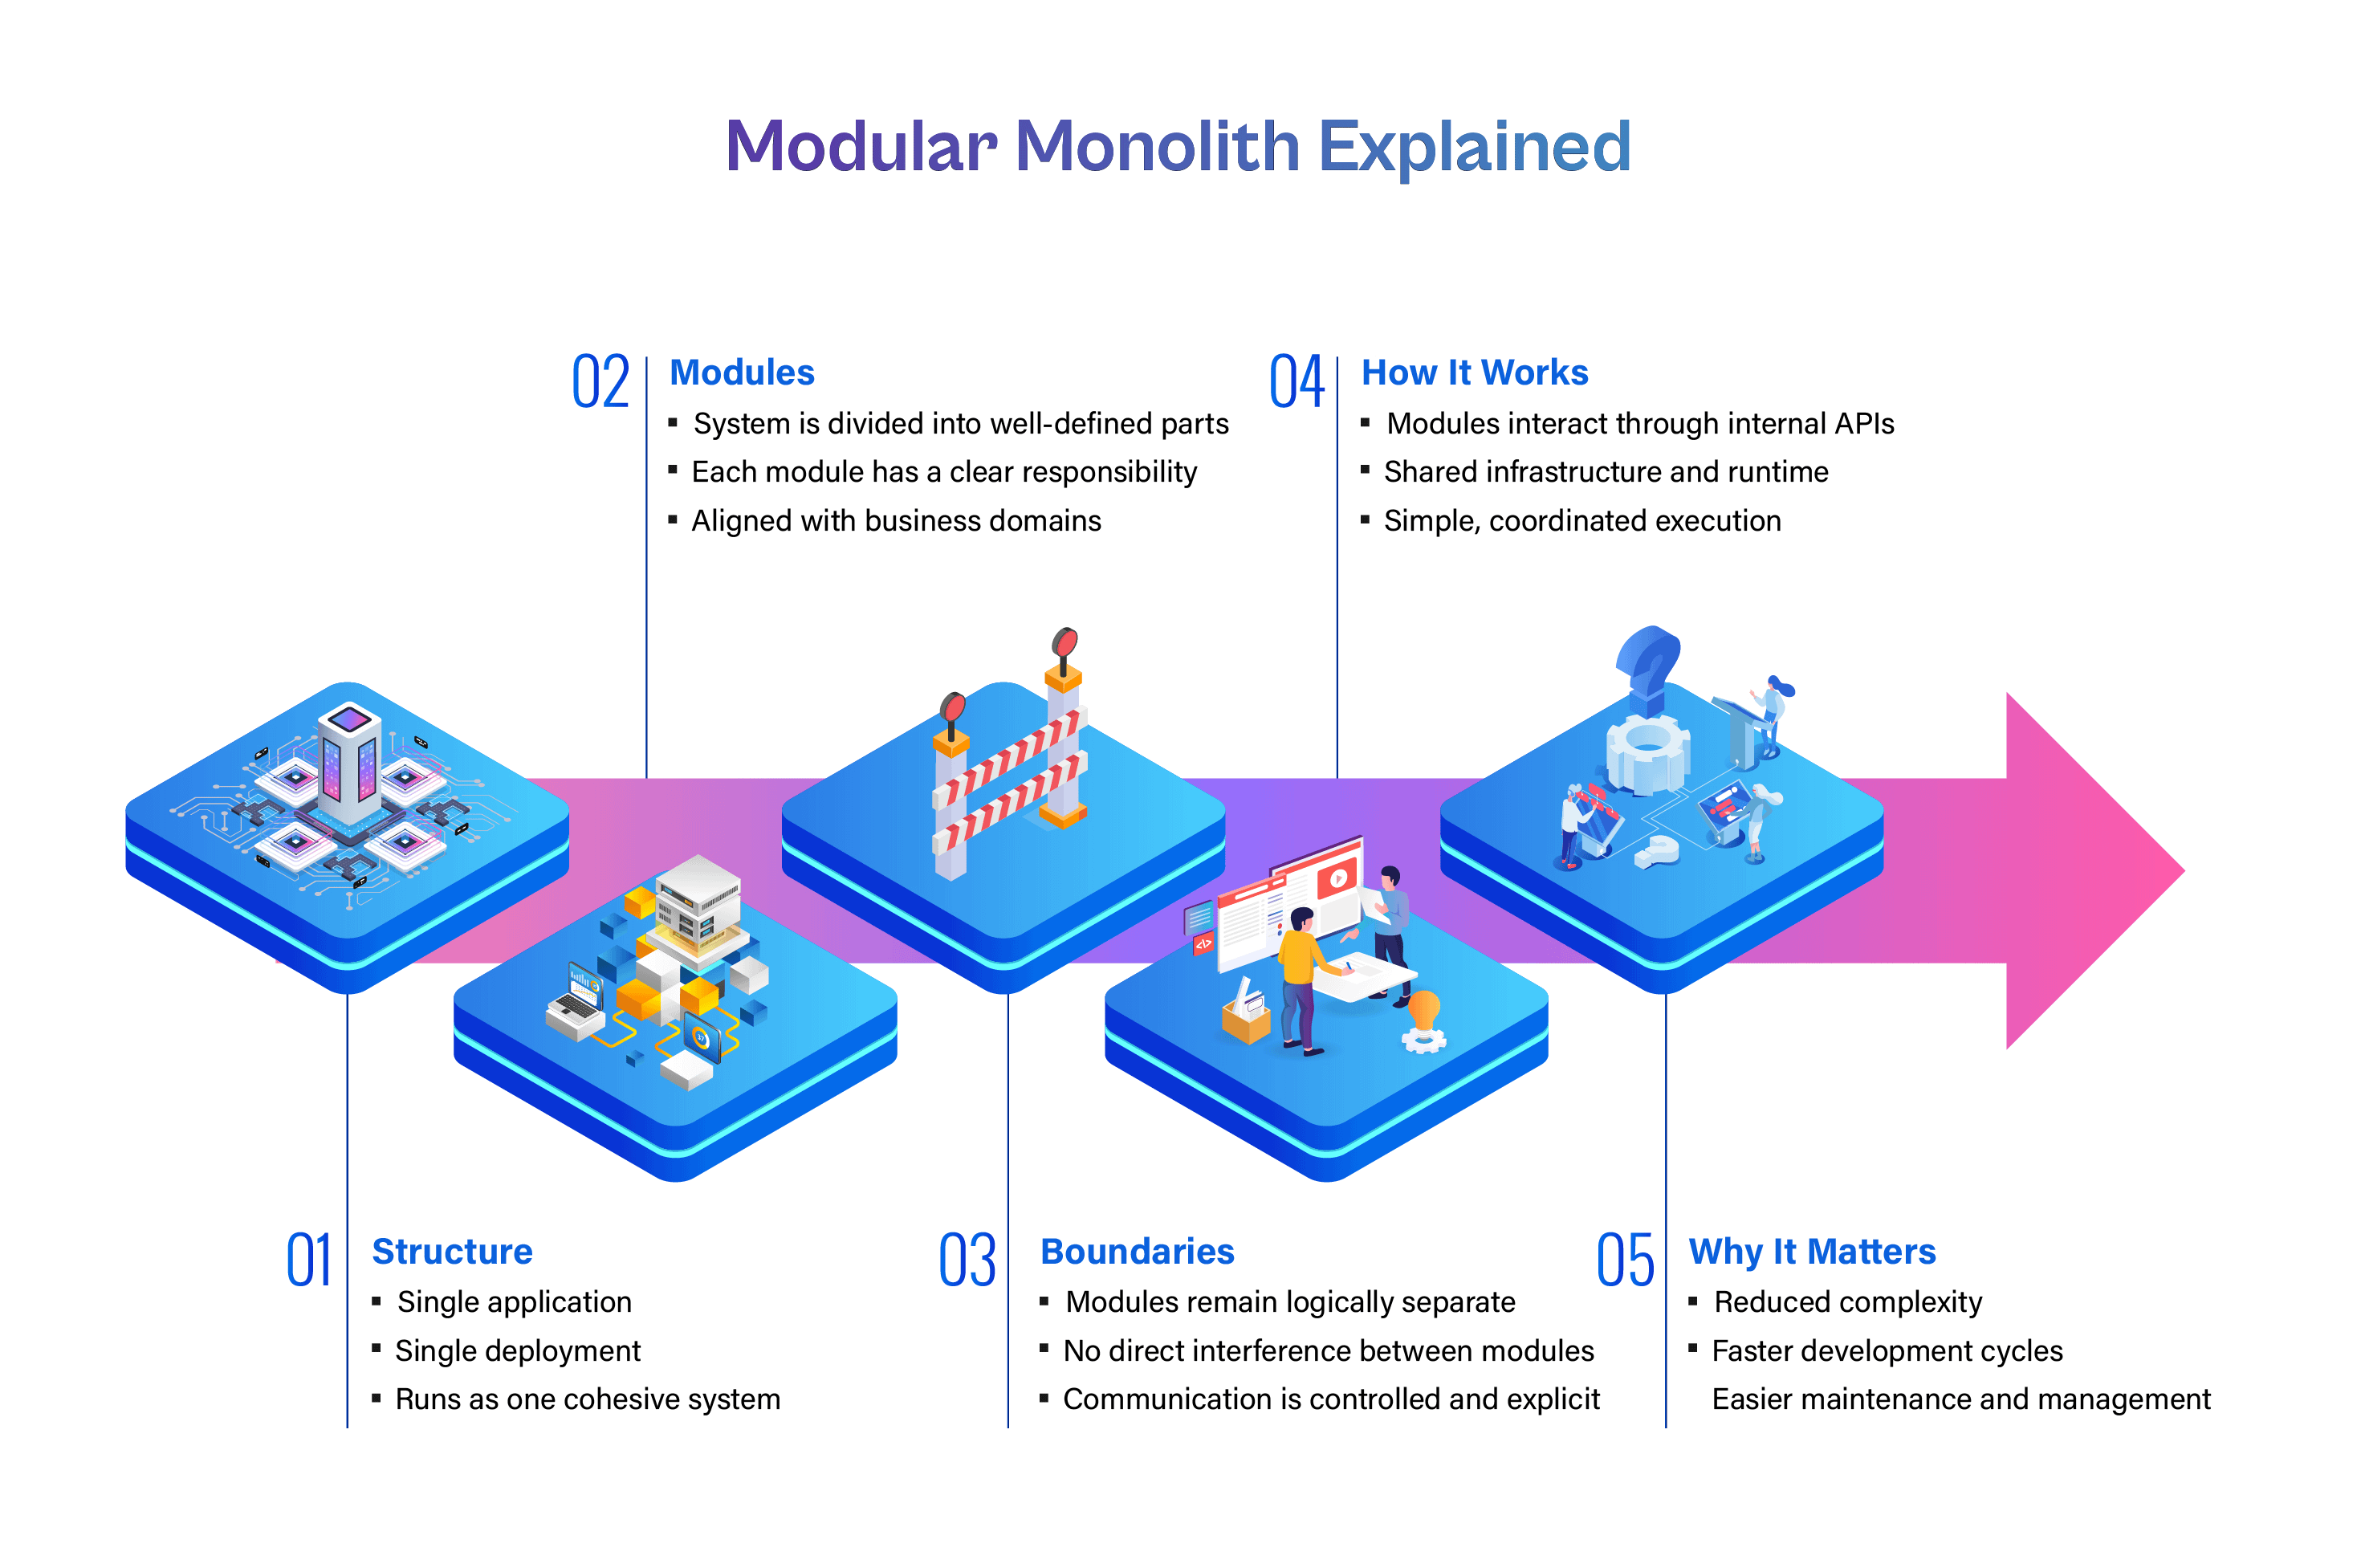
Aus den in der offiziellen Dokumentation veröffentlichten Konfigurationsinformationen geht hervor, dass Entwickler derzeit über drei Hauptschnittstellen auf verschiedene Funktionsebenen des Blind Computers zugreifen können. Die nilCC-API bietet Funktionen für vertrauliche Berechnungen unter der Knotenadresse https://api.nilcc.nillion.network und stellt außerdem eine OpenAPI-Spezifikation bereit, in der Entwickler Einzelheiten zur Schnittstelle nachlesen können. Die nilAI-API läuft innerhalb einer TEE (Trusted Execution Environment) und ist unter https://api.nilai.nillion.network erreichbar. Sie wird für Szenarien mit vertraulicher LLM-Inferenz verwendet. Bei nilDB ist die Situation komplexer: Das System basiert auf einem dezentralen Clustermodell, in dem Entwickler eine oder mehrere nilDB-Knoten verbinden können, um sowohl Klartext- als auch verschlüsselte Daten zu speichern und abzufragen. Die offizielle Dokumentation führt konkrete URLs und öffentliche Schlüssel für mehrere Knoten im Mainnet und Testnet auf, zum Beispiel die Testnet-Knoten nildb-stg-n1 bis n3 sowie Mainnet-Knoten wie nildb-5ab1, nildb-f496, nildb-f375 und nildb-2140. Einige Knoten werden von Institutionen wie Pairpoint, STC Bahrain und Deutsche Telekom MMS betrieben.
Bei der Integration haben Entwickler zwei Möglichkeiten: Sie können das secretvaults-SDK verwenden, um eine Verbindung zu einem Cluster herzustellen, oder direkt über die nilDB-API und die blindfold-Bibliothek mit einzelnen Knoten interagieren. Dank dieser Flexibilität kann eine Anwendung je nach Vertraulichkeit der Daten und Leistungsanforderungen entscheiden, ob sie den Clusterweg mit stärkeren verteilten Vertrauensgarantien oder den Einzelknotenweg mit einfacherer Anbindung wählt. In der offiziellen Dokumentation wird außerdem ausdrücklich darauf hingewiesen, dass Entwickler bei einem Cluster aus mindestens zwei Knoten von der Annahme ausgehen können, dass die Knoten nicht kolludieren. Keinem einzelnen Knoten im Cluster müssen die Identitäten der übrigen Knoten mitgeteilt werden. Dadurch wird das Risiko einer Kollusion zwischen Knotenbetreibern weiter verringert.
Aus einer übergeordneten Perspektive dient dieser Ansatz mit Knoten und Clustern dem allgemeinen Vertrauensmodell von Nillion. Herkömmliche Datenbanken speichern alle Informationen an einem Ort, sodass ein einzelner Sicherheitsvorfall zur vollständigen Kompromittierung führt. Der Blind Computer hingegen verteilt verschlüsselte Daten auf mehrere Knoten, sodass kein einzelner Knoten die vollständigen Daten besitzt. Dadurch verlagert sich die Sicherheitsgrenze von „dem Betreiber vertrauen“ hin zu „der Kryptografie und der Verteilung der Knoten vertrauen“. Laut offizieller Dokumentation nutzt der Blind Computer fortschrittliche kryptografische Verfahren wie Secure Multi-Party Computation (MPC), homomorphe Verschlüsselung (HE) und Trusted Execution Environments (TEEs), um direkt mit verschlüsselten Daten zu arbeiten. So verschiebt sich das Vertrauensmodell von „Vertraut uns eure Daten an“ zu „Vertraut der Kryptografie“. Das ist der grundlegende Grund, weshalb die Konfiguration von Knoten und die Aufteilung in Cluster wichtig sind: Es handelt sich nicht um bloße technische Parameter, sondern um die Infrastruktur, mit der das Vertrauensmodell umgesetzt wird.
Für Entwickler, die mit der Entwicklung beginnen möchten, besteht der erste Schritt meist darin, das zentrale Entwicklerportal aufzurufen, das die Zugriffsverwaltung für nilDB, nilCC und nilAI bündelt. Nach Auswahl des gewünschten Moduls genügt es, gemäß den in der offiziellen Dokumentation aufgeführten Knotenadressen oder API-Endpunkten eine Verbindung herzustellen, um Funktionen für blinde Speicherung oder blinde Berechnungen aufzurufen. Zu beachten ist, dass ein nilDB-Cluster in typischen Konfigurationen mindestens drei Knoten benötigt, um geheime Anteile zu verteilen und sicherzustellen, dass kein einzelner Knoten die Originaldaten einsehen kann. Daher müssen Entwickler die Auswahl der Knoten und die Zusammensetzung des Clusters bereits zu Beginn der Planung berücksichtigen, statt dies als optionale Ergänzung nach der Bereitstellung zu behandeln.