Ich habe gerade den technischen Anwendungsfall von NodeGhost bei @Acurast gelesen und dabei ein ziemlich interessantes Testergebnis entdeckt.
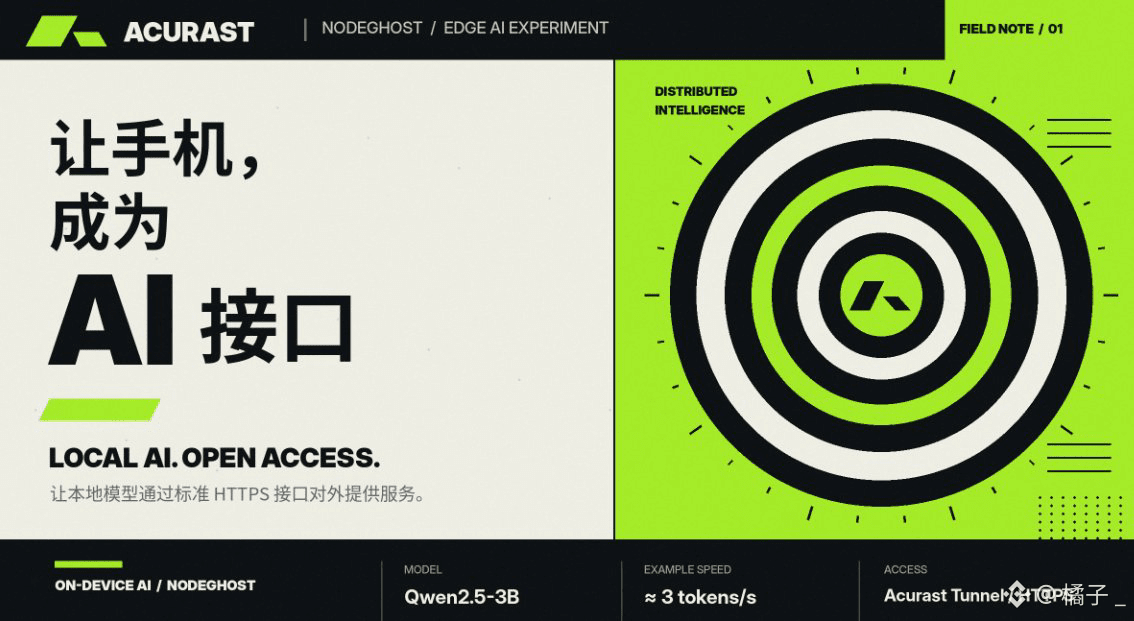
Auf einem Smartphone läuft ein quantisiertes Qwen2.5-3B-Modell, das etwa 3 Token pro Sekunde generiert.
Für eine Frage mit ungefähr 120 Token braucht es rund 45 Sekunden.
Gemessen an der heutigen Nutzung großer Sprachmodelle ist das tatsächlich ziemlich langsam.
Was mich an diesem Anwendungsfall aber besonders interessiert, ist ein anderes Design:
Über den Acurast Tunnel kann ein Modell, das bisher lokal auf dem Smartphone lief und keine öffentliche IP-Adresse hatte, über eine HTTPS-Schnittstelle nach außen erreichbar gemacht werden.
Dank der OpenAI-API-Kompatibilität von NodeGhost müssen Entwickler ihre bisherige Art, API-Aufrufe zu tätigen, kaum ändern. So können sie Anfragen zur Ausführung an ein Smartphone senden.
Damit ist das Smartphone nicht länger nur ein Processor im Netzwerk, der passiv auf zugewiesene Aufgaben wartet, sondern kann auch standardisierte KI-Inferenzdienste anbieten.
Natürlich handelt es sich bei diesem Anwendungsfall derzeit noch um eine Referenzimplementierung im Canary-Netzwerk. Geschwindigkeit und die Fähigkeit, komplexe Schlussfolgerungen zu ziehen, sind deutlich eingeschränkt.
Trotzdem finde ich, dass damit bereits eine sehr praktische Frage beantwortet wird:
Können Entwickler ihre bestehenden Anwendungen problemlos nutzen, um Modelle aufzurufen, die auf verteilten Smartphones bereitgestellt werden?
Zumindest gibt es für diesen technischen Ansatz bereits ein funktionierendes Beispiel.
Bis zur Kommerzialisierung müssen allerdings noch Latenz, Parallelverarbeitung, Kosten und langfristige Stabilität weiter überprüft werden.
Acurasts $ACU dient dazu, die Netzwerknutzung mit Rechenleistungsanreizen zu verbinden. Ob sich damit letztlich zahlungsbereite Nutzer gewinnen lassen, hängt jedoch davon ab, ob diese Anwendungen in der Praxis konkurrenzfähig sind.
Auf einem Smartphone läuft ein quantisiertes Qwen2.5-3B-Modell, das etwa 3 Token pro Sekunde generiert.
Für eine Frage mit ungefähr 120 Token braucht es rund 45 Sekunden.
Gemessen an der heutigen Nutzung großer Sprachmodelle ist das tatsächlich ziemlich langsam.
Was mich an diesem Anwendungsfall aber besonders interessiert, ist ein anderes Design:
Über den Acurast Tunnel kann ein Modell, das bisher lokal auf dem Smartphone lief und keine öffentliche IP-Adresse hatte, über eine HTTPS-Schnittstelle nach außen erreichbar gemacht werden.
Dank der OpenAI-API-Kompatibilität von NodeGhost müssen Entwickler ihre bisherige Art, API-Aufrufe zu tätigen, kaum ändern. So können sie Anfragen zur Ausführung an ein Smartphone senden.
Damit ist das Smartphone nicht länger nur ein Processor im Netzwerk, der passiv auf zugewiesene Aufgaben wartet, sondern kann auch standardisierte KI-Inferenzdienste anbieten.
Natürlich handelt es sich bei diesem Anwendungsfall derzeit noch um eine Referenzimplementierung im Canary-Netzwerk. Geschwindigkeit und die Fähigkeit, komplexe Schlussfolgerungen zu ziehen, sind deutlich eingeschränkt.
Trotzdem finde ich, dass damit bereits eine sehr praktische Frage beantwortet wird:
Können Entwickler ihre bestehenden Anwendungen problemlos nutzen, um Modelle aufzurufen, die auf verteilten Smartphones bereitgestellt werden?
Zumindest gibt es für diesen technischen Ansatz bereits ein funktionierendes Beispiel.
Bis zur Kommerzialisierung müssen allerdings noch Latenz, Parallelverarbeitung, Kosten und langfristige Stabilität weiter überprüft werden.
Acurasts $ACU dient dazu, die Netzwerknutzung mit Rechenleistungsanreizen zu verbinden. Ob sich damit letztlich zahlungsbereite Nutzer gewinnen lassen, hängt jedoch davon ab, ob diese Anwendungen in der Praxis konkurrenzfähig sind.