Nillion: Daten nutzbar machen, ohne die Privatsphäre zu gefährden
Ich habe mich in letzter Zeit mit Nillion beschäftigt, und der Ansatz der blinden Berechnung ist eine der interessantesten Ideen, die mir im Bereich Datenschutz begegnet sind.
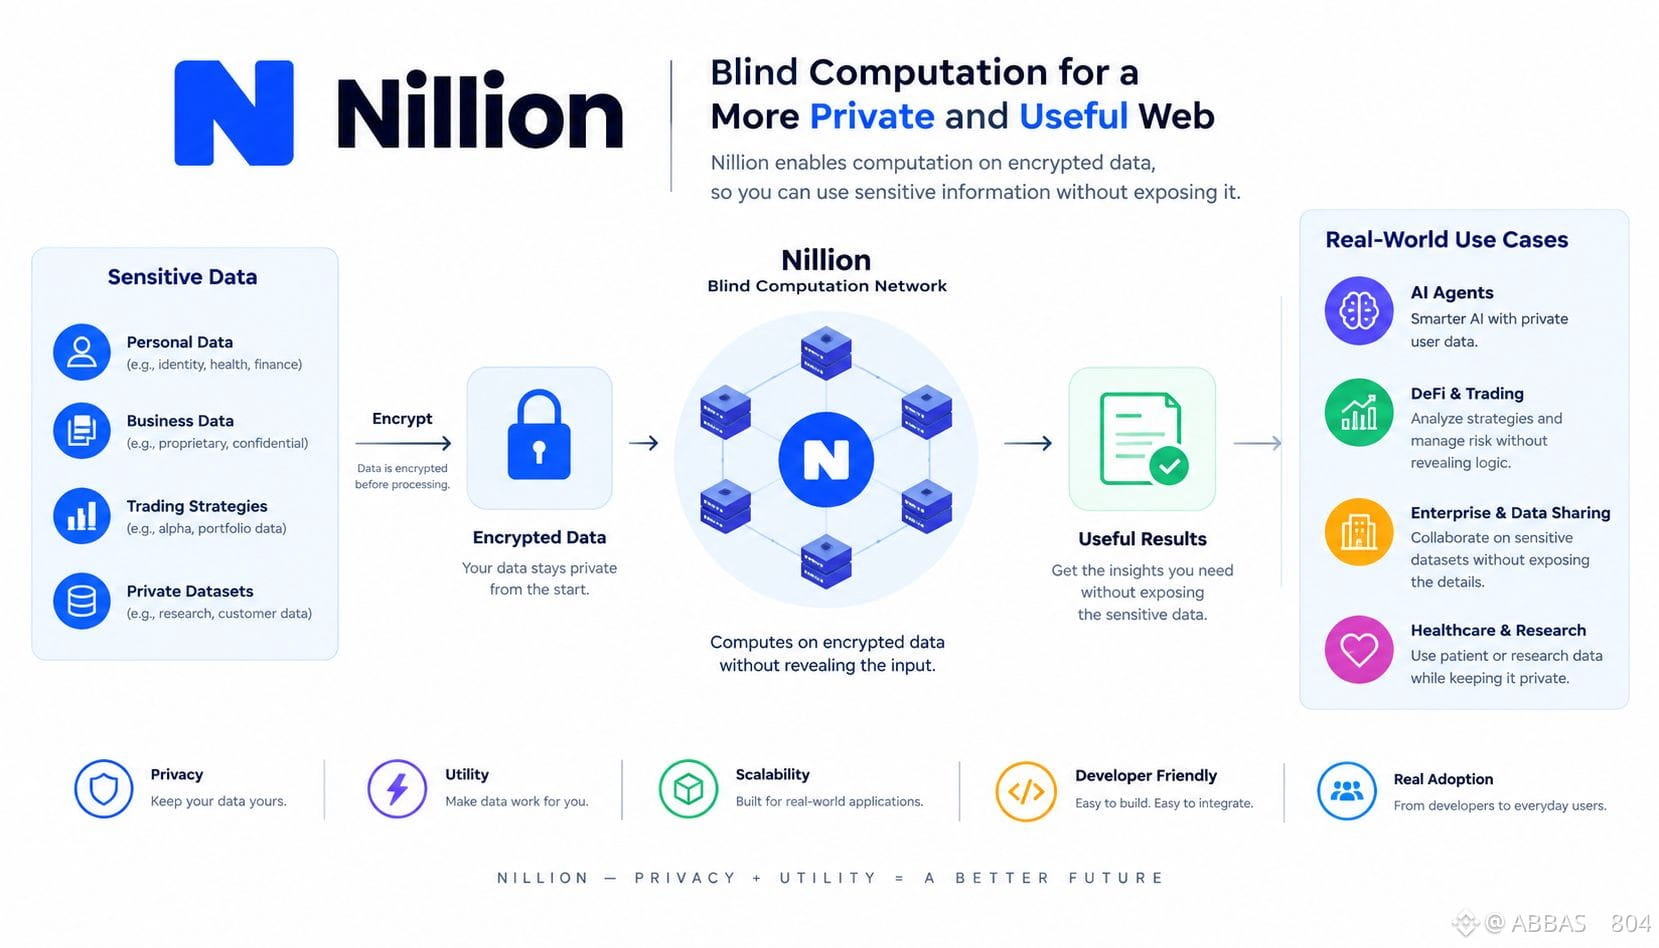
Das Grundkonzept ist überzeugend: Was wäre, wenn Anwendungen sensible Informationen verarbeiten könnten, ohne die zugrunde liegenden Daten unnötig offenzulegen? Anstatt Nutzer vor die Wahl zwischen Datenschutz und Nutzen zu stellen, möchte Nillion beides ermöglichen.
Stell dir vor, KI-Agenten greifen auf persönliche Daten zu, um bessere Ergebnisse zu liefern, ohne private Details preiszugeben. Oder denk an Handelssysteme, die vertrauliche Strategien analysieren, ohne ihre Logik offenzulegen, und an Unternehmen, die gemeinsam sensible Datensätze nutzen und dabei wertvolle Informationen schützen.
Dabei handelt es sich nicht nur um theoretische Fragen. Mit dem weiteren Wachstum von KI, dezentraler Finanzwirtschaft und datengetriebenen Anwendungen wird es immer wichtiger, Informationen zu schützen und zugleich nutzbar zu halten.
Die Technologie selbst ist jedoch nur ein Teil der Geschichte. Eine breite Akzeptanz wird von der Sicherheit, der Rechenleistung, der Entwicklerfreundlichkeit und davon abhängen, wie einfach Teams Nillion in bestehende Anwendungen integrieren können.
Besonders interessiert mich, welche Projekte auf dem Netzwerk aufbauen, welche Probleme sie lösen und ob Nutzer wiederkommen, weil die Technologie einen echten Mehrwert bietet.
Für mich ist die entscheidende Frage nicht einfach, ob blinde Berechnung funktioniert, sondern ob sie zu einer praxistauglichen Infrastruktur für Anwendungen werden kann, die täglich sensible Daten verarbeiten.
Wo wird Nillion deiner Meinung nach die größte Wirkung entfalten: bei KI-Agenten, DeFi oder beim datenschutzfreundlichen Austausch von Daten?
#nil $NIL @Nillion