

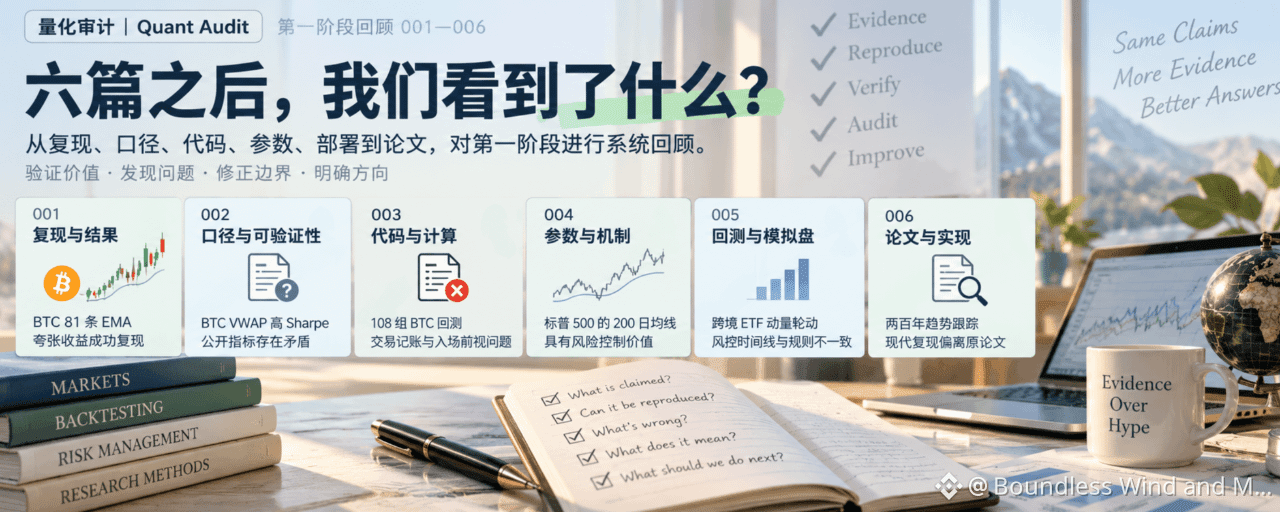

Von der ersten bis zur sechsten Folge hat „Quantitatives Audit“ ein deutlich breiteres Forschungsfeld abgedeckt, als wir ursprünglich erwartet hatten.
Ausgangspunkt war eine Bitcoin-Strategie mit gleitenden Durchschnitten, die sich in den sozialen Medien verbreitete. Die Behauptung, alle 81 EMAs hätten Bitcoin geschlagen, war aufmerksamkeitsstark genug, um Interesse zu wecken – und fragwürdig genug, um Skepsis hervorzurufen. Danach stießen wir nach und nach auf VWAP-Strategien mit hohen Sharpe-Ratios, Open-Source-Backtesting-Projekte, klassische gleitende Durchschnitte für den S&P 500, grenzüberschreitende ETF-Momentum-Rotationen und eine Trendfolgestudie, die angeblich zwei Jahrhunderte umspannt.
Die untersuchten Themen änderten sich stetig, und auch die Fragen, die uns beschäftigten, wurden nach und nach tiefgreifender.
Anfangs wollten wir wissen, ob sich eine eindrucksvolle Renditekurve reproduzieren lässt. Später prüften wir die Definitionen der Kennzahlen, die Handelsbuchhaltung, den Ausführungszeitpunkt und die Strategieversion. Im sechsten Beitrag verglichen wir schließlich unmittelbar eine wissenschaftliche Studie mit einer modernen Codeimplementierung.
Nach sechs Beiträgen hat die Reihe ein recht klares Profil gewonnen: Sie untersucht, ob die Belege für quantitative Behauptungen ausreichen und in welchem Umfang die veröffentlichten Schlussfolgerungen tatsächlich Bestand haben.
Dieser Rückblick fasst vor allem die Erkenntnisse, Erfahrungen und Fragen aus der ersten Phase zusammen.
Erstens: Sechs Beiträge, sechs verschiedene Auditfragen
001: Außergewöhnlich hohe Renditen sind nicht zwangsläufig falsch
Im ersten Beitrag auditierten wir die Bitcoin-Strategie mit 81 EMAs.
Die Originalautoren behaupten, dass im angegebenen historischen Zeitraum alle 81 Strategien mit gleitenden Durchschnitten unterschiedlicher Perioden Buy-and-Hold in Bitcoin übertrafen.
Ein solches Ergebnis lässt zunächst leicht Zweifel an den Daten oder der Backtestmethode aufkommen. Nachdem wir den Test jedoch unter den Bedingungen der Originalautoren rekonstruiert hatten, konnten wir bestätigen, dass sich dieses historische Ergebnis reproduzieren lässt.
Mit einer weiteren Änderung des Beobachtungszeitraums änderte sich auch die Schlussfolgerung. Dass alle 81 gleitenden Durchschnitte besser abschnitten, hing deutlich vom ursprünglichen Testzeitraum ab. In einigen jüngeren historischen Zeitfenstern schnitt Buy-and-Hold sogar besser ab.
Damit entstand das erste wichtige Bewertungskriterium für die Reihe: Übertriebene Zahlen können echt sein, doch daraus folgt nicht, dass alle darauf aufbauenden Erklärungen ebenfalls zutreffen.
001 reproduzierte die historischen Ergebnisse erfolgreich und legte zugleich deren Geltungsbereich klar fest.
002: Aussagekräftige Kennzahlen müssen nachvollziehbar sein
Im zweiten Beitrag wandten wir uns der BTC-VWAP-Reversionsstrategie zu.
Die zugehörigen Materialien wiesen eine hohe Sharpe Ratio und annualisierte Rendite sowie einen sehr geringen maximalen Drawdown aus. Auf den ersten Blick ergab sich daraus ein attraktives Backtestergebnis.
Beim Vergleich von Materialien aus unterschiedlichen Veröffentlichungszeitpunkten stellten wir jedoch deutliche Veränderungen der Kennzahlen fest. Zugleich fehlten in den öffentlichen Unterlagen klare Angaben zu Parametern, Testzeiträumen und Versionshistorie. Zwischen einigen statistischen Feldern bestanden außerdem schwer erklärbare logische Widersprüche.
Diese Probleme beweisen nicht, dass der ursprüngliche Backtest zwangsläufig falsch war. Sie reichen jedoch aus, um externe Leser an einer unabhängigen Überprüfung zu hindern.
002 fällte daher kein Urteil darüber, ob die Strategie wahr oder falsch ist, sondern blieb bei dem, was die Belege stützen: Mit den derzeit verfügbaren öffentlichen Informationen lässt sich diese Backtest-Performance nicht verifizieren.
Solche Probleme sind bei quantitativen Inhalten weit verbreitet. Leser können zwar das Ergebnis sehen, aber nicht nachvollziehen, wie es zustande kam.
003: Öffentlicher Code muss keine Überprüfung der ausgewiesenen Performance ermöglichen
Im dritten Beitrag gingen wir der konkreten Umsetzung der Strategie auf den Grund.
Ein Open-Source-Projekt für Backtests zur BTC-Trendfolge veröffentlichte zahlreiche Parameterkombinationen, Handelsaufzeichnungen und Performance-Statistiken. Die ausgewiesenen Rendite- und Risikokennzahlen waren ausgesprochen beeindruckend.
Bei der Codeprüfung stießen wir zunächst auf Probleme bei der Buchung von Teilausstiegen und der Berechnung der Performance. Eine spätere Gegenprüfung bestätigte zudem, dass das Programm anhand des Schlusskurses des ersten Vier-Stunden-Kerzencharts des Folgetages entschied, ob ein Einstieg möglich war, den Handel aber zum Eröffnungskurs derselben Kerze ausführte. Das war ein eindeutiger Look-ahead-Bias.
Auch die Rückerstattung der Margin nach Teilausstiegen sowie die Zusammenfassung des endgültigen Gewinns und Verlusts aus den Transaktionen weisen Implementierungsfehler auf, die sich auf die Kontoberechnung oder Handelsstatistik auswirken.
Diese Erkenntnisse erschüttern unmittelbar die Glaubwürdigkeit der ursprünglichen Leistungskennzahlen. Wir haben jedoch noch keinen vollständigen erneuten Durchlauf mit korrigiertem Code durchgeführt und können daher weder die konkrete Richtung noch das Ausmaß der Auswirkungen der einzelnen Fehler auf die endgültige Rendite bestätigen.
003 hat uns gezeigt, dass die Veröffentlichung des Codes nur der Ausgangspunkt einer Überprüfung ist. Handelszeitpunkte, Kontobuchungen und statistische Kennzahlen müssen miteinander vereinbar sein.
Damit war dieser Beitrag auch der erste, für den wir weiterhin technische Korrekturen dokumentieren mussten.
004: Der Wert einer klassischen Strategie ist möglicherweise weniger spektakulär als ihr Ruf
Der vierte Beitrag untersuchte den 200-Tage-Durchschnitt des S&P 500.
Diese klassische Regel ist seit Langem Teil der Investmentdebatte. Die Auseinandersetzung darüber ist nicht neu: Können gleitende Durchschnitte tatsächlich Überrenditen erzielen oder bieten sie lediglich eine Form der Risikokontrolle?
Das Ergebnis des unabhängigen Tests war recht eindeutig.
Im untersuchten historischen Zeitraum verzichtete die Strategie mit dem 200-Tage-Durchschnitt auf einen Teil der Renditen im Bullenmarkt, verringerte dafür aber die starken Drawdowns. Beim Vergleich mit gleitenden Durchschnitten benachbarter Perioden zeigte sich zudem kein eindeutiger, stabiler Sondervorteil des exakten 200-Tage-Parameters.
Wir erkennen daher den Wert der Strategie für die Risikokontrolle innerhalb der historischen Stichprobe an, behalten aber unsere Zweifel an der Besonderheit der Parameter und der künftigen Wirksamkeit bei.
Der Beitrag von 004 besteht darin, die praktische Wirkung einer klassischen Strategie von der über lange Zeit entstandenen Erzählung darüber zu trennen.
Eine Strategie kann nützlich sein, auch wenn sie nicht alle Funktionen erfüllt, die ihr zugeschrieben werden.
005: Backtest und Paper-Trading verwenden möglicherweise nicht mehr dieselbe Strategie
Der fünfte Beitrag untersuchte eine Momentum-Rotation zwischen ETFs verschiedener Länder.
Das ursprüngliche Projekt wies eine beachtliche kumulierte Rendite und Sharpe Ratio aus. Die Codeprüfung zeigte, dass das Risikomanagement des Backtests anhand des Tageshochs, des Tagestiefs und der Schlusskursdaten desselben Tages über das Risiko entschied, den Verkauf jedoch zum Eröffnungskurs desselben Tages ausführte. Die zeitliche Reihenfolge war damit fehlerhaft.
Dann folgte jedoch ein kontraintuitives Ergebnis.
In explorativen Experimenten mit unabhängigen Marktdaten und einer unabhängigen Implementierung verbesserte sich die Strategie sogar, nachdem die Ausführung des Risikomanagements in eine kausal korrekte zeitliche Reihenfolge gebracht worden war.
Dieses Ergebnis erinnert uns daran, dass die Entdeckung von Look-ahead-Bias nicht automatisch bedeutet, dass dadurch die Rendite gestiegen ist.
Das Experiment verwendete jedoch weder den vollständigen Datensatz noch die Ausführungsumgebung der Originalautoren und glich auch die einzelnen Transaktionen nicht ab. Es zeigt daher lediglich, dass eine solche Verbesserung möglich ist. Als genaue Reproduktion der Performance des korrigierten Originalprojekts kann es nicht gelten.
Eine weitere Prüfung ergab, dass sich Modus B des Backtests und Modus B des Paper-Tradings bei den Stop-Loss-Regeln, den Auslösebedingungen und der Anpassung der Positionen unterschieden.
Das war die klarere Erkenntnis aus dem fünften Beitrag: Die durch den historischen Backtest bestätigte Strategie unterscheidet sich wesentlich von der Strategie, die derzeit im Paper-Trading läuft.
Selbst wenn beide denselben Namen tragen, lässt sich die historische Sharpe Ratio nicht ohne Weiteres als validierte Performance der aktuell eingesetzten Version betrachten.
006: Bei der Reproduktion einer Studie muss man ihr treu bleiben
Der sechste Beitrag befasste sich mit einer noch grundlegenderen Studie: (Two Centuries of Trend Following).
Die Studie untersucht den Trendfolgeeffekt anhand langfristiger historischer Daten. Eine moderne Implementierung von Warenterminkontrakten auf QuantConnect weist dagegen eine negative Sharpe Ratio aus und erörtert auf dieser Grundlage, ob der Informationsgehalt von Trends nachlassen könnte.
Auf den ersten Blick stehen sich die beiden Ergebnisse deutlich gegenüber.
Bei der Prüfung des öffentlichen Codes stellten wir jedoch fest, dass die moderne Implementierung die zentrale Volatilitätsdefinition und die Positionsformel der Originalstudie wesentlich verändert hatte.
Die Studie misst das Risiko anhand eines exponentiell gleitenden Durchschnitts der monatlichen absoluten Preisänderungen. Die öffentliche Implementierung glättet dagegen die vorzeichenbehafteten Preisänderungen. Auch der Positionsausdruck weicht von der Originalstudie ab.
Damit muss die Aussagekraft der negativen Sharpe Ratio neu eingegrenzt werden.
Sie kann die historische Performance dieser konkreten Implementierung widerspiegeln, reicht aber nicht aus, um unmittelbar zu belegen, dass die in der Originalstudie untersuchte Trendfolgestrategie gescheitert ist.
006 ergänzte die erste Phase um eine wichtige Auditdimension: Gleiche Forschungsbezeichnungen, Literaturverweise und Codekommentare garantieren nicht, dass tatsächlich dasselbe Modell ausgeführt wird.
Zweitens: Welche Erkenntnisse haben wir nach sechs Beiträgen gewonnen?
Der Rückblick auf diese Fälle lässt mehrere zunehmend gefestigte Erkenntnisse erkennen.
Erstens: Ein Audit muss die Ergebnisse offenlassen
001 reproduzierte die außergewöhnlich hohen Renditen erfolgreich, 004 räumte den historischen Wert der Risikokontrolle durch eine klassische gleitende Durchschnittsstrategie ein, und die explorativen Experimente in 005 zeigten, dass die Korrektur von Codefehlern die Performance nicht zwangsläufig verschlechtert.
Wer von vornherein alle hohen Renditen für verdächtig hält oder das Aufdecken eines Fehlers zum einzigen Erfolgsmaßstab eines Artikels macht, übersieht solche Ergebnisse leicht.
Forschung braucht die Fähigkeit zur Kritik, aber auch die Bereitschaft, Belege für die Gegenseite anzuerkennen.
Eine Strategie kann wirksam, teilweise wirksam oder anhand der verfügbaren Materialien schlicht nicht beurteilbar sein. Wir müssen solche Ergebnisse zulassen, wenn sie sich ergeben.
Zweitens: Reproduktionen beruhen auf unterschiedlichen Belegebenen
Manche Schlussfolgerungen aus den sechs Beiträgen beruhen auf Berechnungen mit unabhängigen historischen Daten, andere auf einer direkten Codeprüfung. Bei manchen blieb nur die Einschätzung, ob sich die öffentlichen Materialien überhaupt überprüfen ließen.
Diese Belege können einander nicht ersetzen.
Wenn Autoren Gewinne ausweisen, bedeutet das nicht, dass wir diese Gewinne bereits reproduziert haben. Ein fehlerhafter Quellcode erlaubt keine automatische Ableitung der korrigierten Rendite. Und ein Kontrollversuch mit unabhängigen Daten kann die vollständigen Handelsaufzeichnungen des ursprünglichen Projekts nicht unmittelbar ersetzen.
Ein wichtiger Gewinn der ersten Phase war, dass wir nach und nach gelernt haben, diese Grenzen klar zu benennen.
Eine Schlussfolgerung sollte nur so weit reichen, wie die Belege sie tragen.
Schließlich erstreckte sich das Audit auch auf die vollständige Beweiskette der Strategie
Anfangs prüften wir hauptsächlich die Renditeergebnisse. In den späteren Beiträgen umfassten die Audits dann auch Formeln, Code, Kontoberechnungen, Risikomanagement und die Ausführung im Paper-Trading.
Das zeigt, dass sich die Vertrauenswürdigkeit einer quantitativen Strategie nicht anhand einer einzelnen Renditekurve bestimmen lässt.
Von der Beschreibung der Autoren über die Strategieregeln und die Rohdaten bis hin zum Backtestcode, den konkreten Transaktionen und der Performance-Statistik: Probleme in jedem entscheidenden Glied können die Schlussfolgerung schwächen.
Selbst wenn eine historische Strategie diese Prüfungen besteht, muss ihre Performance außerhalb der Stichprobe sowie ihre praktische Umsetzung weiter überprüft werden.
Das ist eine Richtung, in der künftige Audits weiter in die Tiefe gehen können. Es ist jedoch nicht nötig, dass jeder einzelne Beitrag die vollständige Überprüfung übernimmt.
Drittens: In der ersten Phase haben wir auch eigene Schwächen entdeckt
Bei diesem Rückblick überprüften wir nicht nur die auditierten Projekte, sondern auch unsere eigenen Artikel.
Am deutlichsten zeigt sich das bei 003.
Beim ersten Audit fanden wir bereits Probleme in der Handelsbuchhaltung. Später bestätigte sich jedoch ein noch direkterer Look-ahead-Bias beim Einstieg. Das zeigt, dass auch ein abgeschlossener Artikel nicht bedeutet, dass frühere Einschätzungen für immer festgeschrieben sind. Wenn neue Belege die bisherige Analyse wesentlich verändern, müssen wir sie erneut prüfen.
005 legte dagegen Schwächen in der Darstellung des Experiments offen.
Kontrollversuche mit unabhängigen Daten sind aussagekräftig, unterscheiden sich jedoch eindeutig von einer präzisen Reproduktion des Originalprojekts. Der Artikel kann die überraschende Erkenntnis beibehalten, dass sich die Performance nach der Korrektur sogar verbesserte. Zugleich muss er aber die Einschränkungen bei Daten und Implementierung offenlegen, damit Leser nicht fälschlich annehmen, das Originalprojekt sei vollständig korrigiert und überprüft worden.
Ähnliche Probleme gab es auch bei der visuellen Gestaltung. Auf einigen früheren Titelbildern waren Instrumente abgebildet, die nicht zur Strategie passten, oder Formeln falsch dargestellt. Obwohl dies bei der Bildgestaltung entstand, konnte es bei Lesern falsche Vorstellungen hervorrufen.
Nach dem Rückblick auf die erste Phase bezogen wir daher Titelbild, Überschrift, Zusammenfassung und Diagramme in die Faktenprüfung vor der Veröffentlichung ein.
Diese Änderungen verändern zwar nicht das ursprüngliche Ziel der Reihe, machen die Anforderungen an die Forschung jedoch klarer.
Wer andere auditiert, muss auch zulassen, dass die eigenen Schlussfolgerungen überprüft werden.
Viertens: Welche Grundsätze sollten wir beibehalten?
Nach sechs Beiträgen liegt der Gedanke nahe, einen detaillierteren Plan aufzustellen: Themen im Voraus festzulegen, eine Veröffentlichungsfrequenz vorzugeben und eine feste Artikelstruktur zu entwerfen, damit die ganze Reihe einheitlicher wirkt.
Wir sind jedoch der Ansicht, dass ein solches Vorgehen erhebliche Risiken birgt.
Der inhaltliche Wert der Beiträge 001 bis 006 liegt gerade in den konkreten Fragen, auf die wir im Verlauf der Untersuchung stießen. Manche Materialien eignen sich für eine Reproduktion, bei anderen müssen lediglich die Definitionen der Kennzahlen überprüft werden. Wieder andere erfordern eine eingehende Codeanalyse, während sich eine ausreichend verlässliche Einschätzung allein durch den Abgleich mit den Formeln der Studie gewinnen lässt.
Wenn jeder Beitrag dieselben Tests durchführen und gleich viele Kennzahlen zeigen muss, gefolgt von einer festgelegten Wendung und einem vorgegebenen Fazit, droht die Forschung zu einer formelhaften Wiederholung zu werden.
Nach der ersten Phase beschlossen wir daher, ein relativ stabiles Regelwerk beizubehalten und zugleich die Themenwahl offen zu halten.
Ob ein Thema aufgegriffen wird, hängt davon ab, wie aussagekräftig die konkrete Behauptung ist. Wenn sich eine überprüfungswürdige Frage ergibt, legen wir los. Fehlen ausreichende Belege oder ist der zusätzliche Erkenntniswert weiterer Untersuchungen zu gering, legen wir eine Pause ein.
Auch die Analysetiefe richtet sich nach der jeweiligen Frage. Lässt sich etwas präzise reproduzieren, tun wir das. Reichen die öffentlichen Informationen nicht aus, kann ein Audit der Überprüfbarkeit sinnvoll sein. Belegt der Code einen Implementierungsfehler bereits hinreichend, müssen nicht allein um des Umfangs willen zusätzliche umfangreiche Tests durchgeführt werden.
Die Artikelstruktur entwickelte sich auf natürliche Weise aus dem Forschungsprozess. Es wurde nicht vorgegeben, wie viele Belege, Risiken oder Abschnitte mit Erläuterungen enthalten sein müssen.
Die daraus abgeleiteten Grundsätze lassen sich wie folgt zusammenfassen:
Feste Forschungsstandards, offene Themenwahl; Qualitätsansprüche, aber keine Mengenziele.
Genau das ist auch der Kern, den wir in den (Arbeitsrichtlinien für Quant-Audits v1.0) bewahren wollen.
Fünftens: Wie geht es in der nächsten Phase weiter?
Die erste Phase hat gezeigt, dass „Quant-Audits“ verschiedene Vermögensmärkte und Forschungsgegenstände abdecken und dabei Inhalte mit eigenständigem Urteilswert hervorbringen können.
Kryptoanlagen, Aktien-ETFs, länderübergreifende Rotation, Warenterminkontrakte, Open-Source-Code und wissenschaftliche Studien können Gegenstand eines Audits sein.
Das bedeutet jedoch nicht, dass diese Bereiche künftig abwechselnd behandelt werden müssen.
Wir müssen weder die Themen für 007, 008 oder noch spätere Beiträge im Voraus festlegen, noch verlangen, dass der nächste Beitrag komplexer oder spektakulärer wird als der vorherige.
Es lohnt sich vor allem, Materialien weiter zu untersuchen, die eine klare Behauptung aufstellen, überprüfbare Belege enthalten und durch ein Audit die Einschätzung der Leser verändern könnten.
Wenn das Audit die Zuverlässigkeit einer Strategie belegt, sollten wir das anerkennen. Zeigt es eine nicht zu schließende Beweislücke auf, sollten wir ehrlich festhalten, dass sich die Untersuchung an diesem Punkt nicht fortsetzen lässt.
Auch in künftigen Untersuchungen werden wir auf Fehler und Schlussfolgerungen stoßen, die überarbeitet werden müssen. Nur wenn wir Aktualisierungen zulassen, kann die Reihe langfristig glaubwürdig bleiben.
Zum Schluss
Nach sechs Artikeln verstehen wir unter „Quant-Audit“ bereits deutlich mehr als zu Beginn.
In der quantitativen Welt mangelt es weder an eindrucksvollen Backtest-Kurven noch an scheinbar rigorosen Formeln, Parametern und Performancekennzahlen. Entscheidend ist, wie weit diese Inhalte tatsächlich reichende Schlussfolgerungen stützen.
Manche erstaunlichen Ergebnisse lassen sich reproduzieren, sind aber noch weit von einem stabilen Vorteil entfernt. Manche Strategien haben durchaus einen Wert, sind jedoch nicht so magisch, wie sie dargestellt werden. Manche Codefehler reichen aus, um die ursprüngliche Validierung infrage zu stellen; bei anderen lässt sich ihre Auswirkung erst nach einer Neuberechnung bestimmen.
Wir wollen genau diese Unterschiede so klar wie möglich herausarbeiten.
In der ersten Phase entstanden sechs Artikel und ein durch konkrete Fälle erprobtes Regelwerk. Dieses muss in späteren Untersuchungen weiterentwickelt werden, bietet aber bereits eine ausreichende Grundlage für die nächste Phase.
Der Wert eines Quant-Audits hängt letztlich davon ab, ob wir die Schlussfolgerungen durch die Belege begrenzen lassen können.
Wo der nächste Beitrag ansetzt, entscheiden wir, sobald sich die nächste überprüfungswürdige Frage ergibt.