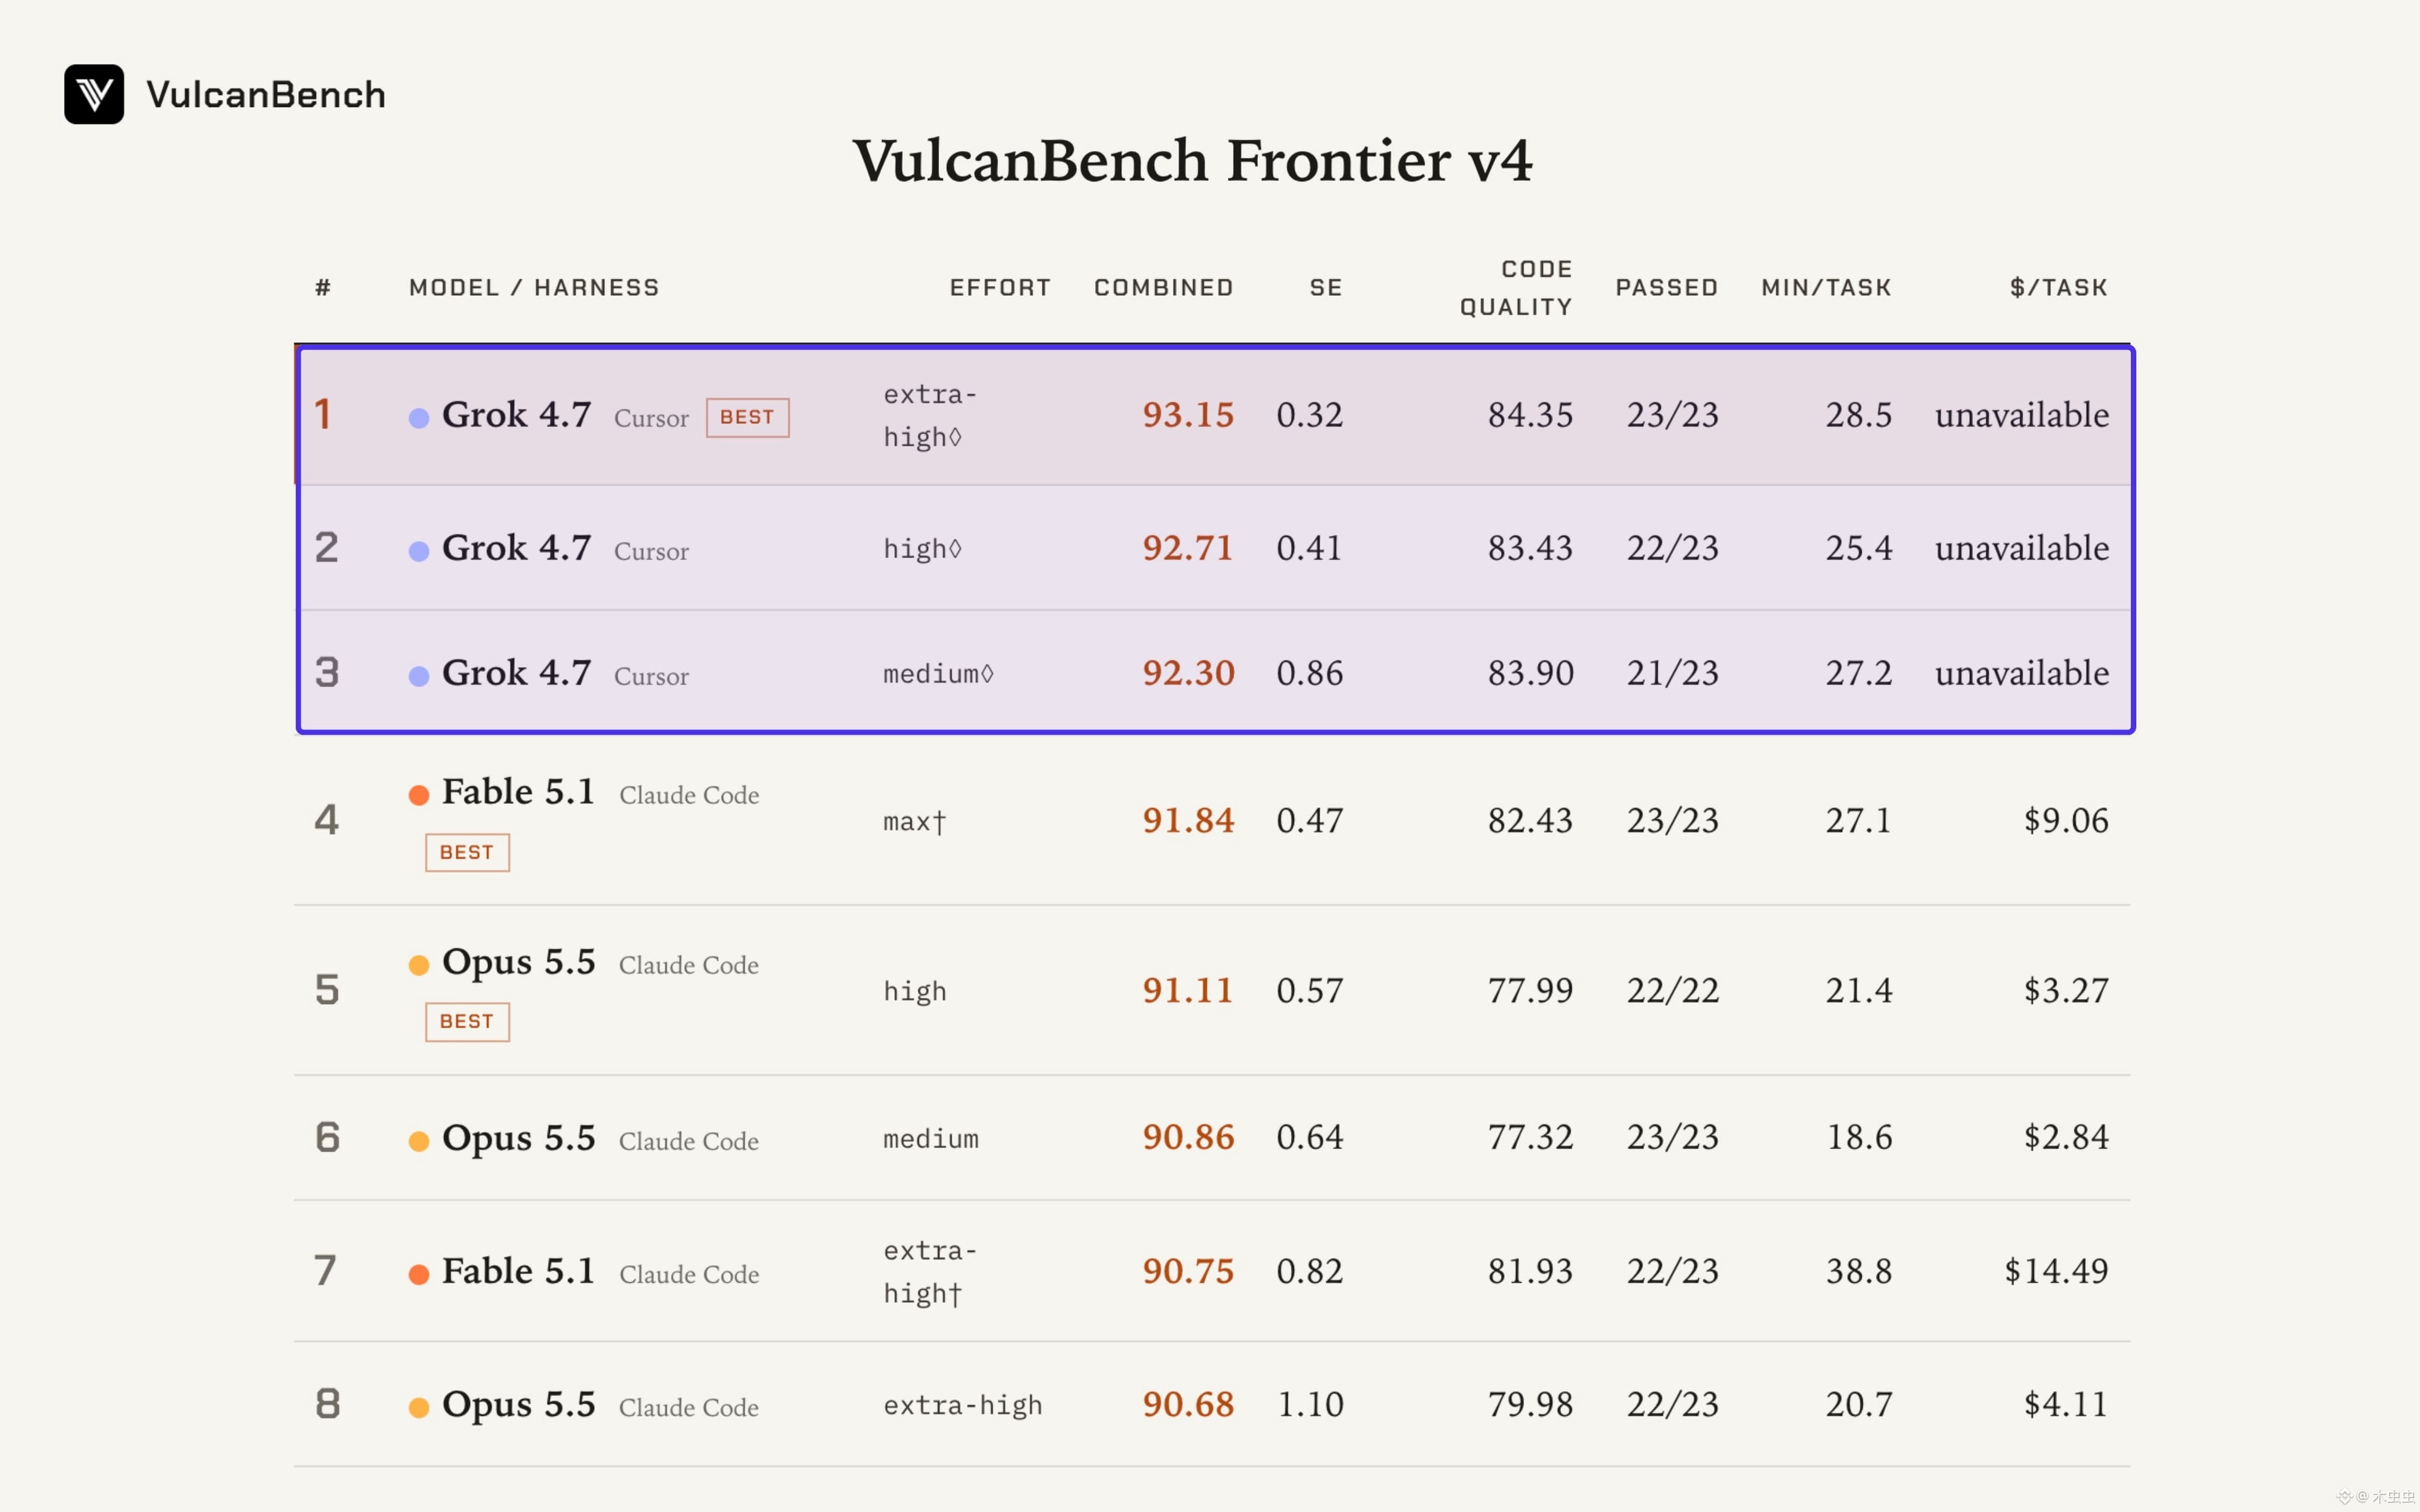
Grok 4.7 belegt die TOP-3-Plätze auf VulcanBench Frontier v4 und übertrifft Fable 5.1, Opus 5.5, GPT-6 Astra, GPT-6.1 Sol und andere führende Frontier-Modelle
• Grok 4.7 xHigh – 93.15
• Grok 4.7 High – 92.71
• Grok 4.7 Medium – 92.30
VulcanBench Frontier v4 testet, ob KI-Modelle anspruchsvolle Softwareentwicklungsaufgaben auf Repository-Ebene bewältigen können, statt lediglich einzelne Code-Schnipsel zu generieren.
Der Benchmark umfasst 23 Aufgaben zur Verhaltensrekonstruktion. Dabei müssen Modelle Legacy-Software so nachbilden, dass sie sich genauso verhält wie das Original. Die funktionale Korrektheit wird mithilfe verborgener Tests geprüft – ebenso wie Sicherheit, Linting/Komplexität und Codequalität.
Auch die Ergebnisse bei den Aufgaben sind beeindruckend:
• Grok 4.7 xHigh – 23/23 bestanden
• Grok 4.7 High – 22/23 bestanden
• Grok 4.7 Medium – 21/23 bestanden
Grok 4.7 belegte die Plätze #1, #2 und #3