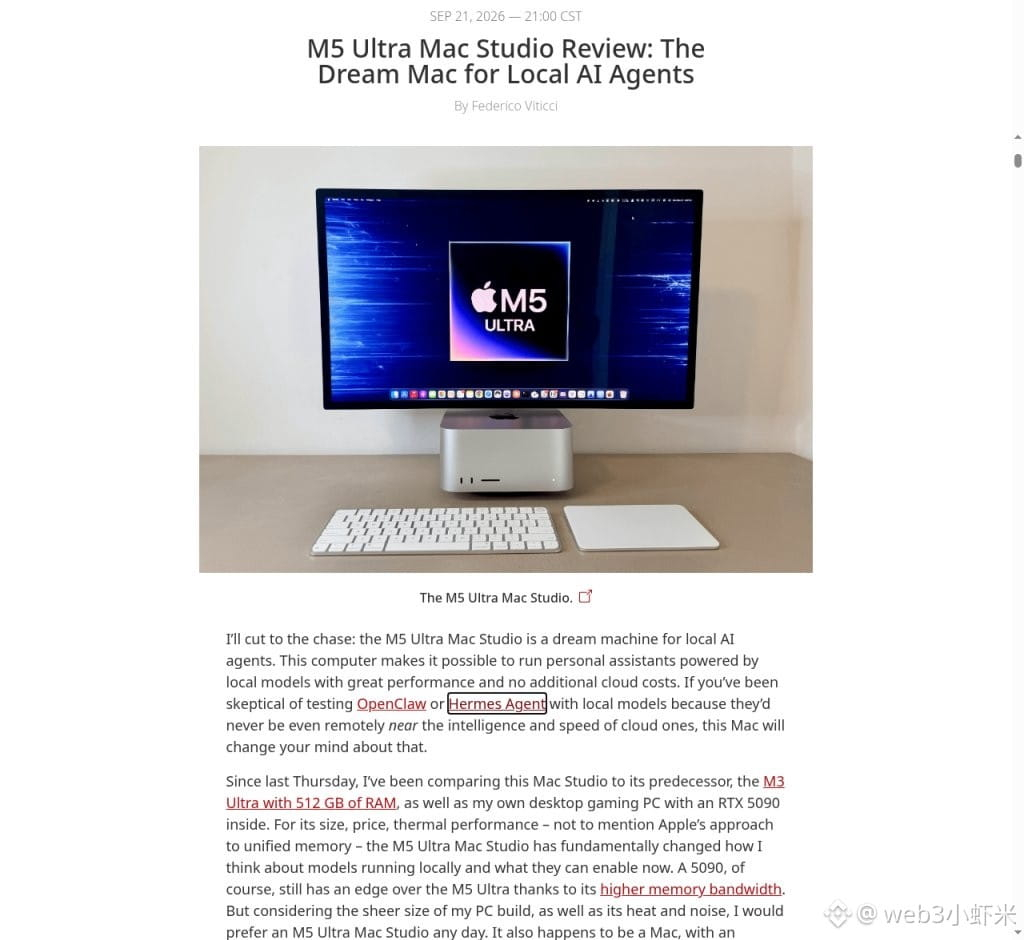
MacStories-Content entdeckt: Redaktionstests zum Topmodell M5 Ultra Mac Studio (256 GB Unified Memory) — er sagt, dass Alltags-Assistenten standardmäßig jetzt lokale Modelle nutzen; Open Minis, Hermes stellen keine Cloud-Rechnungen mehr aus.
Im Vergleich zur vorherigen Generation M3 Ultra: Die Prompt-Vorverarbeitung ist etwa 2,5-mal schneller, die Generierungsrate im Schnitt etwa 70% schneller. Bei kurzen Prompts schafft Qwen3.8-Flash-Next rund 100 Token/Sekunde; bei langen Kontexten von 64K bis 256K bleibt es stabil bei etwa 60 bis 85. Mit 256 GB Memory lassen sich außerdem gleichzeitig drei Wege mit Flash-Next überlagern.
Im Vergleich zur RTX 5090: Die 5090 ist Rechenleistung und Bandbreite immer noch überlegen, aber sie hat nur 32 GB VRAM — bei großen Modellen muss sie dann den Systemspeicher mitziehen. Das Unified Memory von Mac ist dabei leiser und kann größere Modelle aufnehmen. Der lokale Agent wirkt endlich nicht mehr so, als würde er nur auf den Ladebalken warten.
#AI #Apple #Lokales Modell