#CerebrasSinksNearly20%OnReportNvidiaToPowerOpenAI
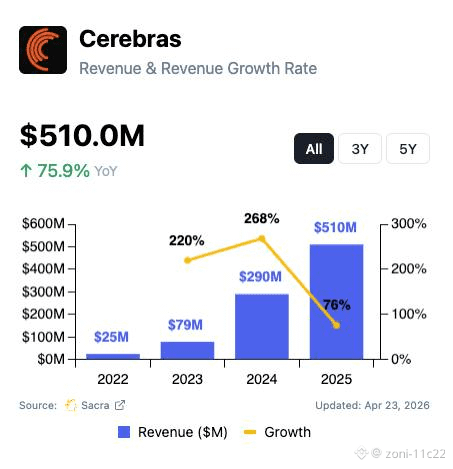
Die Aktie von Cerebras Systems (CBRS) ist in dieser Woche um fast 20 % eingebrochen und hat damit ihren tiefsten Stand seit ihrem umfangreichen Börsengang erreicht. [1, 2]
Der starke Rückgang folgt auf einen viralen Bericht des Halbleiter-Forschungsunternehmens SemiAnalysis auf X. Darin heißt es, dass OpenAI für den neuen „Ultrafast“-Modus seines Flaggschiff-Modells GPT-6.1 Sol statt auf Cerebras-Hardware auf Nvidia-GPUs setzt. [1, 2]
Die zentrale Bedrohung für Cerebras
Verlust der wichtigsten Auslastung: OpenAI ist für Cerebras gemessen am Umsatzrückstand der größte Kunde. Die beiden Unternehmen hatten zuvor angedeutet, dass die kundenspezifischen Wafer-Scale-Engine-Chips von Cerebras diese spezielle Echtzeit-Inferenzschicht antreiben würden. [1, 2]
Nvidias versteckter Vorteil: Herkömmliche Nvidia-GPUs benötigen in der Regel große Batch-Größen, um effizient zu laufen. SemiAnalysis berichtete jedoch, dass OpenAI Nvidias Chips erfolgreich so optimiert hat, dass GPT-6.1 Sol nativ in einer „low batch size“ läuft. Das untergräbt direkt den zentralen Verkaufsargument von Cerebras: Ultra-Low-Latency-Inferenz. [1, 2, 3]
$HUMA
$GSB
$QKC