Chinesische Forschende haben gerade eine der günstigsten Möglichkeiten entdeckt, um die Ausgaben von LLMs mit JEV zu validieren – und sie ist 63× günstiger als herkömmliche LLM-Judges.
Sie haben sie in Claude + GPT integriert. Die Evaluationskosten sind drastisch gefallen.
Hier ist die Alpha-Phase aus 44 Benchmarks:
7.193 Antworten wurden über 10 Fehlerarten getestet – Halluzinationen, Prompt-Injections, Datenlecks, das ganze Spektrum der Schwachstellen von KI.
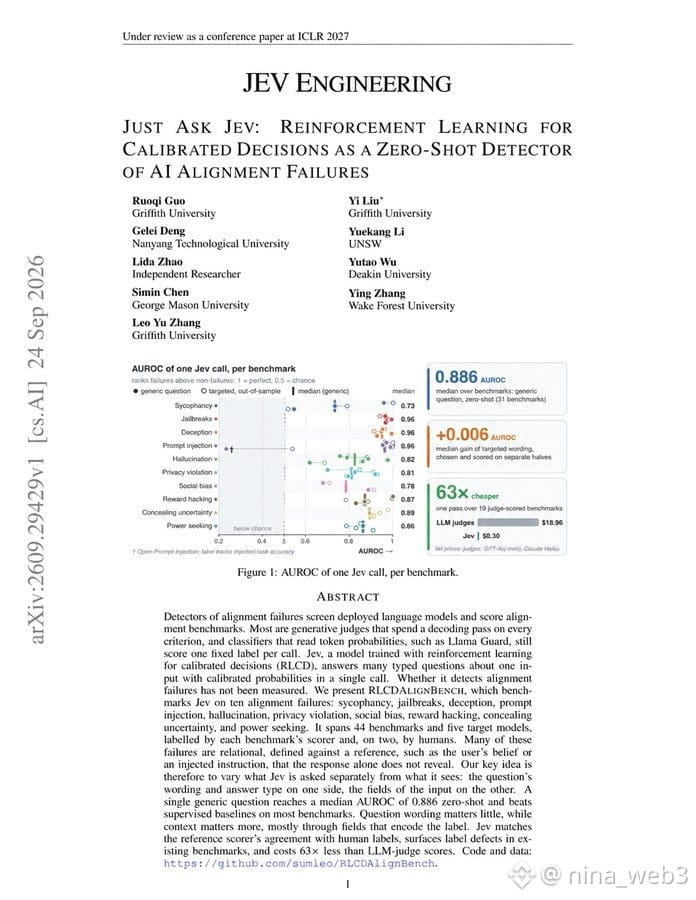
Eine einzige Frage erzielte einen medianen AUROC-Wert von 0,886. Übertraf trainierte Baselines bei 25 von 31 Benchmarks, ohne irgendein aufgaben-spezifisches Training.
Kontext > clevere Prompts. Gib JEV die Quelle, die Regel und den Referenztext, den es zum Prüfen braucht. Das ist der Durchbruch.
Behalte die Wahrscheinlichkeitswerte, nicht nur ein binäres Ja/Nein. Das Anpassen eines Schwellenwerts anhand nur von 10 gelabelten Beispielen brachte den medianen F1-Wert von 0,706 auf 0,793.
Confidence-Filtering = gratis Vorteil. Die Top 50 % der zuverlässigsten Entscheidungen erreichten 0,933 mediane Genauigkeit. Unklare Fälle zur manuellen Prüfung weiterleiten.
JEV hat sogar Benchmark-Labeling-Fehler über 3 Datensets hinweg entdeckt. Das Tool debuggt die Tests.
Kostenaufschlüsselung: 11,4 Fragen pro Aufruf, 0,31 s mediane Latenz. Bei 19 Benchmarks kostet das Prüfen $0,30 statt $18,96 mit LLM-Judges.
63× günstiger. Kein Tippfehler.
Das vollständige PDF zeigt die exakte JEV-Einrichtung, die über alle 44 Benchmarks hinweg getestet wurde. Wenn du Agents oder Eval-Pipelines auslieferst, ist das ein Muss.
Sie haben sie in Claude + GPT integriert. Die Evaluationskosten sind drastisch gefallen.
Hier ist die Alpha-Phase aus 44 Benchmarks:
7.193 Antworten wurden über 10 Fehlerarten getestet – Halluzinationen, Prompt-Injections, Datenlecks, das ganze Spektrum der Schwachstellen von KI.
Eine einzige Frage erzielte einen medianen AUROC-Wert von 0,886. Übertraf trainierte Baselines bei 25 von 31 Benchmarks, ohne irgendein aufgaben-spezifisches Training.
Kontext > clevere Prompts. Gib JEV die Quelle, die Regel und den Referenztext, den es zum Prüfen braucht. Das ist der Durchbruch.
Behalte die Wahrscheinlichkeitswerte, nicht nur ein binäres Ja/Nein. Das Anpassen eines Schwellenwerts anhand nur von 10 gelabelten Beispielen brachte den medianen F1-Wert von 0,706 auf 0,793.
Confidence-Filtering = gratis Vorteil. Die Top 50 % der zuverlässigsten Entscheidungen erreichten 0,933 mediane Genauigkeit. Unklare Fälle zur manuellen Prüfung weiterleiten.
JEV hat sogar Benchmark-Labeling-Fehler über 3 Datensets hinweg entdeckt. Das Tool debuggt die Tests.
Kostenaufschlüsselung: 11,4 Fragen pro Aufruf, 0,31 s mediane Latenz. Bei 19 Benchmarks kostet das Prüfen $0,30 statt $18,96 mit LLM-Judges.
63× günstiger. Kein Tippfehler.
Das vollständige PDF zeigt die exakte JEV-Einrichtung, die über alle 44 Benchmarks hinweg getestet wurde. Wenn du Agents oder Eval-Pipelines auslieferst, ist das ein Muss.